ARTICLE · 1358641
AI 读不懂 PDF?这个微软开源工具有点狠
手上的资料大多是 PDF、Word、Excel,模型读起来并不顺。
PDF 是给人看的格式,里面存着字体、坐标、图层,一段完整的话可能被拆成几十个文本块。直接把它丢进上下文,一半以上的 token(模型按量计费的单位)花在版式描述上,真正的内容只占小头。表格更容易出事,行列关系一散,模型就会把「第三季度」和「华东区」对到别的格子里。
MarkItDown 是微软开源的一个转换工具,把这些文件转成 Markdown 再喂给模型。Markdown 用最少的标记保留结构,标题、表格、列表都在,版式噪声被清掉。同一份 50 页的财报,转完的文件通常只剩原来的十分之一不到,token 跟着降下来。
安装方式
要求 Python 3.10 以上,装之前先 python --version 看一眼。版本不够的去 python.org 下载新版,Windows 安装时记得勾「Add Python to PATH」,不然命令行找不到 python。
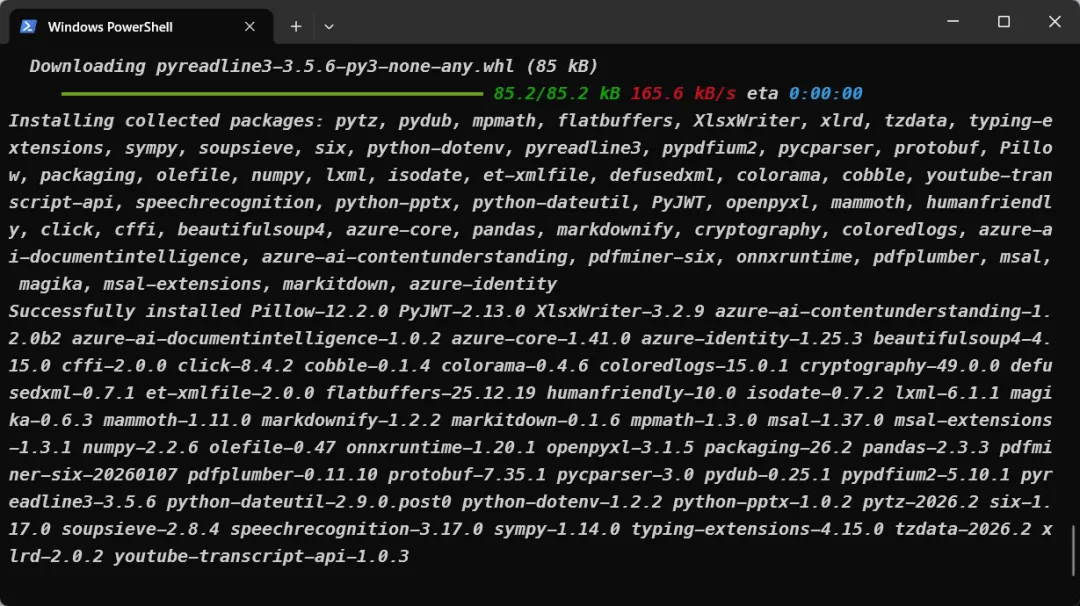
pip install "markitdown[all]"
方括号里的 all 表示装齐所有格式的依赖,国内网络下十几分钟属于正常。想快一点就加清华源:
pip install "markitdown[all]" -i https://pypi.tuna.tsinghua.edu.cn/simple
只处理 PDF、Word、Excel 的话,pip install "markitdown[pdf,docx,xlsx]" 就够,体积小很多。装完执行 markitdown --help,能出参数列表就正常。
如果提示「不是内部或外部命令」,是 Python 的 Scripts 目录没进环境变量:找到 Python 安装目录下的 Scripts 文件夹,把它加到 PATH 里,重开终端再试。
转换用法
在文件所在目录打开终端:
markitdown 财报.pdf -o 财报.md
-o 指定输出文件。也可以省掉它用重定向,但 Windows 的 PowerShell 5.1 会用 UTF-16 编码写文件,生成的 md 在 VS Code 里打开全是乱码,喂给模型也读不了。所以 Windows 下一律用 -o。
一个目录里几十份文件,用循环批量转。PowerShell:
Get-ChildItem *.pdf | ForEach-Object { markitdown $_.FullName -o ($_.BaseName + ".md") }
macOS 和 Linux:
for f in *.pdf; do markitdown "$f" -o "${f%.pdf}.md"; done
输出文件和源文件同目录,只换了扩展名,目录里已经有同名 md 的会被直接盖掉。
转出来的文件打开是这样的:标题变成一级二级标题,段落之间空行分开,表格变成竖线分隔的行,页码和页眉这类重复内容基本被清掉,剩下的内容模型直接就能读。
接到 Claude Code
命令行已经够用,配合 Claude Code 更省事。把它注册成 MCP 服务,AI 就能自己调用转换工具读文件。MCP 是模型上下文协议,第 2 篇的 Chrome DevTools 走的是同一套机制。
先确认有 uvx(uvx --version),没有就 pip install uv。然后注册:
claude mcp add --transport stdio markitdown -- uvx markitdown-mcp
中间那两个短横线不能省,它把注册参数和启动命令分开。claude mcp list 看到 markitdown 后面是 ✓ Connected 就成了。
用法就是正常说话:
把 D:\资料\行业报告.pdf 转成 markdown,找出里面提到市场规模的三个数字
这个服务只暴露一个工具 convert_to_markdown,参数也只有一个文件地址。它不支持挂多模态模型看图、不支持插件、也不支持 Azure 文档智能。要这些功能只能写 Python 脚本,用 MarkItDown(llm_client=client, llm_model=...) 挂一个兼容 OpenAI 接口的模型,把 PDF 里的图表转成文字描述。只在处理满是图表的报告时才值得开。
用不上的情况
扫描版 PDF 没有文字层,转出来是空文件,得另配 OCR 插件。先 markitdown --list-plugins 看装了哪些,再用 --use-plugins 启用,转完抽查几页。
双栏排版的论文容易左右串行,数学公式转出来是乱码,流程图只剩一行图片标记。它适合文字为主的报告、合同、说明书,不适合当排版还原工具。
几百页的 PDF 转完依然超上下文,这不是格式问题,只能按章节拆开喂。
如果这篇文章对你有帮助,点个「赞」和「在看」,再顺手关注一下——
我是 shining,一个爱折腾的技术宅,咱们下期见。
❝💬 互动话题:你手上最难转的是哪类文档?评论区说说。