ARTICLE · 1366866
Vue3 导入导出 Excel 进阶:流式解析与错误行回写
范围:补的是哪一段
先把不做的划掉:模板下载、字段预校验、页面内错误行回显、CSV 与 xlsx 的导出语义、长数字与日期的格式坑,这些基础链路里已经覆盖,这里不重复。这一节只解决三件事:大文件读的时候页面不卡、进度能看见、错误能带走。
三件事对应三个技术判断,顺序不能换。第一个判断是「文件能不能切开」,它决定了后面所有分批方案的形态;第二个判断是「浏览器端到底有没有流式」,它决定了该选哪个能力面;第三个判断是「错误交给谁」,它决定了回写文件的结构。下面按这个顺序展开。
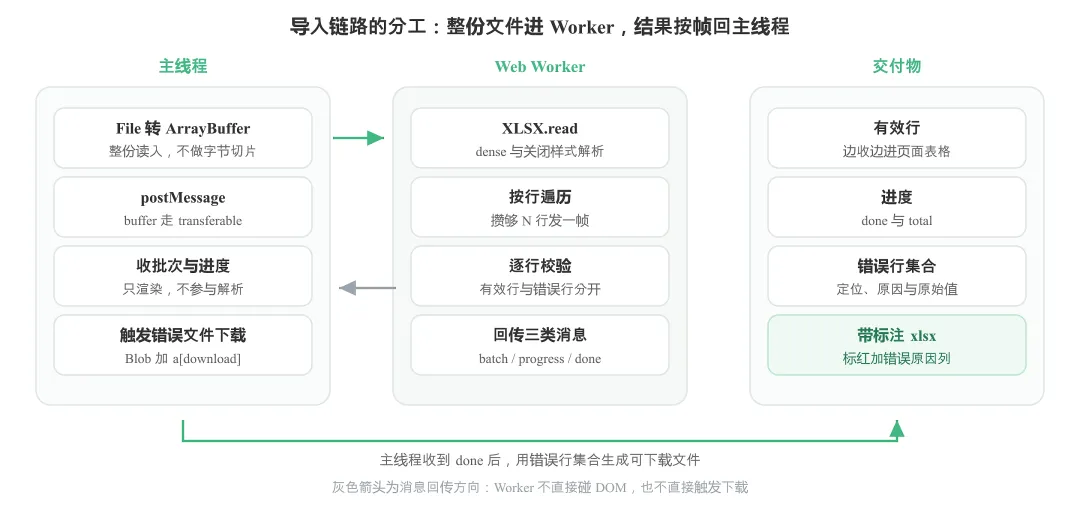
整条链路的分工:只有 Worker 做解析,主线程负责交互与交付
先看清 xlsx 是什么:按字节切片不成立
「文件大就切块」是第一个容易走岔的念头。File.prototype.slice() 确实能按字节切出 Blob,但 xlsx 是一个 ZIP 容器:内部是压缩过的一组 XML,而记录「有哪些文件、各自在哪」的中央目录写在文件尾部。按字节切出来的任何一段都不是合法 ZIP,解压器连入口都找不到,更谈不上解析出某一批行。
所以这里的「分批」要换个定义:整份读入、分批产出。读入是一次性的,分的是解析结果回传的节奏,不是文件的字节。这一条决定了后面 Worker 里只能有一个完整 ArrayBuffer,也决定了「流式」这个词在这篇里的准确含义——不是字面意义上的流式 IO,而是「解析不占主线程」加「产出按帧回传」两件事的组合。
浏览器端到底有没有流式:按官方口径对齐
三个常被混为一谈的能力面,先分开:ExcelJS 的 streaming、SheetJS 的读取选项、以及「交给服务端」这条退路。
| workbook.xlsx.load(buffer) | ||
| XLSX.read(data, opts) | ||
结论不复杂:浏览器侧要的不是「流式解析」这个名头,而是把整读的代价从主线程挪走、把内存压到能接受的范围。dense: true 值得单独说一句——它让单元格以二维数组存放,取值方式从稀疏模式的 ws['B2'] 变成 ws['!data'][R][C](行列都是零基),遍历前还要先判 ws['!data'] 是否存在。这是官方给的迁移写法,也是照着旧示例抄最容易错的一处。
把解析搬进 Worker:转移所有权而不是复制
Web Worker 是独立于主线程的 JS 执行环境,解析这种同步重活放进去,主线程就不会被长任务卡住。Vite 下用 new URL('../workers/excel.worker.js', import.meta.url) 配 { type: 'module' } 创建,构建时会把 Worker 单独打成一个 chunk。
关键在 postMessage 的第二个参数。默认情况下消息走结构化克隆,一个几十 MB 的 ArrayBuffer 会被完整复制一份,内存里同时存在两份;把它列进可转移对象(transferable)清单后,交出去的是所有权,零拷贝——不产生第二份数据,转移完成后主线程上这个 buffer 变为不可用状态,别再拿它做别的。
// src/composables/useExcelImport.jsexport function createWorker() {return new Worker(new URL('../workers/excel.worker.js', import.meta.url),{ type: 'module' })}let worker = createWorker()let running = falseexport function onWorkerMessage(handlers) {worker.onmessage = (e) => {const { type, payload } = e.dataif (type === 'batch') handlers.onBatch(payload.rows)if (type === 'progress') handlers.onProgress(payload.done, payload.total)if (type === 'done') handlers.onDone(payload)}}export async function parseFile(file) {const buffer = await file.arrayBuffer() // 整份读入,不切片worker.postMessage({ type: 'parse', buffer, batchSize: 500 },[buffer] // transferable,零拷贝转交所有权)// 转移之后主线程上的 buffer 已不可读,别再复用它}
消息协议先定死三类:batch 带一批有效行、progress 带已完成与总数、done 带错误行集合并标记结束。协议简单一点,后面取消与重建 Worker 时心智负担小很多。
分批产出:按行分帧,进度与数据分两条消息
分帧指每攒够 N 条有效行发一次 batch,而不是每解析一行就发一条消息。消息太密,跨线程通信本身会变成新瓶颈;N 取 500 起步,按目标机型的实际耗时调。进度单独发,这样界面可以只更新一个数字,不必把整批行数据绑在进度上。
// src/workers/excel.worker.jsimport * as XLSX from 'xlsx'import { SCHEMA, validateRow, collectErrors } from '../lib/validate.js'function pickRow(ws, r, range) {const data = ws['!data'] // dense 模式:ws['!data'][r][c]const line = data ? (data[r] || []) : []const out = []for (let c = range.s.c; c <= range.e.c; c++) {const cell = line[c]out.push(cell ? cell.v : null)}return out}self.onmessage = (e) => {const { buffer, batchSize = 500 } = e.dataconst wb = XLSX.read(new Uint8Array(buffer), {type: 'array',dense: true, // 单元格存进 ws['!data'] 二维数组cellStyles: false, // 不解析样式cellFormula: false // 不保留公式文本})const ws = wb.Sheets[wb.SheetNames[0]]const range = XLSX.utils.decode_range(ws['!ref'] || 'A1')const total = range.e.r - range.s.r // 去掉表头后的数据行数const allErrors = []let rows = []let done = 0for (let r = range.s.r + 1; r <= range.e.r; r++) { // +1 跳过表头const values = pickRow(ws, r, range)const errs = validateRow(values, SCHEMA, r + 1) // 传 1 基行号allErrors.push(...errs)if (errs.length === 0) rows.push(values) // 只把通过的行放进批次done++if (rows.length >= batchSize) {self.postMessage({ type: 'batch', payload: { rows } })rows = []}if (done % batchSize === 0) {self.postMessage({ type: 'progress', payload: { done, total } })}}if (rows.length) self.postMessage({ type: 'batch', payload: { rows } })self.postMessage({ type: 'done', payload: collectErrors(allErrors) })}
这段骨架只取第一个工作表,从第二行起遍历以跳过表头;校验在 Worker 内完成,只有全列通过的行才进 batch,错误行进 allErrors。校验规则要放在 Worker 能直接 import 的模块里,别通过 postMessage 传——结构化克隆不接受函数,带 test 函数的规则对象会直接抛出克隆错误,这是把校验搬进 Worker 时第一个会撞上的坑。
pickRow 返回的是原始值数组,长数字与日期的格式问题在基础链路里已经处理过,这里沿用同一套规范化函数,不要在 Worker 里再写一份。进度按 done 的整数倍发,与批次解耦:错误多的文件里有效行攒得慢,进度不该跟着停住。
校验:错误行的数据契约
错误行的数据契约要瘦。把整行原始数据塞进错误对象,几万行里错几千行就等于又复制了一份表;固定只留定位字段、原因,外加出错单元格的原始值——用户对照时唯一需要看到的就是这个值,别把整行搬过来。行号列号用 1 基,和用户对着 Excel 看到的一致,别让人做减一换算。
// src/lib/validate.jsexport const SCHEMA = [{ label: '姓名', required: true },{ label: '手机号', required: true, test: (v) => /^\d{11}$/.test(String(v)) }]function makeError(row, col, code, message, raw) {return { row, col, code, message, raw } // 行号列号 1 基,与 Excel 一致}export function validateRow(values, schema, lineNo) {const errors = []schema.forEach((rule, i) => {const v = values[i]if (rule.required && (v === null || v === '')) {errors.push(makeError(lineNo, i + 1, 'REQUIRED', `${rule.label} 不能为空`, v))}if (v !== null && rule.test && !rule.test(v)) {errors.push(makeError(lineNo, i + 1, 'FORMAT', `${rule.label} 格式不对`, v))}})return errors}export function collectErrors(all, limit = 500) {// 错误数据本身也可能撑爆内存,超出上限只记总数if (all.length <= limit) return { errors: all, truncated: false, total: all.length }return { errors: all.slice(0, limit), truncated: true, total: all.length }}
truncated 这一个布尔值必须往上传,否则用户会以为下载的文件里就是全部错误。它属于「不静默丢数据」的基本约束,比多存几百行重要。
错误行回写:生成一份带标注的 xlsx
页面内回显表格适合错误少的时候,一眼能看完;错误行成千上万条,页面表格既翻不动也带不走。回写文件是另一种交付:把错误行连同原因写成新工作簿,用户下载、在原文件里改、再上传,形成闭环,不需要在页面上抄行号。
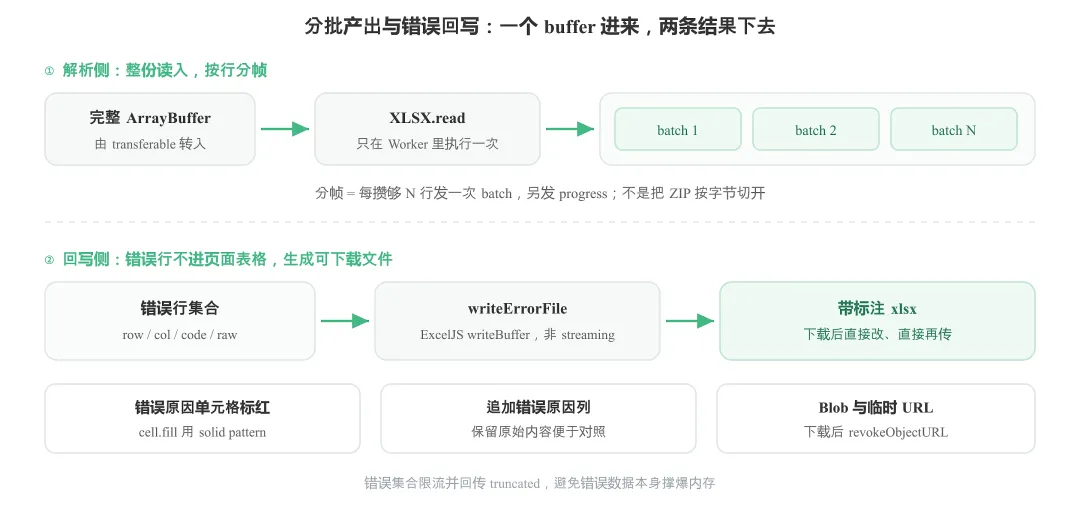
分批产出与错误回写:一个 buffer 进来,有效行与错误文件两条结果下去
浏览器端 ExcelJS 用 writeBuffer() 生成文件内容,配 cell.fill 给错误原因上底色,再走 Blob 加临时 URL 触发下载。这里的 cell.fill 是样式写入,和前面「解析时不读样式」不冲突:读入侧省掉的是对源文件的样式解析,写出侧是自己新建工作簿时设的填充。
// src/lib/writeErrorFile.jsimport ExcelJS from 'exceljs'export async function writeErrorFile(errors, fileName = '错误行.xlsx') {const wb = new ExcelJS.Workbook()const ws = wb.addWorksheet('错误数据')ws.addRow(['原行号', '列号', '错误码', '错误原因', '原始内容'])errors.forEach((err) => {ws.addRow([err.row,err.col,err.code,err.message,String(err.raw ?? '') // 原值随错误行一起带过来])})const red = { type: 'pattern', pattern: 'solid', fgColor: { argb: 'FFFFC7CE' } }ws.eachRow((row, rowNumber) => {if (rowNumber === 1) returnrow.getCell(4).fill = red // 错误原因列标红})ws.getColumn(1).width = 12ws.getColumn(4).width = 40ws.getColumn(5).width = 30const buf = await wb.xlsx.writeBuffer() // 浏览器端可用;非 streamingconst url = URL.createObjectURL(new Blob([buf], {type: 'application/vnd.openxmlformats-officedocument.spreadsheetml.sheet'}))const a = document.createElement('a')a.href = urla.download = fileNamea.click()URL.revokeObjectURL(url)}
「原始内容」这一列别省。用户拿到文件时要对照自己填了什么,只有行号和一句「格式不对」还得切回原表,闭环就断了。取值用错误对象自带的 raw,不要拿 err.row 去页面表格里回查——页面里存的是过滤后的有效行,行号早就对不上了。
取消、并发与内存:四条提前定好的规则
Worker 没有「中断当前同步任务」的 API,解析一旦开始,唯一可靠的取消是 terminate(),然后重建实例。重建这一步不能省:旧实例如果还挂着消息回调,状态会被残留消息污染。
// 取消 = 终止后重建,同时清掉已收的批次、进度与错误集合export function cancelImport(resetState) {worker.terminate()worker = createWorker()resetState()running = false}// 同一时刻只允许一个导入在跑,避免两次 postMessage 的消息互相串export async function start(file, handlers) {if (running) returnrunning = trueonWorkerMessage({onBatch: handlers.onBatch,onProgress: handlers.onProgress,onDone(payload) {running = false // 解析真的结束才解锁handlers.onDone(payload)}})try {await parseFile(file) // 只是投递消息,很快返回} catch (e) {running = falsethrow e}}
这里的锁最容易写错成「await parseFile(file) 之后就解锁」。postMessage 是异步投递,消息发出去不等于解析结束,锁必须在收到 done 时才放开,否则连选两次文件,两批 batch 消息会混进同一张表。
另外两条规则写在这里,实现时容易漏:buffer 转移后不可复用,取消后要重来就得重新 file.arrayBuffer();错误集合要限流,并回传 truncated。至于「多大的文件该改走服务端」,不给一个凭空写下的数字——按目标机型的实测内存与耗时定阈值,浏览器侧至少要把「内存里同时存在完整 buffer 与解析结果」这个事实算进去。
串起来:把界面层做薄
组件层薄一点更好维护:选文件、收批次、更新进度、触发错误文件下载,外加一个取消入口。解析、校验、回写都在各自的模块里,界面不碰 ArrayBuffer,也不碰 ZIP。
<script setup>import { ref } from 'vue'import { start, cancelImport } from './useExcelImport'import { writeErrorFile } from './writeErrorFile'const rows = ref([])const errors = ref([])const progress = ref({ done: 0, total: 0 })const truncated = ref(false)const handlers = {onBatch(list) { rows.value.push(...list) },onProgress(done, total) { progress.value = { done, total } },onDone(payload) {errors.value = payload.errorstruncated.value = payload.truncated}}async function onFileChange(e) {const file = e.target.files?.[0]if (!file) returnrows.value = []errors.value = []await start(file, handlers)}function onDownload() {const name = truncated.value ? '错误行(前500条).xlsx' : '错误行.xlsx'return writeErrorFile(errors.value, name)}function onCancel() {cancelImport(() => {rows.value = []errors.value = []progress.value = { done: 0, total: 0 }})}</script>
下载入口就是按钮绑 onDownload,挂在 done 之后,别在回调里自动弹下载:用户可能想先在页面里看一眼错误分布,自动下载会打断这个动作。被截断时文件名直接写明「前 500 条」,比在页面角落加一行小字更不容易被忽略。
收尾:能力边界与适用条件
把没做的列清楚,比补一段乐观的总结有用。以下均不在这套骨架范围内:
回头看,这套设计真正解决的只有两件事:把整读的代价挪出主线程,把错误从「页面上的一行提示」变成「能带走的一份文件」。前者靠 Worker 与所有权转移,后者靠错误行的数据契约与回写。至于文件大到浏览器扛不住,判断依据应该来自实测,而不是给「大」字配一个想当然的数字。
· · ·
觉得有用的话,点赞、分享、推荐三连支持一下。