ARTICLE · 1387335
JVM 参数模板:7 行经典配置,我全删了
上周有同事从老项目搬来一份启动脚本,JVM 参数那段十六行,注释写着「2018 版,勿动」。
贴到 JDK 21 上,服务没起来。
Unrecognized VM option 'MaxPermSize=256m'Error: Could not create the Java Virtual Machine.删掉这行再起,又是:
Unrecognized VM option 'UseConcMarkSweepGC'Error: Could not create the Java Virtual Machine.十六行里有两行能让 JVM 根本启动不了,还有一行不报错也不生效,你以为它在干活,其实它早就退场了。
那天下午我们把这份脚本删到九行。删掉的比留下的更值得写:留下的九行,每一行都能说清楚它在解决什么问题;删掉的七行,多数人的启动脚本里还躺着。
一、先说结论:我们线上就这九行
-Xms8g-Xmx8g-XX:MaxMetaspaceSize=512m-XX:+HeapDumpOnOutOfMemoryError-XX:HeapDumpPath=/data/dump-XX:+ExitOnOutOfMemoryError-XX:ErrorFile=/data/dump/hs_err_%p.log-Xlog:gc*:file=/data/log/gc.log:time,uptime,level,tags:filecount=10,filesize=50m-Duser.timezone=Asia/Shanghai九行,九个参数。没有 -XX:+UseG1GC,没有 -Xmn,没有 -XX:+PrintGCDetails,没有任何一行的理由是「别人都这么写」。
拆开看:堆两行、元空间一行、出事的证据四行、日志一行,最后一行时区不属于调优,属于保命(容器里默认 UTC,日志时间对不上,排查时先花半小时对表)。
你可能会问,GC 那些旋钮呢?一个都没有。停顿目标这种东西得按业务定,抄不了,抄错了比不写还糟。那块怎么调,之前那篇 G1 调优写过了,这里只保留结论:默认 200ms 能用就先别动。
二、参数只有三种,判断标准就一句话
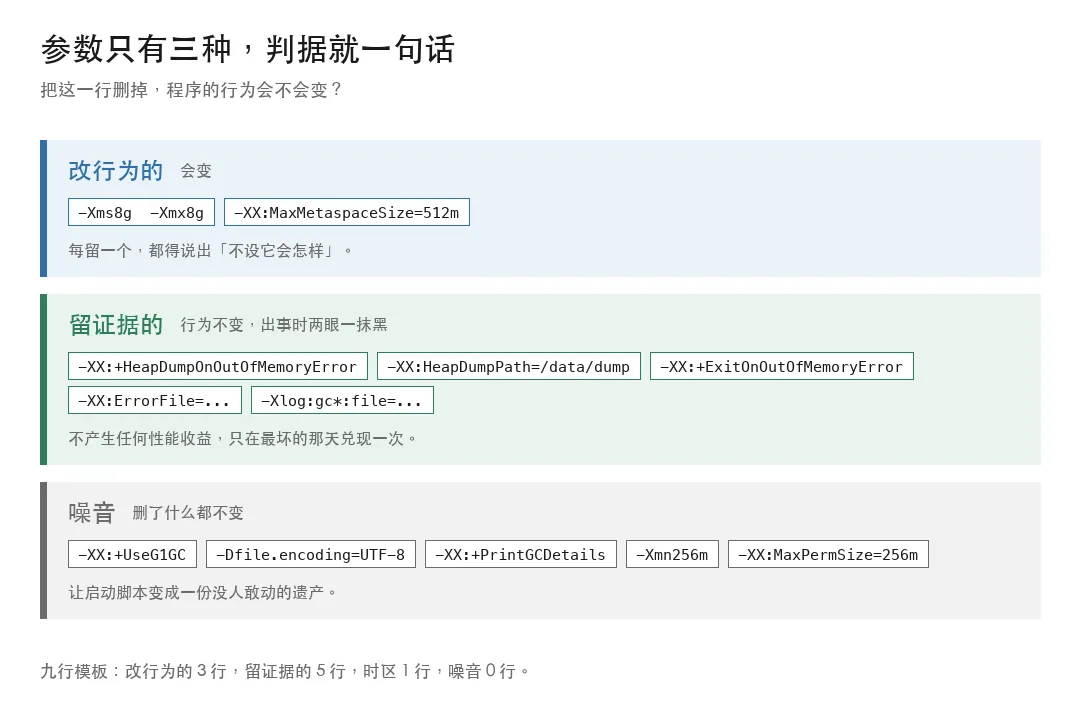
我判断一行参数该不该留,只问一句:把它删掉,程序的行为会不会变?
按这个标准,参数分三类。
第一类,改行为的。 删了它就报错、就 OOM、就跑得不一样。-Xmx 删掉,堆从 8G 变成物理内存的四分之一;-XX:MaxMetaspaceSize 删掉,元空间没有上限,泄漏的时候先耗尽的是机器内存。这类必须留,但每留一个,你得说得出「不设它会怎样」。
第二类,留证据的。 删了它,程序跑起来一模一样,出事的时候你两眼一抹黑。dump、退出码、错误日志,全是这一类。它们不产生任何性能收益,只在最坏的那天救你一次。
第三类,噪音。 删了它,行为不变,证据也不少。-XX:+UseG1GC 在 JDK 21 上就是噪音,因为默认回收器已经是 G1;-Dfile.encoding=UTF-8 也是,JDK 18 起默认编码就是 UTF-8。
噪音不是无害。它让启动脚本变成一份没人敢动的遗产,更实际的问题是:下次排查时,你得先花时间确认这行到底生效没有。 我见过一份脚本里 -XX:MaxPermSize 和 -XX:MaxMetaspaceSize 并排躺着,两个都写着 512m,改的人以为自己在调元空间。
三、堆:不写 -Xmx 时,JVM 给你多少
这台机器 16G 内存。我把默认值全读出来:
-XX:MaxRAMPercentage=50 | ||
-Xmx4g |
三个数值得记住。
上限默认是物理内存的四分之一。 靠的是 MaxRAMPercentage 默认 25。16G 的机器给 4G,64G 的机器给 16G。这个比例在物理机上勉强够用,在容器里必须显式指定,因为容器看到的「物理内存」取决于有没有开容器感知,那是另一篇的事,这里只记住结论:容器里别依赖默认值。
初始堆默认是物理内存的六十四分之一,256M。 关键在第三行:你写了 -Xmx4g,初始堆还是 256M。-Xmx 只管天花板,不管起步。
所以那些只写 -Xmx 的服务,启动那一刻堆只有 256M,然后随着流量一路涨上去。涨的过程要 commit 内存,要跟操作系统要页,这段路是启动后最不稳的一段。
想让它一开始就是最终大小,必须写 -Xms,并且跟 -Xmx 相等。
这件事常被说成「减少 GC 次数」,不准确。-Xms 等于 -Xmx 主要解决两件事:一是不用在运行期反复扩缩容(缩容时 G1 会把空闲 region 还给操作系统,日志里那个 committed 从 256M 掉到 220M 就是它在还);二是同一台机器上跑多个 Java 进程时,内存占用是可预测的,不会因为某个服务突然扩容把邻居挤死。
还有一个参数叫 -XX:+AlwaysPreTouch,作用是启动时就把堆的每一页都摸一遍,让页表提前铺好。代价我测了:4G 的堆,不加它启动 0.06 秒,加了 0.44 秒,多花 0.4 秒。
值不值?小堆不值,重启快才是硬道理。堆上到 16G 以上,我倾向加,因为运行期第一次触碰内存的抖动会散落在业务时段里,你很难把它和一次慢请求对应起来。
四、元空间:只封顶,别给初始值
MaxMetaspaceSize 的默认值,用 PrintFlagsFinal 读出来是这个数:18446744073709551615。
这是 64 位无符号整数的最大值,翻译成人话就是没有上限。类加载器泄漏的时候,元空间会一路涨到把机器内存吃光,然后进程被操作系统杀掉,连个 OOM 的堆栈都不给你。
所以这一行必须写。512m 是我们大多数服务的值,够 Spring Boot 应用加上动态代理那点开销。真用了大量运行时生成字节码的东西(Groovy 脚本、模板引擎预编译、大批量 CGLIB 代理),往上调。
还有一行长得像的参数,叫 MetaspaceSize,默认 21MB。它不是初始大小,是「第一次因为元空间触发 GC 的水位线」。 很多人把它当初始值写,写个 512m,然后以为元空间一启动就占 512m。
我们的模板里没有这一行。原因很简单:现代应用启动时要加载几千到上万个类,21MB 这个水位在启动期本来就会被突破一次,设不设,差别只在启动期多几次 GC。服务跑起来之后,这个数就没有意义了,真正管用的是上限。
少一个数,就少一个以后需要维护的假设。
五、栈:默认别动,动就是拿线程数换递归深度
-Xss 是每个线程的栈大小。我做了一组实验,同一个递归方法,改栈大小看能压多深:
-Xss | |
|---|---|
1m | |
256k | |
8m |
先说这组数的局限:同一个参数重复跑,深度会在同一量级上下浮动,因为方法被 JIT 编译之后栈帧大小会变。所以这些数只能看数量级,不能当基准测试引用。但数量级已经够说明问题了。
调小到 256k,递归深度从两万层掉到不到一千层。 一个 JSON 的递归解析、一次树的深度遍历、一个不小心写成递归的字符串处理,就能让线上抛 StackOverflowError。这种错在测试环境经常碰不到,因为测试数据浅。
调大到 8m,深度涨到三十二万层,代价是每个线程多占 8M 地址空间。 500 个工作线程就是 4G 虚拟内存,堆才 8G。线程数一多,光栈就吃掉半个堆的地址空间,容器里更明显。
那默认值是多少?这台 Mac 上是 2M,Linux x64 上一般是 1M。不同平台不一样,所以别在脚本里写死。 想知道你的环境是多少,一行命令:
java -XX:+PrintFlagsFinal -version | grep ThreadStackSize六、出事了要留证据,这四行比调参重要
这四行不产生任何性能收益,但它们的价值在最坏的那天兑现。
第一行,-XX:+HeapDumpOnOutOfMemoryError。 没有它,OOM 就是一句报错,堆里到底堆了什么,你只能靠猜。加上它,JVM 在 OOM 时会先把整个堆倒出来再抛错。
第二行,-XX:HeapDumpPath。 这行的坑最多,我踩了两个。
第一个坑:路径指向一个固定文件名,第二次 OOM 的时候:
Dumping heap to /tmp/oomflag/none ...Unable to create /tmp/oomflag/none: File exists堆转储写不出来。指向目录才对,JVM 会自己按 java_pid<pid>.hprof 命名:
-rw------- 1 francis wheel 35930542 11-20 09:58 java_pid9661.hprof同一个目录放十份也不会互相覆盖,事后按时间挑就行。
第二个坑:路径指向一个不存在的目录。JVM 不会在启动时检查,它只在 OOM 那一刻试一次:
Dumping heap to /data/dump ...Unable to create /data/dump: No such file or directory然后照常抛出 OOM。整件事只在这一行 stderr 里留下痕迹,dump 一个字节都没有。镜像换过一版、挂载点改过名字、权限没给够,这行就会在你最需要它的时候失效。
第三行,-XX:+ExitOnOutOfMemoryError。
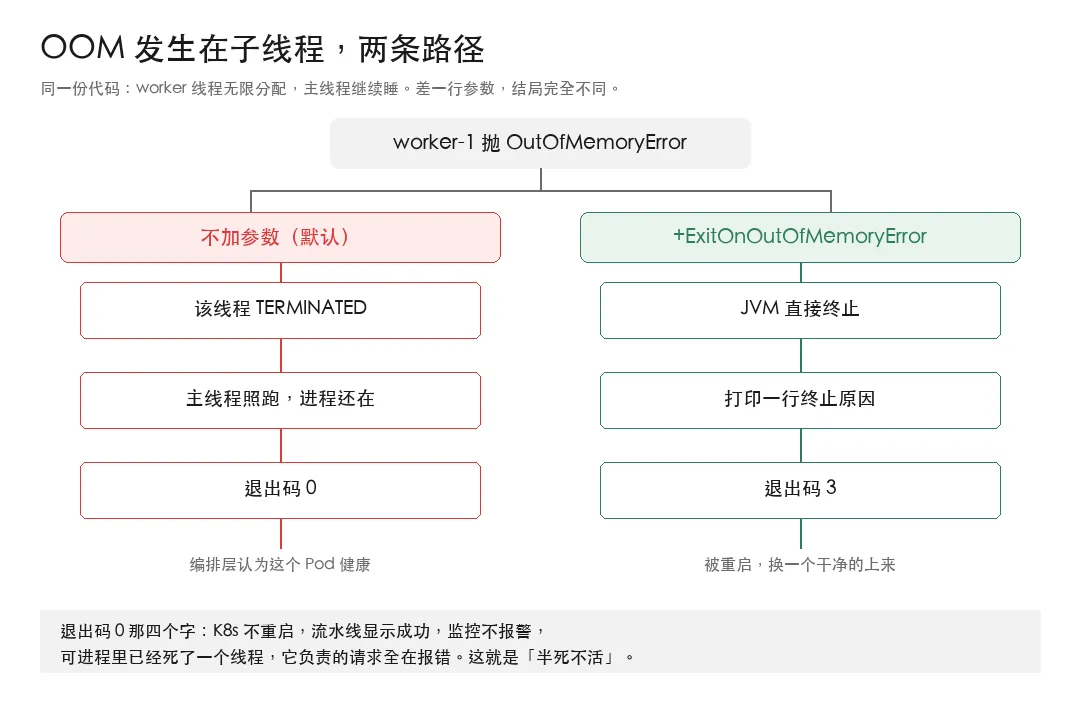
这行经常被误读成「OOM 就自杀」。我写了个程序,让 OOM 发生在子线程里,主线程继续跑:
Exception in thread "worker-1" java.lang.OutOfMemoryError: Java heap space主线程还活着,进程仍在,worker 状态=TERMINATED退出码: 0退出码 0。
这四个字比什么都有说服力。K8s 认为这个 Pod 跑得好好的,发布流水线认为这次运行成功,监控只看退出码的话什么都不会报。而实际上这个进程里有个工作线程已经死了,它负责的那部分请求全在报错,连接池里的连接还在,健康检查可能还是绿的。这就是「半死不活」:一个坏掉的进程,占着位置,不干活。
加上 -XX:+ExitOnOutOfMemoryError 之后:
Terminating due to java.lang.OutOfMemoryError: Java heap space退出码: 3退出码 3,编排层看到它,重启一个干净的上来。这不是自杀,是让一个已经坏掉的进程尽快退场。
第四行,-XX:ErrorFile。
这一行管的是 JVM 自己崩掉的情况(native 崩溃、SIGSEGV),写的是 hs_err_pid.log。默认写在进程的工作目录,容器里那个目录可能是只读的,也可能随 Pod 一起没了。指到持久化目录,文件名带 %p,多份不打架。
七、日志:一行 -Xlog,filecount 和 filesize 怎么定
模板里最长的那行就是它:
-Xlog:gc*:file=/data/log/gc.log:time,uptime,level,tags:filecount=10,filesize=50m写法不展开,之前那篇《Full GC 频繁,我第一眼看的是括号》讲过。这里只说 filecount 和 filesize 怎么定。
这一行的意思是:最多留 10 个文件,每个 50M,写满就轮转,最老的被覆盖。 上限 500M。
定法很简单,问自己一句:这服务一天写多少 GC 日志?
一天 200M 的服务,filecount=10 配 filesize=50m 能留两天半,出事后有足够的时间回看。一天写 1G 的,把 filecount 提到 20,或者 filesize 提到 100m,别让一次大促把出事前那半小时冲掉。
为什么一定要多份:你出事之后想看的,永远是「出事前那半小时」。 单文件被覆盖,等于把现场冲进了下水道。
日志级别我只要 info。想看并发标记和分代年龄的细节,压测的时候临时加 gc+age=trace,gc+phases=debug,生产上不要开,那个量级一天能写几个 G。
如果想查「莫名其妙的停顿」,加个 safepoint 到日志选择器里:-Xlog:gc*,safepoint:file=...。会让线程停下来的不止 GC:抓线程栈(jstack)、反优化(JIT 编译出来的代码被判无效,退回解释执行)、某些 JVMTI 操作,都要所有线程走到安全点才能继续。这些停顿不长,但偶尔能撞上。
八、删掉的七行
先交代一件事:这七行不是错的,是过期的。
同一份脚本,我在本机的 JDK 8 上跑过一遍(1.8.0_491)。MaxPermSize 只打一句 ignoring option MaxPermSize=256m; support was removed in 8.0,PrintGCDetails 和 UseConcMarkSweepGC 一声不吭,照常工作。
所以这份脚本在 2018 年是对的,它只是没人告诉它 JDK 换过了。这也是为什么它能活这么多年:在旧版本上它确实好用,连报错都不报。
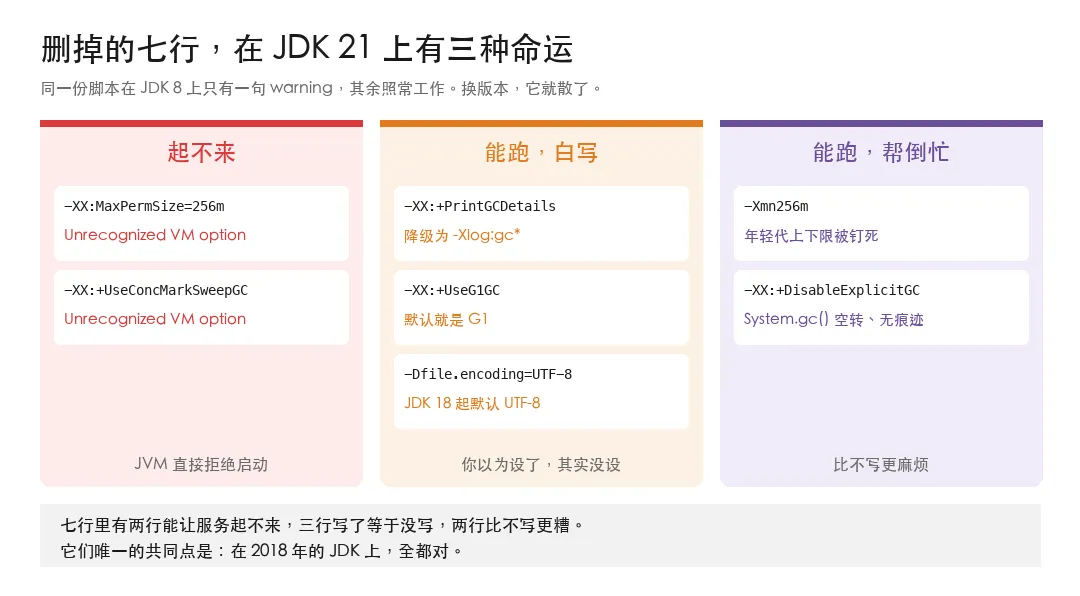
下面是它在 JDK 21 上的样子。左边是写法,中间是实际反应,右边是替代做法。
-XX:MaxPermSize=256m | Unrecognized VM option | MaxMetaspaceSize |
-XX:+UseConcMarkSweepGC | Unrecognized VM option | |
-XX:+PrintGCDetails | -Xlog:gc* | -Xlog |
-XX:+UseG1GC | ||
-Xmn256m | ||
-Dfile.encoding=UTF-8 | ||
-XX:+DisableExplicitGC | System.gc() 变空转,日志里没痕迹 |
逐条说几句。
-XX:MaxPermSize。 永久代是 JDK 8 就删掉的东西。JDK 8 上它还会打一句「ignoring option, removed in 8.0」,到 21 连这句都不给了,直接不认。有意思的是,我见过 2025 年新建的项目还在写这一行,因为「架构组给的模板里就有」。
-XX:+UseConcMarkSweepGC。 CMS 在 JDK 9 标记废弃,JDK 14 彻底移除。这一行在 21 上的报错和上面一模一样。想换回收器,现在的选项是 G1(默认)、ZGC、Parallel,各有各的取舍,但 CMS 这条路已经封了。
-XX:+PrintGCDetails。 这一行最阴。它能跑,只是打一行 warning:
-XX:+PrintGCDetails is deprecated. Will use -Xlog:gc* instead.然后照常输出。所以很多人以为它还在生效,其实 JDK 内部已经把它翻译成 -Xlog:gc* 了。那你还不如直接写 -Xlog,至少能自己控制输出到哪个文件、留几份。
顺便说一句,同样是 PrintGC 系列,-XX:+PrintGCTimeStamps 的下场更干脆:Unrecognized VM option,连降级都不给。同一个系列里,有的留了兼容、有的直接砍掉,指望「老参数大概还能用」是不靠谱的。
-XX:+UseG1GC。 | ,输出那一行的最后一列写着 ergonomic,意思是「JVM 自己选的」,不是你指定的。你写了它,那一列会变成 command line`,行为一模一样。 |
-Xmn256m。 这个最值得说,因为它是「写了还不如不写」的典型。我把两个版本都读了一遍:
不带 -Xmn 时,NewSize 是 1.3M(默认),MaxNewSize 是 2.4G(G1 自己算的),中间有巨大的活动空间。带上 -Xmn256m 之后,NewSize 和 MaxNewSize 双双变成 256M,最后一列都是 command line。
你以为在建议「年轻代给 256M」,实际上是把它钉死成 256M,G1 一点调整余地都没有了。 而 G1 达成停顿目标的唯一手段就是调整年轻代大小,你把这个旋钮焊死,它就只能接受你给的结果。这条之前那篇 G1 调优里写过,但值得重复:迁移到 G1 的第一件事,是把 CMS 时代留下的 -Xmn 和 -XX:NewRatio 全删掉。
-Dfile.encoding=UTF-8。 JDK 18 的 JEP 400 把默认编码定成了 UTF-8。实测:
file.encoding = UTF-8native.encoding = UTF-8不写就是 UTF-8。什么时候该写?只有在你要把它改成别的编码时(比如对接一个只认 GBK 的老系统),而且你得清楚自己在干什么,因为写上去就是把默认值钉死,将来 JDK 再改默认值,你这份配置会顽固地停在旧行为上。
-XX:+DisableExplicitGC。 这行的作用是把代码里所有 System.gc() 变成空操作。我测了三种情况,同一个程序,中间调一次 System.gc():
默认: GC(2) Pause Full (System.gc()) 129M->129M(258M) 0.983msDisableExplicitGC: (日志里没有任何一行提到 System.gc())ExplicitGCInvokesConcurrent:GC(2) Pause Young (Concurrent Start) (System.gc()) 0.211ms默认那次是 Full GC,0.983ms。加了 DisableExplicitGC,日志里彻底没有痕迹,连「有人调过」这件事都查不到。
这行的问题不在于它「屏蔽了一次 GC」,而在于它同时屏蔽了一条线索。哪天你的服务内存莫名其妙地涨,你怀疑有人在调 System.gc(),日志里什么都看不到,因为是你自己让它消失的。
真要防这一手,用 -XX:+ExplicitGCInvokesConcurrent。它不屏蔽,只是把 Full GC 换成一次并发周期:上面第三行能看到,停顿从 0.983ms 变成 0.211ms,日志里也留了痕。既限制住代价,又保留了证据。
九、抄之前改三个数,抄完验三件事
模板可以抄,但有三个数必须按你的环境改。
第一,-Xms 和 -Xmx。 容器里按 limit 的 50% 到 75% 算,不要按物理机。8G limit 的 Pod,堆给 4G 到 6G,剩下的留给元空间、栈、直接内存、以及 JVM 自己那些记不进堆的开销。给到 75% 以上,OOM 的往往不是堆,是容器被整体干掉。
第二,-XX:MaxMetaspaceSize。 512m 是 Spring Boot 的常见值。你用了多少动态字节码,自己心里要有数:Groovy、大量 CGLIB、脚本引擎,往上加。
第三,filecount 和 filesize。 按一天的日志量倒推,别照抄 10 和 50m。这两个数抄错了不会报错,只会在出事那天发现日志已经被冲掉了。
抄完验三件事。
验一:参数真的生效了吗。
java -XX:+PrintFlagsFinal -version | grep -E "MaxHeapSize|MaxMetaspaceSize"看 MaxHeapSize 是不是你写的那个数。如果不是,要么是被后面的参数覆盖了,要么是容器感知把它改了。
覆盖这件事比你想象的常见。 同一个参数写两遍,后面的赢,我实测过:-Xmx1g -Xmx2g 跑出来是 2G,而且最后一列老老实实写着 command line,看不出是哪一行生效的。启动脚本里如果有「一份基础模板 + 一份服务自己的」,这种覆盖天天发生,还不报错。
这一步花十秒,能省掉以后所有「我明明设了 8G」的争论。
验二:压一轮,看有没有 Full GC。
grep "Pause Full" gc.log | wc -l只要不是 0,先别调参,先看是哪一类 Full(日志里括号会告诉你是疏散失败、元空间还是 System.gc())。这时候调参只是把症状往后推。
验三:故意 OOM 一次。
把 -Xmx 改成 64m,跑一个死循环分配的类,看两件事:dump 有没有按预期生成,退出码是不是 3。
java -Xmx64m -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/data/dump \ -XX:+ExitOnOutOfMemoryError -cp . Oomecho $?这条最值得做,因为前面两条验的是「配置对不对」,这一条验的是「出事那天你到底有没有证据」。这一步不做,前面两行等于没写:路径可能没权限,目录可能不存在,ExitOnOOM 可能被某个启动脚本里的 -XX:-ExitOnOutOfMemoryError 覆盖掉。这些都不会在正常运行时暴露。
写在最后
九行里,有五行的作用只是「出事了留证据」,跟调优没关系。
这个比例是我这些年最实在的一个体会:真正让服务稳的,往往不是让事故不发生的那些参数,而是让事故发生后能查清楚的那些参数。 事故总会发生,问题是你有没有现场。
参数是保险,不是药。保险不能让你不生病,但能让你在病的时候知道病在哪。
那份十六行的脚本最后剩了九行。删掉的七行里,两行能让 JVM 起不来,一行静默降级,剩下四行要么写了等于没写,要么比不写更糟。它们躺在仓库里好几年,没人动,也没人敢动。
如果你手上也有一份这样的脚本,建议做一件事:逐行问「删掉它,行为会不会变」。答不上来的,就是该删的。
你们线上的启动脚本多少行?里面有几行是「前人加的,没人敢删」的?评论区聊聊。
相关阅读
《G1 调优实战:MaxGCPauseMillis 的谎言》:GC 那几个参数为什么不能乱动, -Xmn为什么必须删《GC 日志怎么看:一份日志里的三步崩盘》:日志开了之后,一份完整日志该怎么读 《OOM 分四种,加堆内存只救一种》:四种 OOM 的 message 与 dump 差异,都是实测