ARTICLE · 1387336
做 RAG 一定要上 Milvus?我把源码扒了一遍
一句话:换向量库确实只改一个 Bean,但「同一个接口」不等于「同一个行为」。 我把社区模块的源码扒了一遍,6 处差异,每一处都会让结果悄悄变掉,而且不报错。
① 先说结论
先说清楚我自己的项目:它的向量库不是 Lucene。
是 InMemoryEmbeddingStore + 一个 JSON 文件。
类名 LuceneVectorConfig、目录名 lucene-rag-index/、连仓库名都叫 lucene-rag —— 全是历史包袱。 早期方案换掉了,名字没跟着改。
那我怎么知道换 Lucene 会出事?
我把社区模块的源码扒了。dev.langchain4j:langchain4j-community-lucene,版本 1.9.0-beta16(跟本项目的 BGE 嵌入模块同一条 beta 线)。
扒完我数了一遍:6 处真实差异,其中 3 处会静默改变结果。
| score 刻度不同 | minScore(0.7) | |
| 过滤器静默丢弃 | log.debug,你的过滤条件根本没生效 | |
| 删除直接抛异常 | removeAll()UnsupportedFeatureException | |
| 返回的向量恒为 null | match.embedding() 的代码直接 NPE | |
| 中文分词不支持 | StandardAnalyzer | |
| 旧库不可迁移 | store.json |
「换 Bean 只改一行」这话本身没错。错的是把它当成「换了就一样」。
② 一个反直觉的结论
Lucene 听起来是「全文检索之王」,中文分词却是它最弱的一环 —— 而中文 RAG 恰好正中这一枪。
我一开始的判断是:Lucene 有 BM25、有倒排、有成熟的分词器,中文肯定比纯向量检索强(毕竟中文分词是国产搜索引擎的看家本事)。
错了。
社区模块的全文检索用的是:
new QueryParser(contentFieldName, new StandardAnalyzer())
StandardAnalyzer 是 Lucene 的默认分词器,不支持中文分词 —— CJK 字符会被一字一 token 切开。
📌 「LangChain4j 是 Java 生态的大模型框架」→ 被切成
Lang、Chain4j、是、Ja、va、生、态、的、大、模、型、框、架BM25 那一路的全文召回质量,在中文上明显偏弱。
而我的项目是 bge-small-zh + 中文文档 ——恰好是 StandardAnalyzer 最吃亏的场景。
所以结论有点反直觉:
想做「全文 + 向量」混合检索,Lucene 是对的选型 —— 但前提是你的文档不是中文。中文场景下,它在最有价值的那个能力上,恰好是最弱的。
顺带一提,Lucene 的 QueryParser 对用户问句里的特殊字符(:"()会抛 ParseException,那一路检索会被直接降级丢弃。
③ 跑一遍看看
⚠️ 先声明一件事,这篇的诚信底线:我的项目没有真的接 Lucene。
pom.xml里没有这个依赖, 下面每条差异都是对社区模块 1.9.0-beta16 源码的核实,我标了源码位置。 凡是我没实跑过的,我不写「我实测」。
3.1 最要命的一条:score 刻度
同一个 EmbeddingSearchRequest,两个实现给出的 score 完全不是一回事:
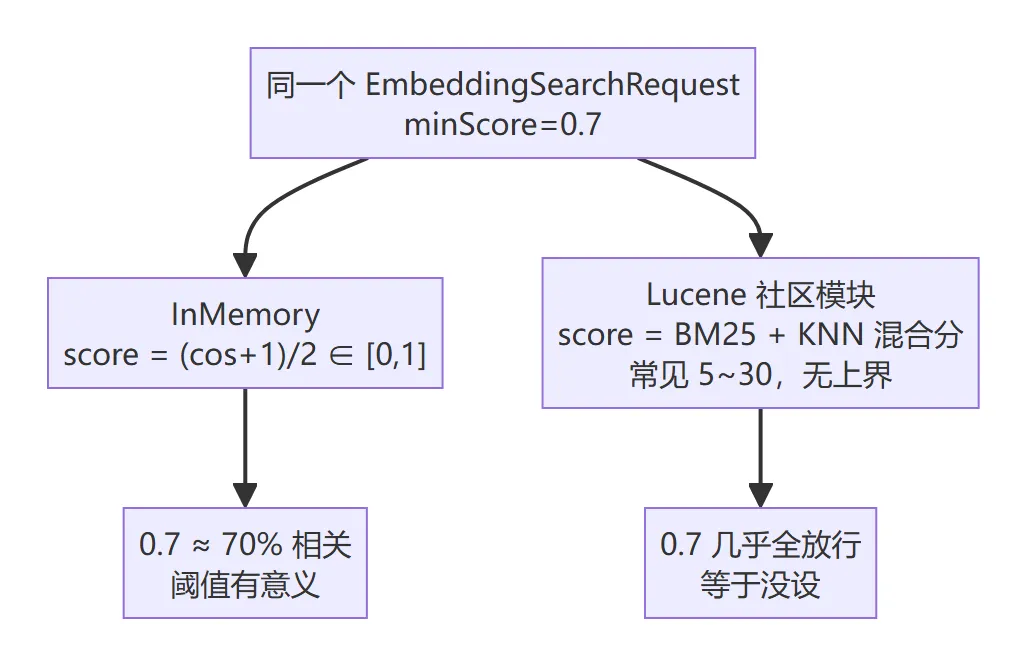
为什么 InMemory 的 score 一定在 [0,1]? 因为它的实现是这么算的:
// RelevanceScore —— 上游源码
publicstatic RelevanceScore fromCosineSimilarity(double cosineSimilarity){
returnnew RelevanceScore((cosineSimilarity + 1) / 2);
}
余弦相似度天然在 [-1, 1],**映射到 [0, 1]**。 所以 minScore(0.7) 在 InMemory 上真的就是「70% 相关」—— 可解释。
Lucene 那边返回的是原始 BM25 + KNN 混合分,没有上界(常见 5~30)。minScore(0.7) 对这个刻度来说,低到等于不存在。
这是「切换无感」最容易翻车的地方 —— 参数没动,代码没动,结果悄悄变了。 还不报错。
3.2 一个必须澄清的坑:minScore 根本传不了 10.0
我在自己的文档里写过一句「在 Lucene 上设 minScore(10.0) = 几乎全被过滤」。
这句话是错的。 扒源码才发现,EmbeddingSearchRequest 的构造器里就有这么一行:
this.minScore = ensureBetween(getOrDefault(minScore, 0.0), 0.0, 1.0, "minScore");
minScore 被硬校验在 [0, 1]。传 10.0 直接抛 IllegalArgumentException —— 根本走不到「过滤」那一步。
所以准确的说法是:
在 Lucene 上,你没法靠调高
minScore来救。这个旋钮只能在[0,1]里拧, 而 Lucene 的分根本不在这个区间里。换句话说,这个阈值参数在某些向量库上压根不够用。
(顺便:maxResults 的默认值也是 3,源码 getOrDefault(maxResults, 3)。你的配置值跟框架默认值撞车的时候,你根本不知道自己在用哪个。)
3.3 过滤器:静默丢弃,不报错
filter.test(metadata) |
Lucene 那边的源码就一行:
log.debug("Ignoring request filter");
log.debug。
也就是说:你的过滤条件被扔掉了,程序继续跑,结果里全是不该出现的文档。不抛异常、不打 warn、不影响返回码。 默认日志级别下你连那行 debug 都看不到。
📌 这 6 条里我最警惕的就是这条,因为它连「结果变了」都不算 ——你以为自己设了一个约束,其实没设。查这种问题最快的办法:把日志级别调到 debug,看有没有 "Ignoring" 这行。
3.4 删除:直接抛异常
removeAll() | UnsupportedFeatureException |
这条反而是最友好的失败 —— 它会炸,炸得明明白白。 「文档过期了要删掉重录」这种需求一上 Lucene 就直接编译期/运行期报错。
对比第 3.3 条:一个会炸,一个不炸。我宁愿它炸。
3.5 返回的向量:Lucene 那边恒为 null
EmbeddingMatch 有 4 个字段:
publicclassEmbeddingMatch<Embedded> {
privatefinal Double score;
privatefinal String embeddingId;
privatefinal Embedding embedding;   // ← Lucene 里恒为 null
privatefinal Embedded embedded;
}
match.embedding() |
为什么? Lucene 的 KnnFloatVectorField不存原向量 —— 它只建索引。
如果你的代码里有「拿命中片段的向量再算一次距离」这种逻辑,换过去之后会 NPE,而且只在检索命中时才 NPE —— 空库时不炸,有数据才炸,非常难查。
3.6 中文分词:StandardAnalyzer 一字一 token
上面 §② 已经讲透了,这里补个具体的:
LuceneContentRetriever 的全文检索:
new QueryParser(contentFieldName, new StandardAnalyzer())
StandardAnalyzer 是 Lucene 默认的英文分词器,遇到 CJK 字符走的是StandardTokenizer 的 CJK 分支(按单个汉字切)。
LangChain4j 是 Java 生态的大模型框架 | LangChain4j是Java生态的大模型框架 |
「生态」被切成「生」「态」—— BM25 的词频统计就废了。
3.7 依赖与持久化
| 零 | 约 9MBjtokkit 1.1.0) | |
serializeToFile) | Directory 索引目录 | |
store.json 不可迁移,必须重新入库 |
换 Bean 的代码确实很短:
// demo / 万级以内:零外部依赖
@Bean
public EmbeddingStore<TextSegment> embeddingStore(){
returnnew InMemoryEmbeddingStore<>();
}

// 想上全文 + 向量混合检索
@Bean
public EmbeddingStore<TextSegment> embeddingStore(){
return LuceneEmbeddingStore.builder()
            .directory(Path.of("./lucene-index"))
            .embeddingModel(embeddingModel)
            .build();
}
接口是同一个 EmbeddingStore<TextSegment>,所以「只改一个 Bean」是成立的。但「无缝替换」不成立 —— 上面 6 条,每一条都会让你重新想一遍。
3.8 那到底该选哪个
| InMemoryEmbeddingStore | ||
| Lucene | ||
| 中文文档 | StandardAnalyzer | |
| 十万级以上 / 多实例 / 要高可用 | Milvus / Qdrant / pgvector | |
| 已有 ES 集群 | ES 8+ |
一句话总结选型:InMemory 够用的时候别换;中文场景下 Lucene 的混合检索优势发挥不出来; 真正需要向量库的场景是十万级以上,那时候 Milvus 才是答案 —— 而不是 Lucene。
④ 踩过的坑(怎么定位的)
这一节列的都是换库时才会遇到的坑。前三个是我扒源码扒出来的, 后两个是我自己项目里踩的。
坑 1:过滤器静默丢弃 —— 最阴的一个
现象:你的代码里有 filter(按 source 过滤、只要某个业务域的文档), 换到 Lucene 之后,返回结果里混进了不该出现的文档。 不报错、不打日志、返回 200。
根因(社区模块源码):
log.debug("Ignoring request filter");
一行 debug 日志,然后把你的过滤条件扔了。
怎么定位的:这是最需要「主动怀疑」的一类问题 ——因为没有任何异常指向它。 我的办法是:**把日志级别调到 debug,grep "Ignoring"**:
logging:
level:
dev.langchain4j.store.embedding.lucene:DEBUG
一行日志,直接现形。
怎么修的:别指望换库能带过去。 要么在换库之前, 先 grep 一遍自己代码里所有 filter 的使用点,逐个确认在新库下还有效; 要么就接受「这个过滤在新库上没有」,自己写一层。
有个直觉我到现在还留着:跨实现切换时,最危险的不是「报错」,是「不报错」。报错你知道。静默降级,你只会怀疑人生。 所以换库之后第一件事:拿同一批数据、同一组参数,跑一次对比。
坑 2:minScore 形同虚设 —— 参数不变,结果悄悄变
现象:InMemory 上 minScore=0.7 能滤掉一批低分片段; 换成 Lucene 之后,低分片段全放行了,答案里开始出现不相干的段落。
根因:score 刻度不同(§3.1)。InMemory 是 (cos+1)/2 ∈ [0,1],Lucene 是 5~30 的原始分。
怎么定位的:别看参数,看返回值。 我把两边命中的 score 都打出来对比:
// 临时加一行,看真实刻度
matches.forEach(m -> log.info("score={} text={}",
        String.format("%.4f", m.score()), m.embedded().text().substring(0, 20)));
InMemory 打出来是 0.9234 这种,Lucene 打出来是 18.7721 这种 —— 一眼就知道不是一套刻度。
怎么修的:换库时,所有跟阈值有关的参数全部重新校准。别照抄旧值,也别指望调大 —— 那个旋钮被锁在 [0,1] 里(§3.2)。
坑 3:removeAll 抛 UnsupportedFeatureException
现象:「文档过期了要删掉重录」这个需求,一换库就炸。
根因:社区模块没实现这个方法。
怎么定位的:接口方法一眼能看出来 —— javap 一下 LuceneEmbeddingStore, 看它覆写了 EmbeddingStore 的哪些方法,没覆写的那些就是会抛的。
怎么修的:这反而是好事 —— 抛异常比静默丢弃强多了。 唯一要做的是在切换清单里把它列出来,别等上线才发现。
坑 4:命中片段的向量取不到 → NPE
现象:检索命中之后抛 NullPointerException,但空库时一切正常。
根因:match.embedding() 在 Lucene 下恒为 null(§3.5)。 我的代码里有一处「拿命中向量和查询向量再算一次距离做二次排序」。
怎么定位的:NPE 的堆栈直接指到那一行。难的是复现 —— 必须「有数据 + 命中」才会触发。
怎么修的:
要么这段逻辑就不该存在(二次排序用 score就够了)要么就别依赖 embedding()非空,改成Optional或显式判空并说明为什么是 null
坑 5:我自己项目里的坑 —— 类名和配置都在骗人
现象:想「把向量库换成 Lucene」,打开代码找 LuceneVectorConfig, 发现里面建的是 InMemoryEmbeddingStore。
更坑的是application.yml 里写着:
vector:
store-type:inmemory-json# ← 没有任何代码读它
index-dir:./lucene-rag-index
store-type 是纯装饰性配置。 没有任何 @Value 读它。 目录名 lucene-rag-index 也只是历史包袱,里面躺的是一个 JSON 文件。
怎么定位的:grep -rn "store-type" src/main/java —— 零命中。
怎么修的:改配置没用,得改 Bean。然后把误导性的名字改掉。
这一条我单独拎出来说,因为它跟选型没关系,但杀伤力一样大:你的配置项、类名、目录名,会让下一个人(或者半年后的你)做出错误判断。名字里带着错误信息,比没名字更贵。
⑤ 什么场景别用它
| 「看别人都上 Milvus,我也上」 | |
| 「InMemory 不够专业」 | |
| 「Lucene 是全文检索之王,中文肯定强」 | StandardAnalyzer |
| 「换 Bean 就等于换了个库」 | |
「先把 store-type 改成 lucene 试试」 | |
| 「先用着,等数据涨到百万再换」 | store.json 不可迁移,必须重新入库 —— 十万条重新入库的 embedding 成本,算过再决定 |
| 「中文 RAG 上 Lucene 混合检索」 |
最后一条最值得展开:
如果你真的需要中文的「全文 + 向量」混合检索,Lucene 社区模块的默认配置只是个起点。中文分词、retriever、两路结果怎么融合,都得你自己接。 你得自己接一个中文分词器,自己写 retriever,自己控制两路结果怎么融合。 做到这一步,性质就变了 —— 换个 Bean 变成了换一套检索层。
这时候真正该问的是:我要的是混合检索,还是「能撑住千万级」?这是两个问题,别混在一起答。
企业级怎么换
我这套是 MVP 的选择。到了企业级,换法没这么轻:
| pgvector | ||
| Milvus | ||
| ES 8+ |
选的时候,关键不是「谁更强」,是「你手上已经有什么」。
已经有 PostgreSQL,就别为一个向量库再上 Milvus;已经有 ES,就别单独引一套 Lucene。 多引一个中间件就多一份运维成本,而这份成本通常没被算进选型表里。
Java 团队其实大部分不用做选择题
上面那三条是我自己走过的。换成 Java 后端的视角来看,大多数项目根本不用挑 —— 你手上已经有的东西,直接就决定了答案:
| pgvector | ||
| ES 8+ | ||
| Redis Stack | ||
| Atlas Vector Search | ||
| MySQL 9.0+ 原生 VECTOR | ||
| 先 pgvector |
Java 这条线还有两个坑:
别在核心链路上用 JNI 封装的向量库。Java 调 FAISS 这类方案,JNI 一崩整个 JVM 跟着崩,这个风险不值当 —— 离线批量算向量可以,在线检索不行。 客户端 SDK 的版本必须跟服务端严格对齐。Java SDK 的小版本一多,服务端升了、SDK 没跟上,协议就不兼容,报出来的错还特别难懂。
还有一条不算坑,但很影响开发速度:优先选 Spring AI / LangChain4j 原生支持的方案。 原生支持意味着你少写一大圈封装代码 —— 说白了,就是少在「怎么把向量库包装成 LangChain4j 认的样子」上花时间。
而这一层恰恰是最容易出错的地方 —— 本文开头那 6 条差异,全都发生在包装层底下。
这也是我为什么从 InMemory 起步 —— 它未必最好,但最不需要运维。等运维成本小于性能收益了,再换。
接下来的: 第 4 篇《一行配置切换 6 款大模型》—— 换 LLM 和换向量库是两回事:换 LLM 改三个字段,换向量库要重新想 6 件事。
本文完整梳理对应技术的原理逻辑、落地方案与使用边界,可直接用于项目实践与技术学习参考。