ARTICLE · 947965
一个插件,让 DeepSeek V4 能力超越 Fable 5?
一个插件,让 DeepSeek V4 能力超越 Fable 5?最近一组测试数据,属实有点炸裂。 DeepSeek V4 Pro-0813 只是加载了一个开源插件——没有微调、没有改一行模型权重——就在多项 Agent 和 Coding 测试里,直接干过了 Fable 5。 更夸张的是,在项目汇总的 9 项公开参考测试中,V4 Pro + J-Space 拿下了 7 项最高分。 不废话,直接上数据: 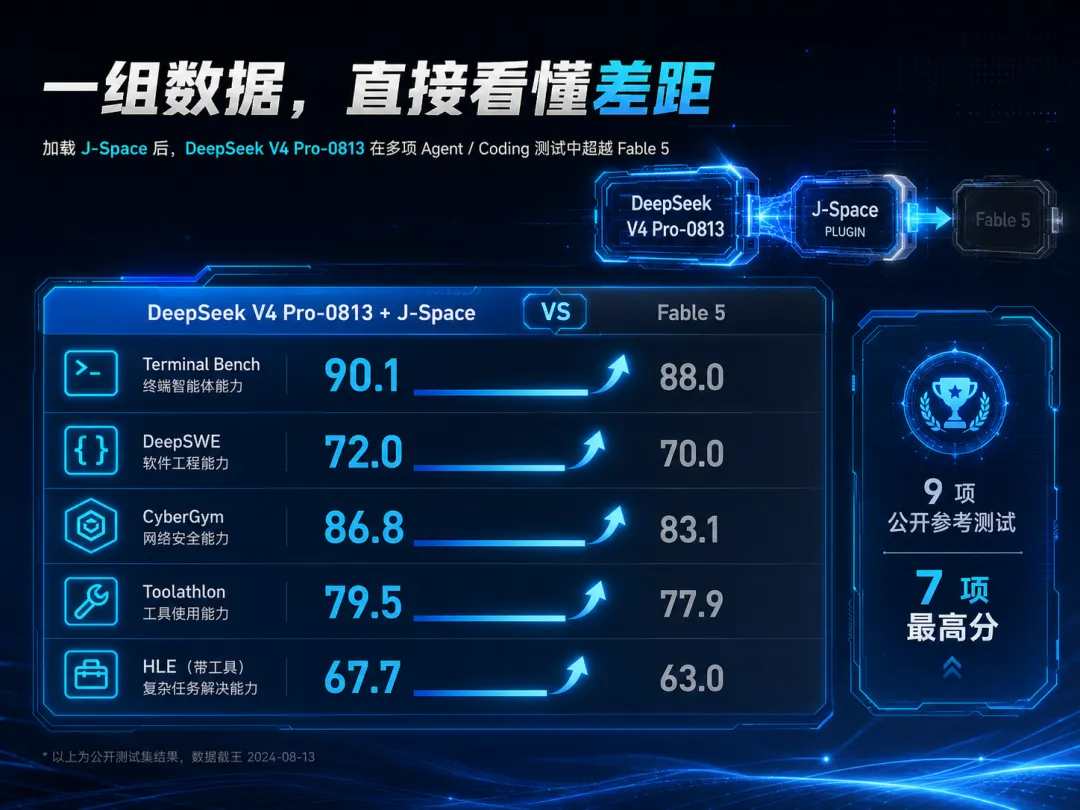
Terminal Bench 2.1:90.1(Fable 5:88.0) DeepSWE:72.0(Fable 5:70.0) CyberGym:86.8(Fable 5:83.1) Toolathlon:79.5(Fable 5:77.9) HLE(带工具):67.7(Fable 5:63.0) 甚至在 NL2Repo、Terminal Bench、CyberGym 这些项目里,它还超过了 Opus 4.8、GLM-5.3 等一众顶级模型的公开参考成绩。 而最关键的一点是: DeepSeek V4 本身,一行权重都没动。 真正发生变化的,是它外挂了一个叫J-Space Cognition Suite的推理时控制插件。 这就引出了一个非常有意思的问题: 如果不训练模型、只改变模型"怎么干活",性能都能涨这么多——那我们平时看的模型跑分,真的是模型能力的全部吗? 答案恐怕是:不是。 J-Space 作者提出了一个概念,我个人觉得值得所有人记住:能力实现损失(Capability Realization Loss)。 翻译成人话就是: 模型其实会,但一到真正干活的时候,能力没发挥出来。 你肯定见过这些场景: 任务做到一半,忘了最初的目标; 工具调用失败,从头再来一遍; 改了五个文件,只验证了两个; 上下文越拉越长,开始反复"分析",就是不动手; 活儿还没验证完,就急着宣布"任务完成"。 注意,这都不是"模型不会"。 而是模型的能力,在工具调用、文件切换、长上下文、状态管理、失败恢复这一层层流程里,被一点点"漏"掉了。 就像一个学霸去上班:知识都在脑子里,但没有项目管理、没有任务清单、没有复盘机制,照样交付得一塌糊涂。 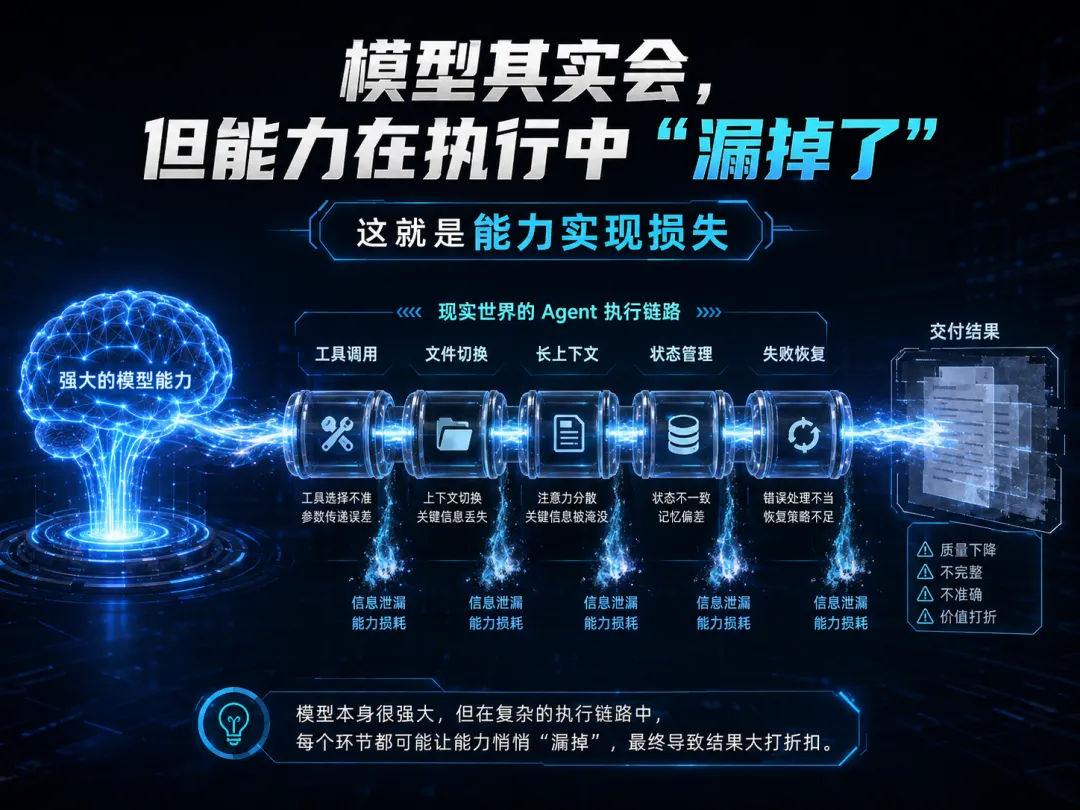
它不替模型思考,它管理模型的思考过程。 复杂任务会被拆成一条清晰的流水线: 判断 → 行动 → 验证 → 保存状态 → 继续执行。 同时维护 Goal、Verified、Open、Next 四类状态,让模型随时清楚四件事: 我最终要干什么; 哪些已经确认没问题; 哪些坑还没填; 下一步该做什么。 工具调用失败也不再是"推倒重来",而是记下失败原因,从最近一个可靠状态恢复继续。 一句话总结这个组合: DeepSeek V4 负责智力,J-Space 负责让这份智力别被浪费。 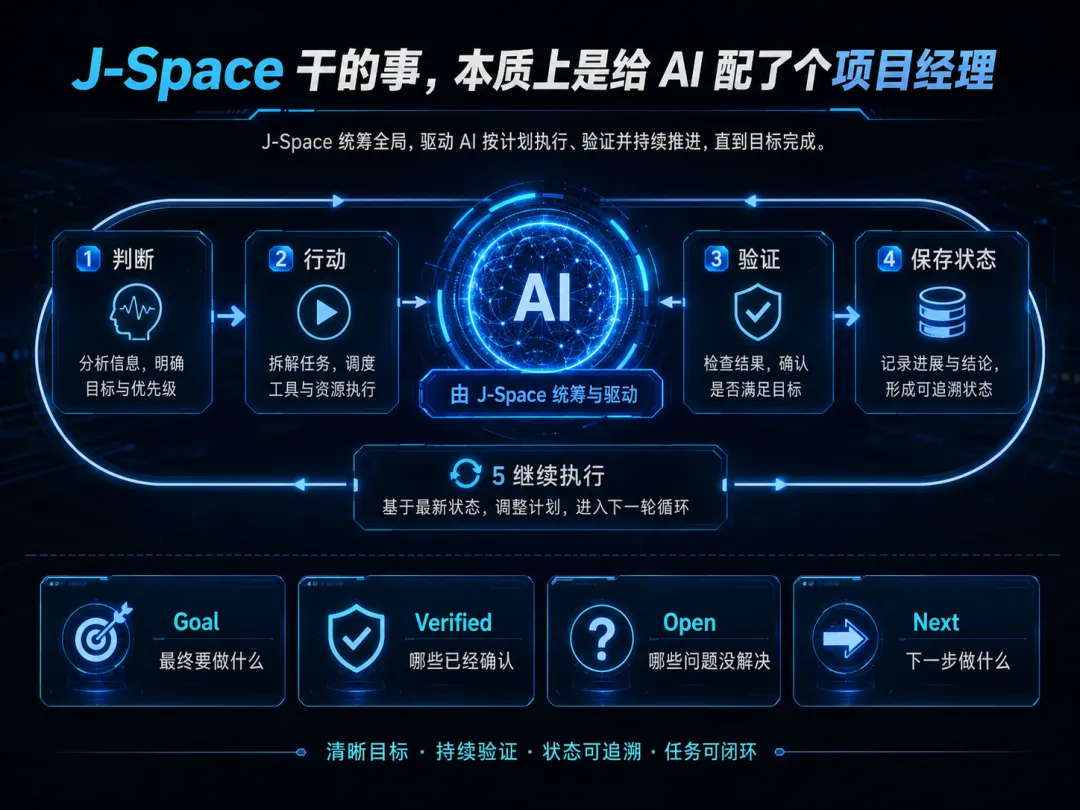
先泼盆冷水:这些结果,目前要谨慎看待。 J-Space 的 DeepSeek 数据属于单次实测,没有多随机种子、没有置信区间;Fable 5、Opus 4.8、GLM-5.3 的成绩来自各家公开数据,也不是放在同一个测试框架里重跑的。 项目作者自己也明确承认了这一点。 所以现在还不能喊出那句"DeepSeek V4 全面超越 Fable 5"。 但至少有一件事,越来越清楚了: 过去这几年,行业卷的是参数、训练数据和模型架构。 而 Agent 时代的下一场战争,很可能是: 谁能把模型已经拥有的能力,稳定地释放出来。 如果一个开源运行时插件,就能让同一个 DeepSeek V4 拉开十几个点的差距,那未来决定 Agent 实力的,可能不再是"你用了什么模型"。 而是: 你到底会不会用这个模型。
一、V4 最大的问题,可能不是"不够聪明"
二、J-Space 干的事,本质上是给 AI 配了个"项目经理"