ARTICLE · 978818
《神经网络与深度学习通识版》第三章习题选
《神经网络与深度学习通识版》第三章习题选第三章的内容更加具体,题目涉及的问题也更加细化,有针对性,选做的意义更大。估计不是一次能够做完了。 第二题: “ReLU 与 Logistic 的差别,不只是数学形式,更是一种设计哲学:从 “平滑、可饱和” 走向“简单、不饱和”.请分析这种转变如何解决了深度网络的梯度消失问题,又留下了哪些新的隐患(如死亡ReLU).” 也许是作者积淀非常多,层次比较高,在本书的多个章节中提出很多关于哲学的概念,多少让人有点不敢多说,就只当是特点、特性吧。 题目中说的Logistic函数,应该就是指用于二分类的sigmoid函数,计算公式为: 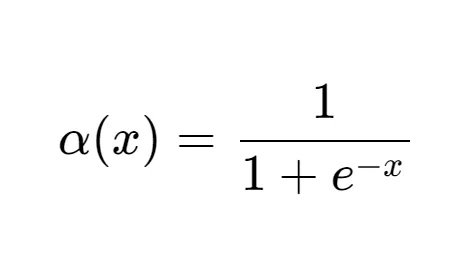
这个函数的值域为[0,1],相当于把任意实数压缩到(0,1)之间,并且该函数的导数为σ'(x)=σ(x)(1-σ(x)),因此导数的值域是在(0,0.25),无疑是平滑的,当x取值很大或者很小时,导数为0,这就是“可饱和”的现象,此时梯度很小,参数几乎无法更新优化。另外,如果采用Logistic函数作为深度网络的激活函数,那么梯度从输出层传回输入层的过程中,不断相乘衰减,数值很快就变得很小,这就造成了“梯度消失”的问题,靠近输入层的连接权重在训练过程中很难优化,网络无法学习到任何东西。 ReLU函数的形式就非常简单,f(x)=max(0,x),在x>0的区间,导数总是1,不会出现导数为0的饱和情况,计算负担也非常小;负值直接输出为0,这会起到一定的正则化效果,让网络学习结果更加鲁棒。 ReLU激活函数带来的问题是,如果某个神经单元输入总是负值的话,那么其输出总是0,对应梯度也是0,权重没法得到更新,这个神经元就相当于失去活性了。按照网上的说法,假如出现这种情况的神经元在总的网络中占比不超过20%,那么不仅不会对网络造成伤害,而且还起到一定的正则化效果,但是如果占比超过40%,那么模型的容量就会显著下降,训练的收敛速度也会变慢。因此,才会出现很多的ReLU的变种,试图解决其带来的问题。 第五题: “汇聚层既压缩了尺寸,又带来了平移不变性.但现代一些网络(例如Vision Transformer)几乎不用它,却依然效果很好.这是否说明汇聚不是必需的?它的角色在大模型时代发生了什么变化?” 这个题主要关注的是CNN的平移不变性的特点,主要是说在传统的卷积神经网络中,需要采用MaxPool或者AvgPool等汇聚层,一方面可以将特征图的尺寸减半,减少存储和计算量,另一个很重要的功能就是为整个网络增加平移不变性。虽然单个汇聚层每次计算只针对2x2的区域,但是经过多层汇聚操作后特征图对平移扰动的敏感度会下降很多。 但是在新的一些网络架构中,使用了Patch Embedding、Transformer和大量的训练时数据增强技术,替代了汇聚层所起到的作用,并且最终实践证明确实能够获得更好的学习效果。不过,和汇聚层直接采用单步计算完成直接的降维和特征提取不同,在新架构中,是通过注意力机制计算token之间的相关性,以及海量训练数据的平移等增强技术,让网络自己学习到平移不变性,并不是只依靠架构设计,直接赋予的。这种让网络自己通过学习发现的方式虽然更加灵活,可以应对更多不同的情况,但是所需要的训练数据量通常是原有CNN的10到100倍。 还有一点就是,在新的架构中,汇聚的功能或者说相关操作并没有完全消失,比如在Swin Transformer(对ViT的改进)中要执行 Patch Merging,这是把相邻4个Patch拼接后线性投影,其本质就是带步长的线性汇聚,它代替了MaxPool的位置。 还有就是在ViT最后一层,通常用对14×14个Token取平均(等价于平均汇聚)来得到整个特征图的表示,然后送入分类层。虽然这个汇聚是最终决策前的一步,而非中间层的逐级压缩,但是确实进行了汇聚操作。 另外,网上信息还提示,有人尝试在ViT中间层插入Pooling(如PoolFormer),效果也不错,但比较之后发现,ViT的长程依赖能力被削弱(因为局部聚合打断了全局视野),好的效果只出现在小数据集上,对于真正的大数据集,这种方式反而起到了反作用。