ARTICLE · 979741
RAG之文档分片与向量化工程实践
上一篇聊了文档从「收」到「转」,那之后紧接着的,就是切片和向量化。这篇接着往下讲。
我见过不少团队做 RAG,把最多的时间花在调 embedding 模型、换检索参数上。
但 embedding 是「照单全收」,你喂进去什么,它就编码什么。检索准不准,大头其实不在这里,而在更前面——文档到底是怎么被切开、怎么被存进去的。
先把结论放这:切片决定了检索的下限,而父子分段,决定了回答的上限。
01
一块一块切,再一条一条存
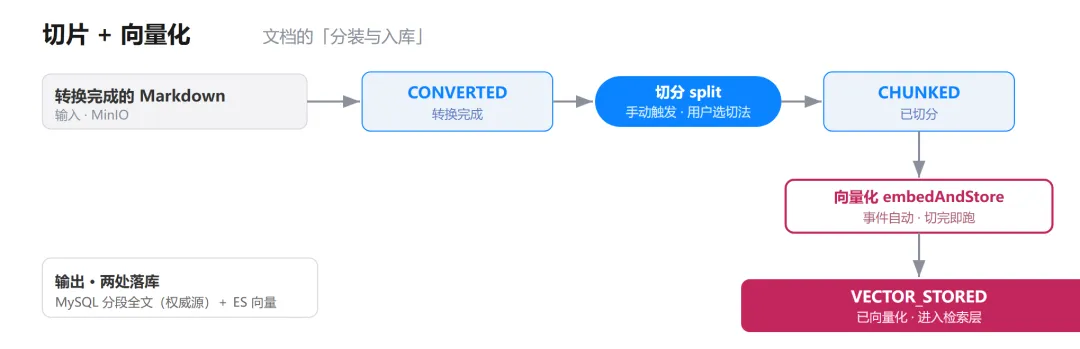
格式转换完,文档就到了一个新的状态 CONVERTED。从这往后是两步:先切,再存。
切,是把一大篇 Markdown 按规则劈成很多块,每块叫一个分段(section);存,是给每个分段生成一个向量,连同全文一起收进检索库。
这条链路里有个容易忽略的设计分歧。
切片是手动触发的。切法太多——按标题、按长度、按分隔符、按正则,选哪种得看文档结构和业务诉求,这种事系统不该替你拍板。
向量化则反过来,自动触发。切分参数一旦定了,剩下没有任何需要用户参与的决策,所以切完就让它自己跑,用户无感。
一句话:切的决策要交给人,后面的脏活累活交给系统。
02
检索和回答,要的是两种粒度
切文档第一个绕不开的矛盾,在这里。
检索,喜欢小块。块越小,语义越纯粹,向量越容易命中。
回答,喜欢整块。LLM 需要完整上下文,你只丢半句话给它,它只能瞎编。
只存大块,检索准不了;只存小块,答得差。这两件事天然打架。
我用的解法叫父子分段。简单说:切完之后,每个「超长小节」都会留下两份——一份完整全文,一份按窗口切成的小块。
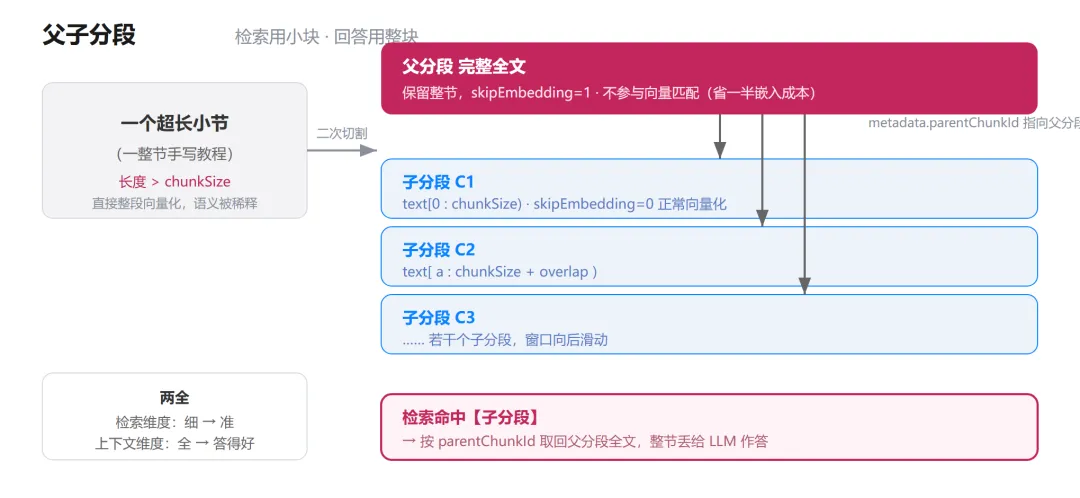
父分段存的是整节原文,但不参与向量匹配,所以不烧 embedding 的算力。真正去做向量、去参与检索的,是那些切出来的子分段。
用户问一句,系统用子分段的向量去命中;命中之后,顺着子分段上记的 parentChunkId,把父分段整节取回来丢给 LLM。
检索用小块,回答用整块,这两件事被拆给了两次查找。既准,又全。
03
五种切法,一个工厂
切多碎、按什么切,差别很大。我支持五种切分方式,由用户按文档特点挑。
切分方式 → 切分器 → 适合的文档
| TITLE | ||
其中最有意思的是自研的标题切分器——它其实在干一件很细的活:逐行扫描维护一个标题栈,识别代码块防止把代码里的 # 误判成标题,再把同一标题下的一整节聚成一个分块。
一个参数 titleLevel 控制粒度切到第几级标题:切到三级,分块就小;只切一级,分块就大。
至于 Excel、CSV,它们不走这条路。非文本文件在切分入口被单独拦下,按行结构切,每行数据一个分段——表单逐字段检索,靠的是这个。
所有切分器都挂在一个工厂后面。新增一种切法,只加一个实现类加一个分支,老代码一行不动。
04
向量化,交给事件驱动
分段落库之后,下一步是给每一段生成向量、写进检索库。这部分全自动。
切分事务提交时发布一个事件,监听器接住之后,才开始干活。这里有个很典型的坑,值得单独拎出来说。
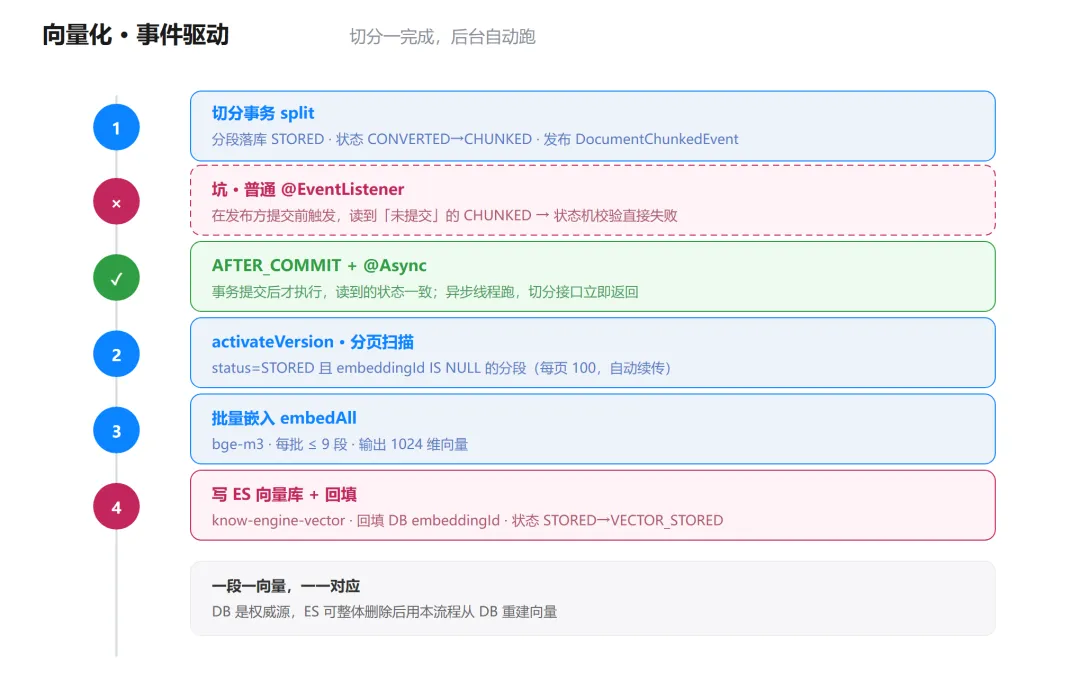
如果监听器用的是普通 @EventListener,它会在发布方的事务提交之前就被触发。此时异步线程去查库,读到的是还没提交的数据——状态还停在 CONVERTED,向量化的状态机校验直接失败。
换成 @TransactionalEventListener(AFTER_COMMIT),保证事务提交完才执行,读到的状态才一致。
再叠加 @Async 异步化——调 embedding、写 ES 都是慢操作,不该让切分请求陪着等。切分接口立刻返回分段数,向量化在后台慢慢跑。
嵌入是分批做的,分页扫,每批封顶 9 段,模型用 bge-m3,输出 1024 维。写进 ES 后把返回的 embeddingId 回填回数据库,一段一向量,一一对应。
05
每一块,都带「出身证明」
光有文本和向量还不够。每个分段还要挂一串元数据,记录它「从哪来、属于谁、能不能被谁看见」。
chunkId 是它的身份证;parentChunkId 指向父分段;headerLevel 记它落在几级标题下。
再往下是业务字段:docId 属于哪份文档,version 属于哪个版本,accessibleBy 谁能查它。
这些元数据同时存两份:MySQL 里是权威副本,ES 里是检索过滤器。画在纸上是「数据冗余」,干起活来是「删一个文档能连根拔掉它的所有向量」。
有了一段的「出身」,按文档删、按版本查、按权限卡,就都有了抓手。
这也是为版本切换铺路——不同版本的分段能共存,切换生效版本本质上是对向量库做一次定向重写,而不是删库重传。
06
三个我反复权衡过的取舍
这几个决策我都来回掂量过,各说一句为什么。
第一个,向量化为什么分页批处理,而不是一次全查。
大文档的分段能到几千条,一次全载进内存压力大;embedding 单批又有 9 段的上限,本来就得分批。
更重要的是,扫描条件里带着「embeddingId 为空」,已经处理完的段自然退出扫描——中断了重跑,自动续上,不重复不遗漏。
第二个,删除和写入的失败,处理方式不一样。
删向量失败,只记日志、不上抛——数据库是权威源,残留的向量之后可以整体重建清理,不该让一次删除把主流程带崩。
写入向量失败,则必须上抛,还要断言「写入的向量数量 = 分段的条数」。写不完整检索就缺内容,这种错不能静默吞掉。
第三个,为什么数据库是权威,ES 能被重建。
一旦认定了 ES 只是检索层,很多事就松绑了:向量出了问题,把一个版本整体失活,再从数据库里扫出来重新嵌入一遍就行。
权威源放在可控的一边,重建能力放在出错的一边,系统才扛得住折腾。
一
最后
回到开头那句话。
切片是「把会变的东西单独拎出来」——切法会越来越花,工厂的骨架不用动。向量化是「把定了的东西稳稳送进检索」——粒度、维度、幂等、重建,该挡的都在前面挡好了。
父子分段把「检索要细、回答要全」这个两难,拆成了两次查找。
一句话:切得准不一定答得好,但切得不好,后面调再多都白搭。
下一篇,讲向量建好之后的检索与问答——query 是怎么打到这些小块上的,命中了父分段,又是怎么被拼回一段完整的答案。