ARTICLE · 982905
没装向量数据库,我把 CATIA 开发文档做成了 AI 技能包
RAG 必须上向量数据库?
没装向量数据库,我把 CATIA 开发文档做成了 AI 技能包
零成本 · 免显卡 · 本地毫秒级检索
楼兰的AI实战笔记
📦 5 Parts + Conclusion
👉 滑动
PART 01
三个坑
直接喂文档
PART 02
换思路
原生技能
PART 03
五步逻辑
生成流程
PART 04
高频场景
实测效果
PART ///
写在最后
边界与思考
AI 不是不会写 CATIA 代码,是它从来没真正读到过那份手册。
上个月,我让 AI 写一段 CATIA 自动出工程图 的代码。它秒回,长得特别专业。我复制进 VBA 编辑器,F5——编译错误。
类名是编的,参数顺序是猜的,中间还夹着一行 (cid:1)。
问题不在模型。问题在我:我把一份几百页的英文 PDF 直接丢了过去。
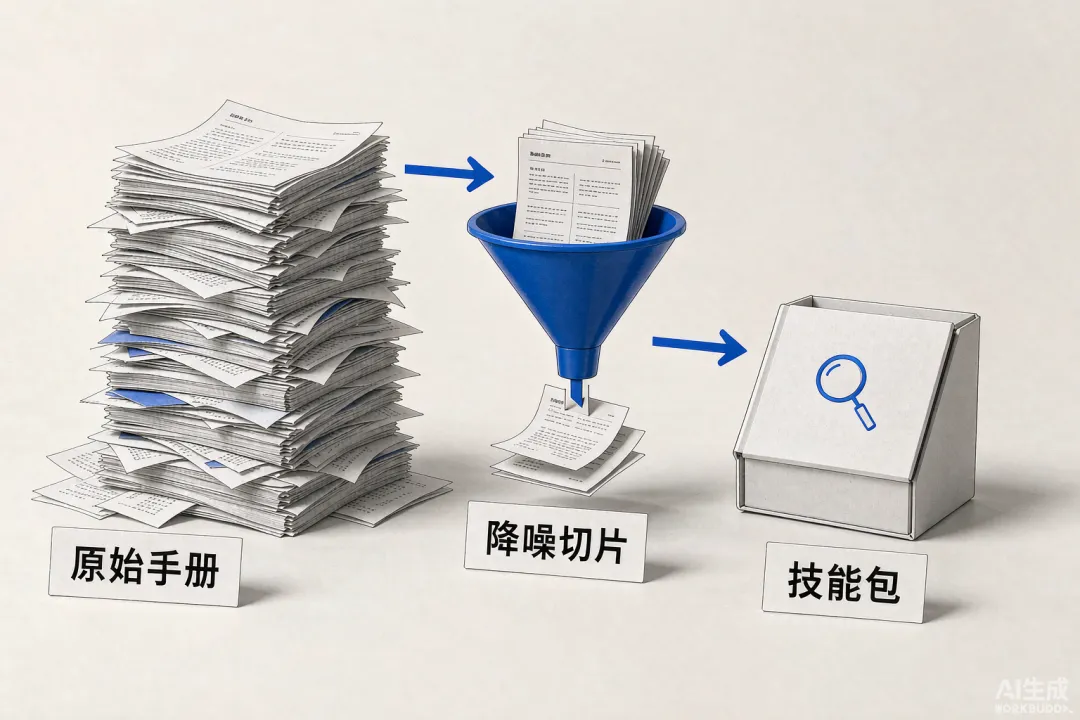
后来我换了个做法——不搭向量数据库,不装 PyTorch,不调用任何 Embedding 接口,把整套 CATIA 开发文档压成了一个本地原生的 AI 技能包。现在 AI 写出来的代码,能直接跑。
这篇把过程拆开讲。
01
PART
先说清楚:直接喂文档,会踩哪三个坑
THREE PITFALLS · 为什么不能把 PDF 直接丢给 AI
1. 上下文刷爆,关键信息「迷失在中间」
几十万行的 API 手册塞进 Prompt,先不谈账单,模型会直接报超长。就算它支持超长上下文,还有个更隐蔽的问题——Lost in the Middle:信息放在长文本中段时,模型的召回率会断崖式下跌。
而你最想找的那个 API 说明,恰好就在它最容易忘的位置。
2. 脏数据喂出幻觉代码
PDF 转出来的文本,页眉、页脚、版权声明、乱码符号全糊在一起。AI 读了这些脏数据,会一本正经地生成不存在的类名——因为它「见过的」文本里,那些符号本来就是坏的。
AI 不会告诉你它不知道,它只会编一个很像的答案。
3. 跨模块串味,代码根本跑不起来
这是 CATIA 二次开发特有的坑。零件、装配、工程图三个环境下,同名方法的含义完全不同。不做隔离,你想拉伸实体,它给你工程图表格的列宽拉伸方法——语法全对,环境全错。
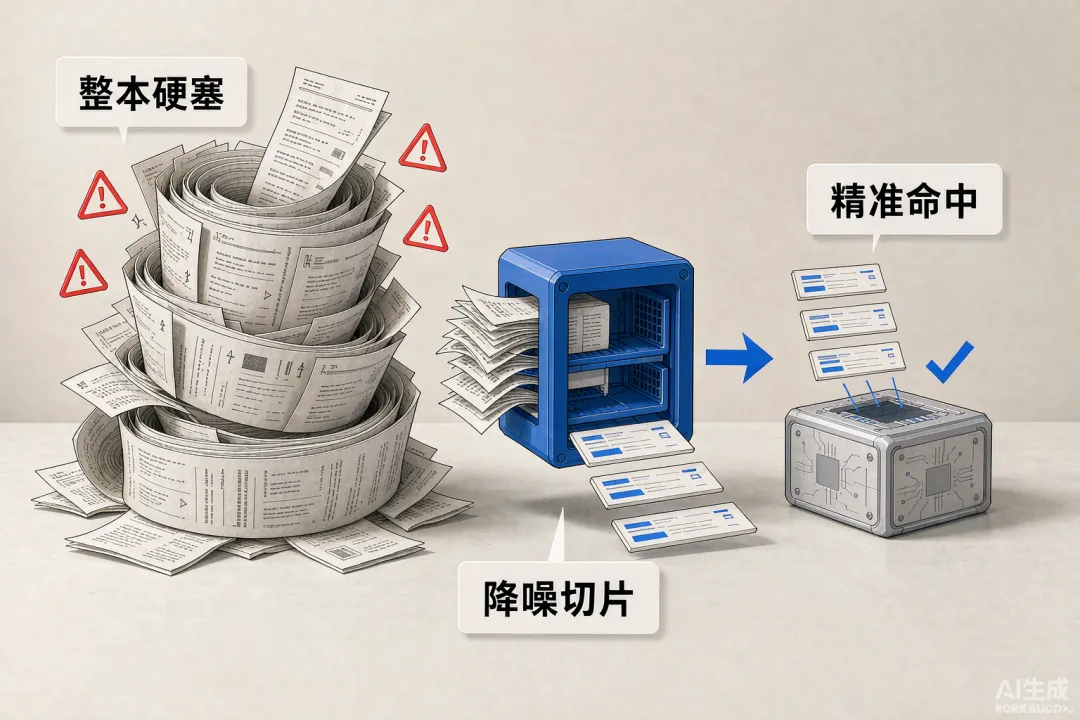
— 左:整本硬塞,三重警告;右:降噪切片后精准命中
02
PART
换个思路:不检索向量,检索「原生技能」
CORE IDEA · 从传统 RAG 到原生 Skill
传统 RAG 的路径是:切片 → 向量化 → 存向量库 → 相似度检索。这条路在工业设计的办公电脑上很难走通——langchain、chromadb、torch 这几个库,在 Windows 上经常因为缺 C++ 编译器、CUDA 版本冲突、依赖版本死锁而装不上。
我换了个更轻的路子:把文档变成一个会自己检索的技能。
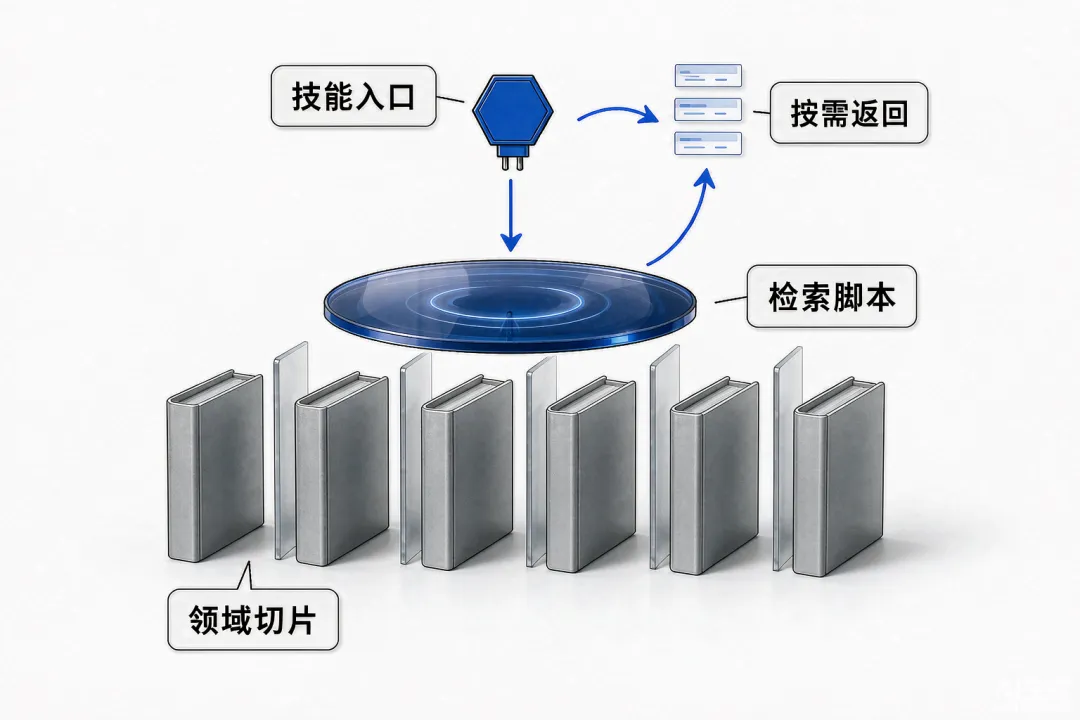
— 技能包架构:五份领域切片 + 检索脚本 + 技能入口
结构极简:五份按业务领域物理隔离的 Markdown 文件,加一个不到两百行的 Python 检索脚本,外面套一层技能描述文件。没有数据库,没有服务,没有模型,只有一个文件夹。
03
PART
五步生成逻辑
WORKFLOW · 从 PDF 到可调用技能
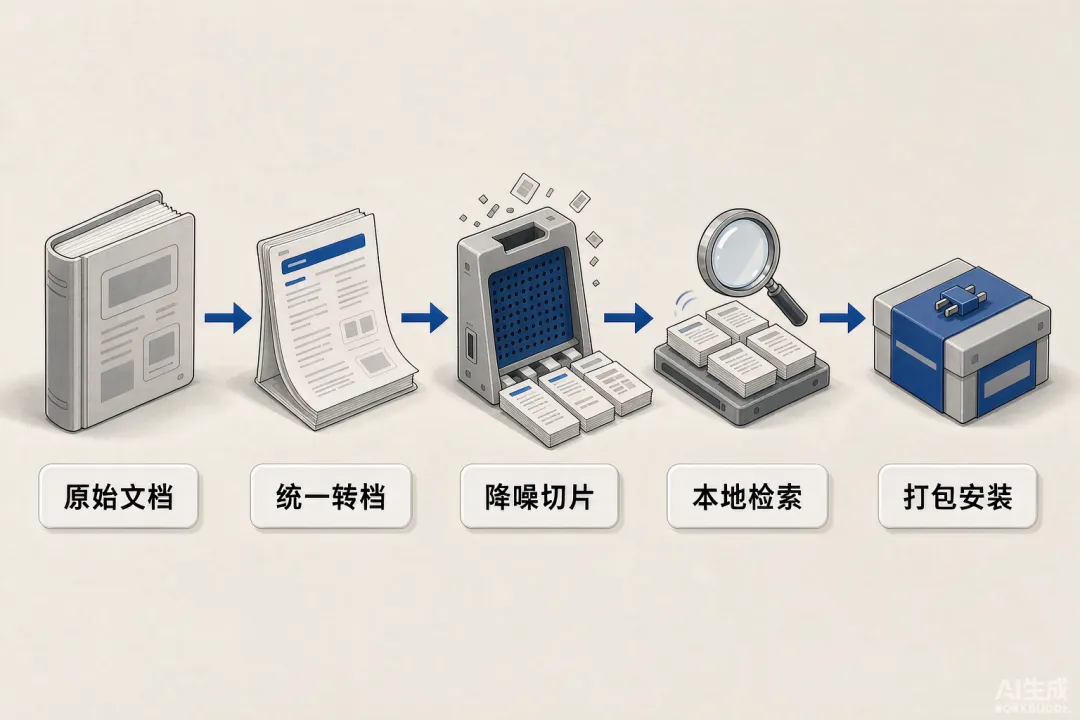
— 五步流水线:原始文档 → 统一转档 → 降噪切片 → 本地检索 → 打包安装
把 PDF 统一转成 Markdown
用 markitdown[pdf] 一把梭。选 Markdown 不是图省事——它天然保留标题层级、代码块和数据表格,这是 LLM 最容易解析的半结构化格式。
pip install "markitdown[pdf]"
markitdown input.pdf -o output.md
降噪,再按业务领域切片
降噪比想象中重要。页眉页脚、页码、(cid:1) 这类转换残留全部清掉——每 Token 里装的核心信息越多,AI 的回答越准。
切片不按字数硬切,按 CATIA 的物理业务领域切:
按业务物理隔离,是防止跨模块串味最有效的一招。
写一个不需要向量的检索器
search_kb.py,纯标准库,靠三条加权规则打分:
标题加权:命中 Markdown 的 H2/H3 标题,权重直接 ×15
API 特征加权:查询词带 . 或 _(比如 .Selection),判定为 API 调用,额外精准加权
词距加权:关键词挨得越近,得分越高
毫秒级返回,不加载任何深度学习库。
渐进式加载——省 Token 的关键在这里
技能描述文件里写清楚触发词。只有你提到 CATIA、VBA 这些词,技能才会被加载。
加载后也不会把几万行文档一次性吞下去,而是先跑检索器,只取最相关的 top-3 段落(约 100–200 行)塞进上下文。
平时零占用,提问才激活,按需精准加载。
校验、打包、装进命令行
清掉残留的 TODO,打包成 .skill,一键装到全局技能目录。至此,AI 多了一个「自己会查手册」的能力。
04
PART
装上之后,四个高频场景的变化
USE CASES · 实测效果对比
查复杂 API 语法
忘了旋转槽 Groove 的方法名和参数顺序?AI 直接命中 part_design.md,给出强类型变量赋值的标准写法,不用翻英文手册。
治「红色感叹号」
B-Rep 引用裂变是 CATIA 二次开发最头疼的问题——三维特征一改,面和边的引用路径就断,后续装配约束全部失效。AI 会检索 common_patterns.md,自动套用 Publication(发布) 这套鲁棒性设计模式,让代码不随几何变动而断裂。
批量出图与 BOM 表
drafting_design.md 里直接给出 DrawingTables 的单元格合并、列宽设置、文字对齐整套代码,省去手动查手册的时间。
防卡死与僵尸进程
AI 会在脚本头部自动插入 CATIA.RefreshDisplay = False,尾部恢复,外进程退出时做标准的 COM 显式释放。上千个点的循环不再把 CPU 跑满,后台也不再残留 CNEXT.exe。
05
PART
这套方案的边界
LIMITATIONS · 它不是万能的
它不是万能的,先把话说在前面:
词频匹配 ≠ 语义匹配
你用大白话描述功能、一个 API 关键词都不提,效果会明显下滑。提问时把类名、方法名带上,命中率最高。
知识库是静态的
新版本 API 更新后,得重跑一遍转换流程。
降噪规则是定制的
换一批源文档,页眉页脚样式可能不同,规则要跟着调。
性价比极高。
∞
LAST
写在最后
TAKEAWAY · 核心思考
很多人觉得 RAG 一定要上向量数据库、一定要有 Embedding。可在垂直领域里,用业务知识做物理隔离,往往比用向量做语义相似度更管用。
你不需要一个更聪明的检索算法,你需要一个更干净的切片。
我是 楼兰的AI实战笔记,探索AI前沿技术,分享实战经验,让智能落地每一步。
如果今天这篇对你有启发,点个赞、转发给做二次开发的同事,我们下篇见。
还没关注?点击文末「楼兰的AI实战笔记」头像旁的「关注」按钮,即可第一时间收到更新。
THANKS FOR READING