ARTICLE · 986791
AI Agent Skills 哪家强?(二)
上一篇我们聊了一个看起来很简单的问题:Skills 到底是什么?
最后我给它下了一个不太官方的定义:
Skill,就是把一套“人类知道怎么做”的经验、规则和工作流程,封装成 Agent 可以发现、理解、加载并执行的能力模块。
但问题马上就来了。
既然 Skill 是一种“能力模块”,那 Agent 到底是怎么把它用起来的?
是启动的时候,把所有 Skill 全部塞进上下文吗?还是用户明确输入 /code-review 才会加载?如果一个 Agent 有 100 个甚至 1000 个 Skill,它又怎么知道当前任务应该用哪个?Skill 加载以后,又是怎么影响模型行为的?
这些问题,其实就是我研究 Claude Code、OpenClaw、Codex 等 Agent 时,越来越感兴趣的地方。
因为看到这里会发现,真正复杂的,可能从来不是那份 SKILL.md。
而是它背后的这一整套东西。
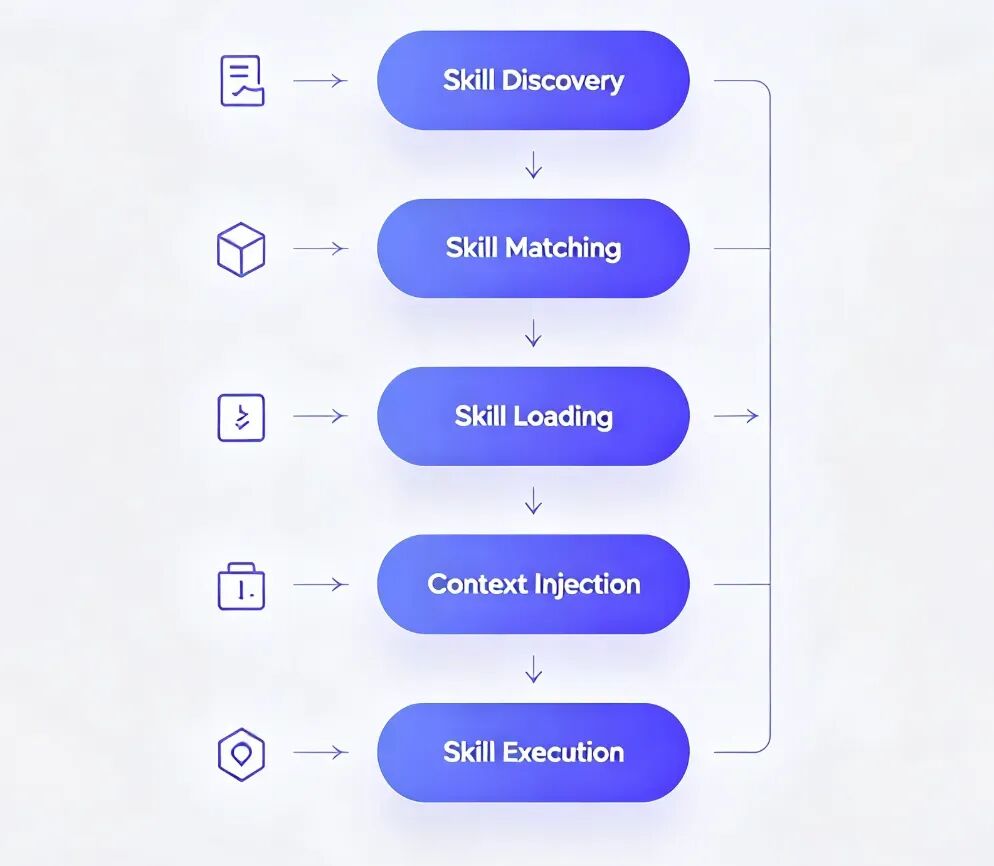
换句话说:Skill 是一本技能手册。
而 Skills Runtime,才是那个负责“什么时候把哪本手册递给 Agent”的人。
场景引入
为了让这件事情不那么抽象,我们先假设一个场景。
我打开 Agent,然后说:“帮我 Review 一下这个 Go 项目的 PR,重点看看有没有并发安全问题和错误处理遗漏。”
这句话看起来很普通,但如果是一个拥有 Skills 的 Agent,它背后可能已经开始忙起来了。
假设现在它有这些 Skill:
skills/├── code-review/│ └── SKILL.md├── go-development/│ └── SKILL.md├── python-development/│ └── SKILL.md├── pdf-analysis/│ └── SKILL.md├── kubernetes/│ └── SKILL.md└── database/ └── SKILL.mdAgent 第一反应不是:“来,把这 6 个 Skill 全给我。”
而更像是:“先看看我有哪些技能,再找找谁和这个任务最匹配。”
于是,一个完整的 Skill 生命周期就开始了:
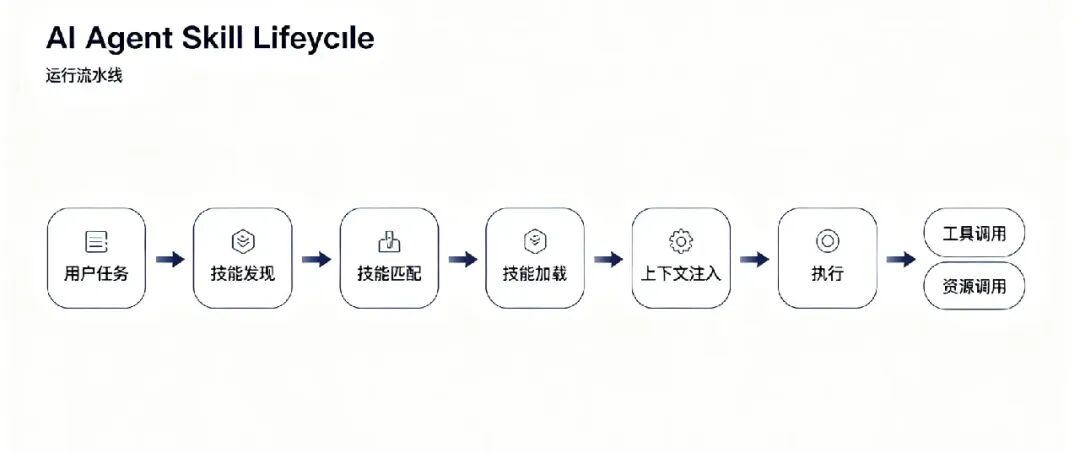
你可以把它想象成一个人在公司里工作的过程。
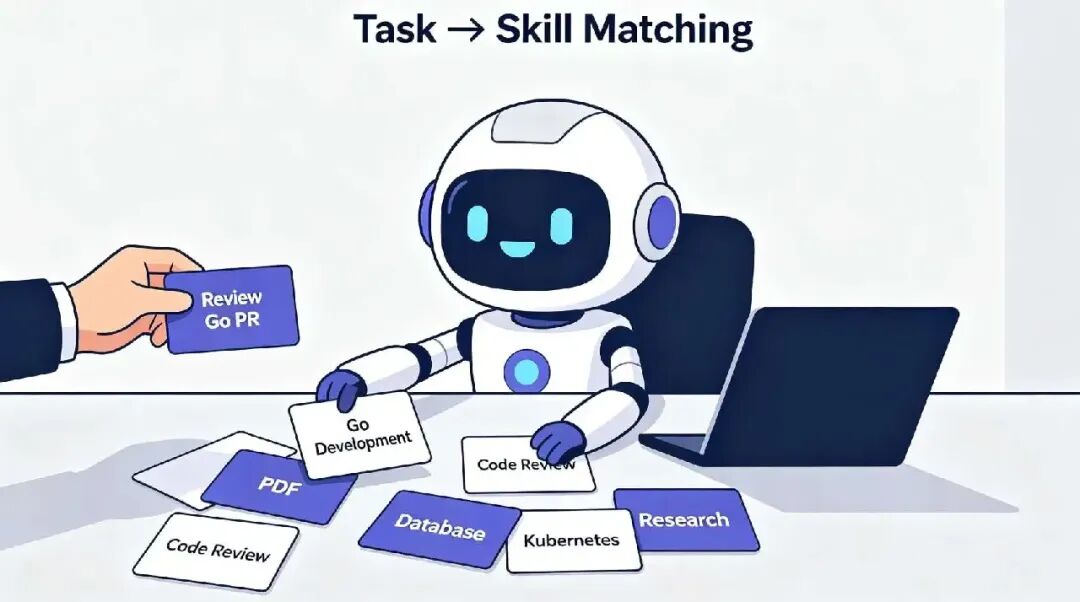
老板说:“小王,帮我 Review 一下这个 PR。”
小王不会先去把公司所有制度都读一遍。
他更可能先想:“这个活儿应该属于代码 Review。”
然后从自己的资料柜里抽出那本《代码 Review 操作手册》,这本手册,就是 Skill。
Agent如何知道自己有什么技能?
很多人第一次接触 Skills,会直接跳到:“Skill 文件到底怎么写?”
但我觉得更应该先问:Agent 怎么知道这个 Skill 存在?
这一步可以叫:
Discovery
也就是 Skill Discovery,能力发现。
例如一个 Agent 启动以后,它可能发现:
code-reviewdescription:Review code changes for correctness, security and style.pdfdescription:Analyze and extract information from PDF documents.databasedescription:Analyze SQL queries and database schemas.注意这里有一个非常重要的细节:
它看到的可能并不是完整 Skill。
它首先知道的只是:
名字+描述+位置这就像你去图书馆。
管理员不会把每一本书全部打开给你看。
她可能只告诉你:
《Go并发编程》《数据库原理》《Kubernetes实战》《代码审查指南》然后等你真的决定看哪一本,再把书拿给你。
这就是 Skills 设计里面非常重要的一个思想:
先知道能力存在,再决定要不要读取能力详情。
Claude Code 当前的文档就明确采用了这种模式:默认情况下,Skill 的名称和描述在会话开始时进入上下文,而完整 SKILL.md 内容只在 Skill 被调用时加载。
Codex 也采用类似的渐进式披露方式:初始上下文主要包含 Skill 的 name、description 和路径,真正选中某个 Skill 后再读取完整 SKILL.md。同时,Codex 还会给初始 Skill 列表设置上下文预算,避免 Skill 数量太多把模型的上下文挤满。
所以你会发现:
Discovery解决的不是“把 Skill 读进来”,而是“让我知道它存在”。
这其实是一个很重要的区别。
有100个Skill,Agent怎么知道该用哪一个?
现在假设 Agent 发现自己有:100个Skill
而你的任务只有一句:“帮我 Review 这个 Go PR。”
这时候总不能随机抽签。
于是第二个环节来了:
Matching
也可以理解为:Task 和 Skill 的匹配。
最简单的方式,就是看 Skill 的 description。
比如:
---name:code-reviewdescription:Reviewsourcecodechangesforcorrectness,security,performanceandmaintainability.---而用户任务是:
Review this Go PR.Check concurrency safety and error handling.两边在语义上明显高度相关,于是 Agent 很容易判断:
User Task ↓“Review PR” ↓code-review这也是为什么我越来越觉得:description 并不是 Skill 文件里随便写的一句话。
它更像是 Skill 的“简历”。
你写得越模糊,Agent 越不知道什么时候该找你。
比如:
description: Helps with code.这种描述,就很像一个人在简历上写:“我什么都能干。”
听起来很厉害,实际上谁都不知道什么时候该找你。
而:
description:Review pull requests and source-code changes,especially for correctness, concurrency, security,error handling and test coverage.就非常明确:“这个活儿,找我。”
Claude Code 的文档甚至明确提醒:模型会根据 Skill description 判断什么时候使用 Skill;如果多个 Skill 的描述过于模糊或者彼此重叠,就可能选错或者漏掉相关 Skill。
Codex 对这一点同样强调:description 是 Skill 触发的重要依据,需要同时描述“它做什么”和“什么时候应该使用”。
所以到这里,我们已经得到了一个非常有意思的抽象:
Skill │ ├── Name ├── Description ← 帮助 Agent 找到我 └── Body ← 真正告诉 Agent 怎么做也就是说:
Description 像门牌号。SKILL.md Body 才是房间里的东西。
找到Skill了,怎么用?
现在 Agent 已经确定:“这个任务需要 Code Review Skill。”
那么接下来怎么办?
就是:
Loading
也就是 Skill Loading。
这是 Skills 体系里特别重要的一步。
因为到这里才真正发生:
SKILL.md ↓读取 ↓进入 Agent Context假设我们的 Skill 长这样:
code-review/├── SKILL.md├── references/│ └── go-review-checklist.md├── scripts/│ └── review.sh└── assets/Agent 并不一定需要一次性把:
SKILL.mdreferences/scripts/assets/全部读完。
更合理的方式是:
先加载核心说明 ↓发现需要参考资料 ↓读取对应 reference ↓需要执行脚本 ↓调用 script这就是:渐进式披露,Progressive Disclosure。
目前 Codex 的公开 Skill 设计甚至把它明确拆成三级:
Level 1MetadataLevel 2SKILL.mdLevel 3Bundled Resources也就是:先看简介,再看操作手册,最后按需翻附录。
这其实特别像现实中的工作。
你新入职一家公司的时候:
第一天,人事给你一个员工手册目录。
第一周,你拿到岗位说明。
真的碰到数据库问题时,你才去翻数据库规范文档。
没人会第一天把公司 Wiki 全打印出来交给你。
Skill不是“读过就算”,还有模型的工作上下文
这是很多人第一次理解 Skill Runtime 时最容易忽略的地方。
假设 Agent 已经读取:
code-review/SKILL.md但它只是把文件看了一眼,然后什么都没发生。
那 Skill 有什么意义?
所以接下来必须发生:
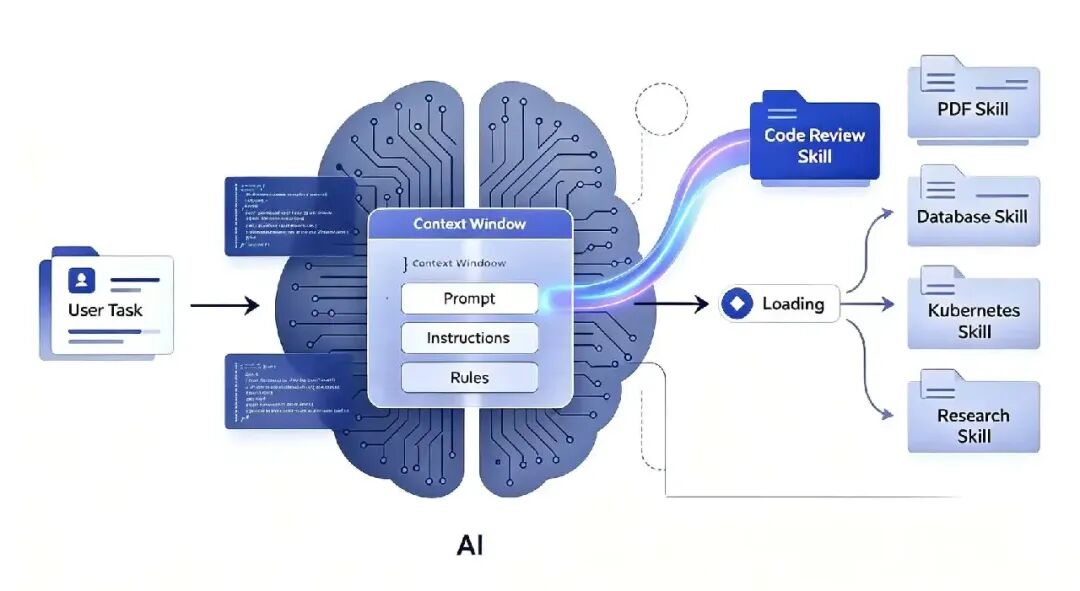
Context Injection
也就是把 Skill 的 instructions 真正放进模型当前的工作上下文。
例如原本模型看到的是:
User:帮我 Review 这个 Go PR。加载 Skill 后,模型实际获得的信息就可能变成:
System / Context你现在拥有 Code Review Skill。执行时请:1. 先理解修改范围2. 检查核心逻辑3. 检查并发安全4. 检查错误处理5. 检查测试覆盖当前任务:Review 这个 Go PR。于是原本只是:“帮我 Review。”
现在变成:“按照 Code Review 的专业流程,帮我 Review。”
这就是 Skill 真正开始发挥作用的时刻。
Claude Code 的设计很典型:Skill 被调用后,其 SKILL.md 内容会作为消息进入当前对话上下文,并在后续轮次继续保留。
这件事情其实特别重要。
因为Skill 并没有重新训练模型。它只是在当前任务里,临时给模型增加了一份“工作经验”。所以我前面才会说Skill 本质上仍然是 Prompt 的演进。
只是这一次,Prompt 不再是随手粘贴的一句话。
它变成了:可发现、可加载、可复用的能力模块。
到了这里,Skill才真正开始“干活”
现在 Agent 已经:
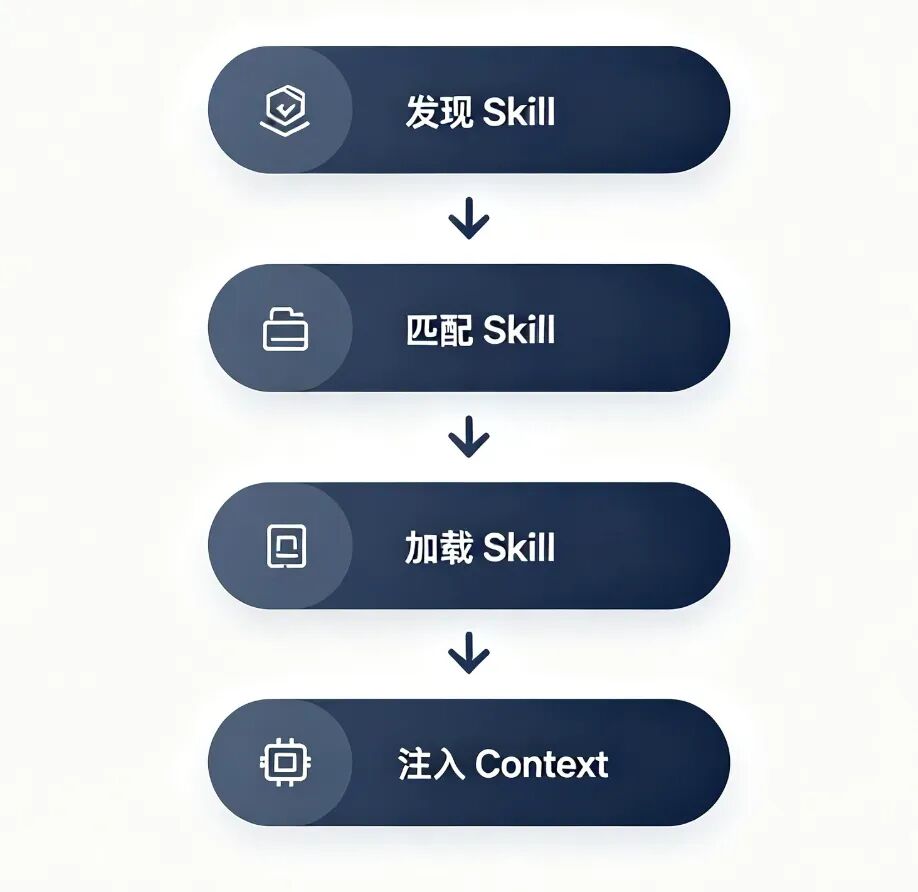
最后一步,就是:
Execution
这个时候,Skill 本身其实没有神奇地变成一个程序。
它真正做的事情是:改变 Agent 的决策方式。
例如 Skill 告诉 Agent:
第一步:检查 Git diff。第二步:寻找潜在的数据竞争。第三步:检查 error 是否被正确处理。第四步:运行测试。第五步:给出 Review。而 Agent 再根据这些指令:
调用 read_file调用 grep调用 exec调用 test所以最终会变成:
Skill ↓指导 AgentTool ↓执行动作这就是为什么:Skill 和 Tool 从来不是一回事。
Tool 是手,而Skill 是做事的方法。
Agent 则是那个真正负责思考“我现在应该先用哪只手干什么?”的人。
Skill并不是一次加载、一次执行就结束了
如果只看到这里,很多人可能会以为:
加载 Skill↓执行↓结束其实复杂一点的 Agent Runtime,不会这么简单。
因为真实任务往往是:
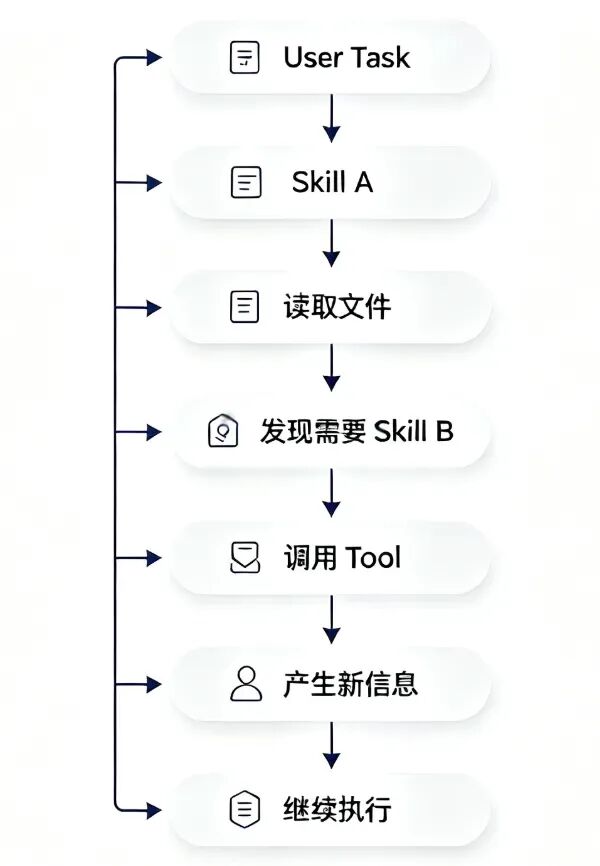
于是整个过程开始变成一个循环。
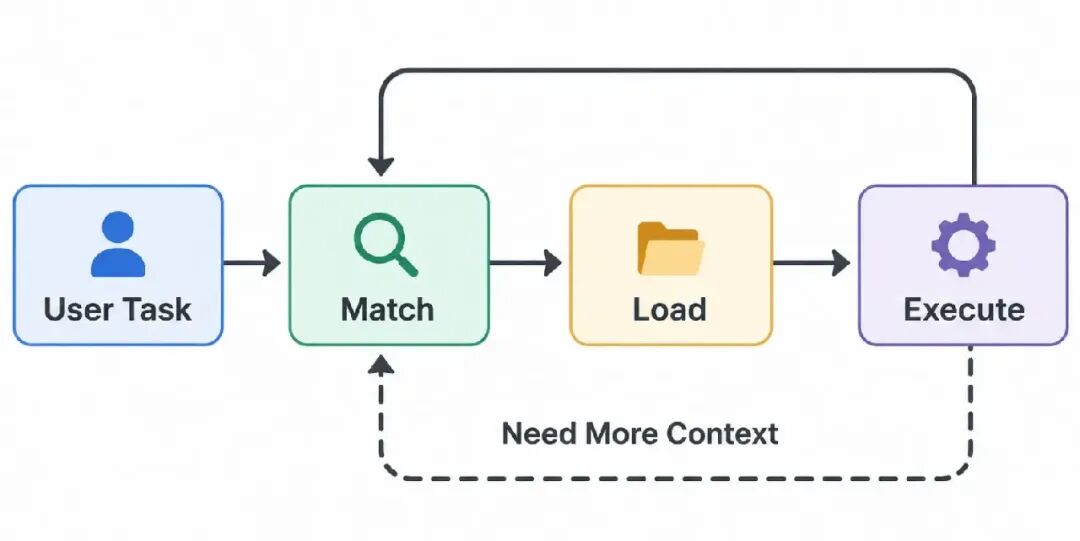
这时候 Skill 就不再是一段静态 Prompt,而开始变成:Agent Runtime 中的一种动态能力。
这也是为什么现在研究 Skills,真正有意思的部分已经从 SKILL.md 本身,慢慢转移到了:
SkillLoaderSkillRegistrySkillMatcherSkillContextSkillRuntime如果Skill很多,Runtime应该怎么办?
这是我觉得 Skills 系统真正进入工程阶段的一个标志。
假设一个 Agent 有10 个 Skill 其实挺简单,但如果以后变成1000 个 Skill怎么办?
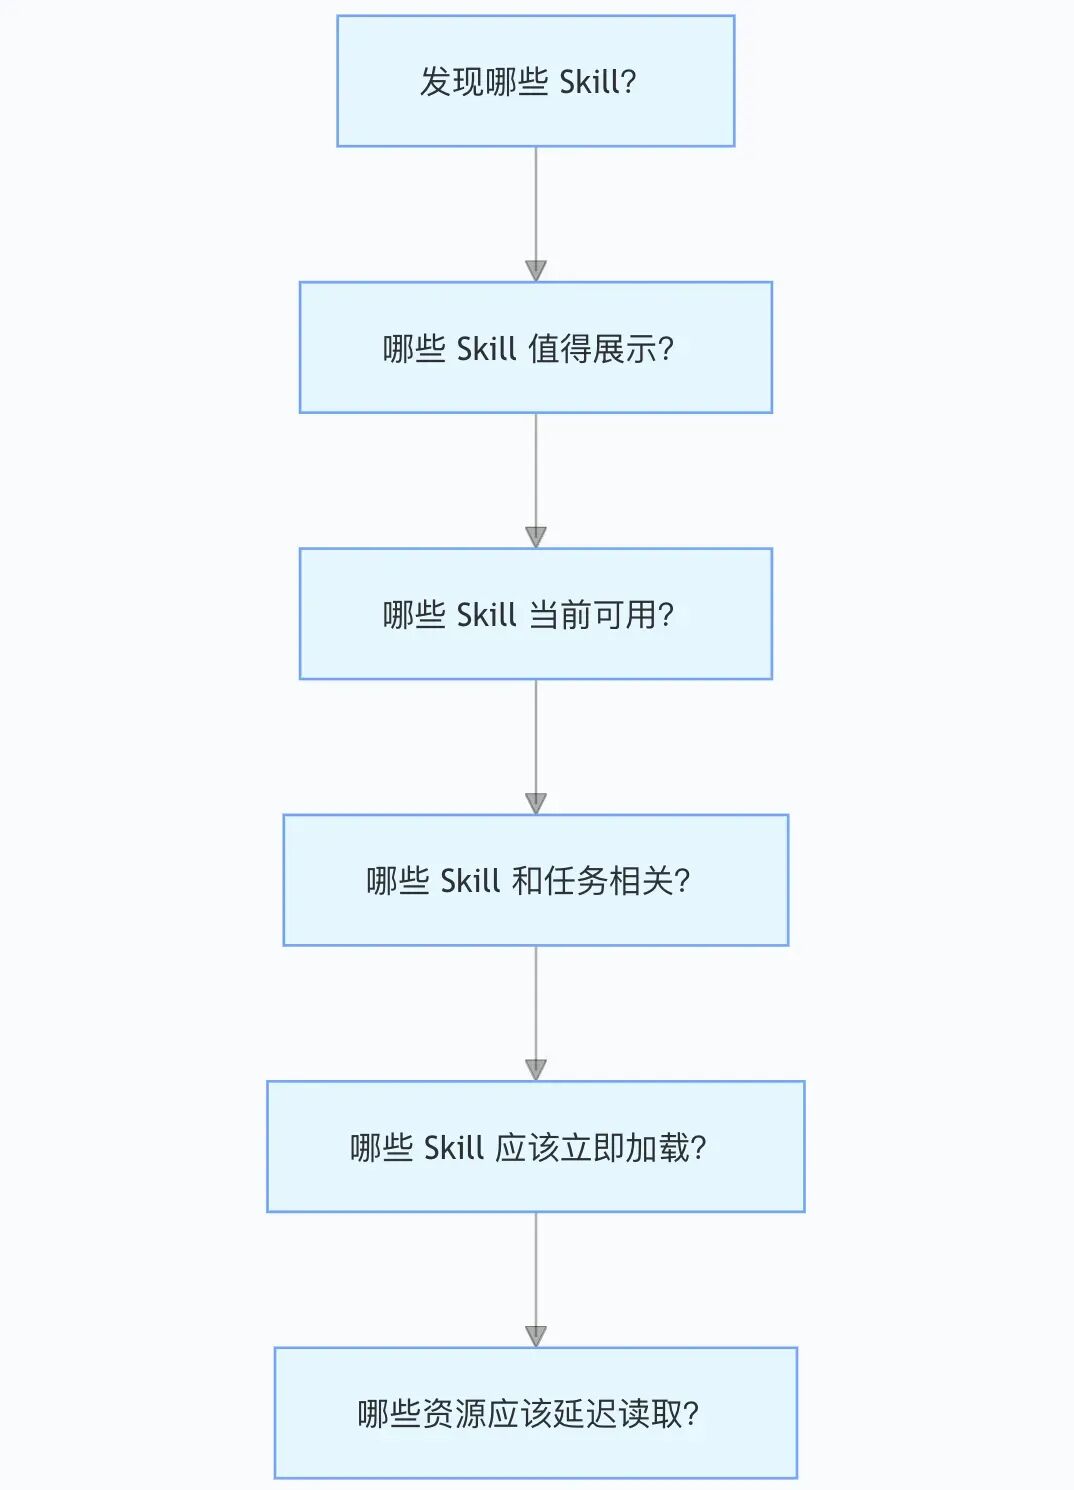
我们不可能1000个Skill全部丢给模型,因为上下文迟早会被撑爆。
所以一个真正成熟的 Skill Runtime,大概率要解决几个问题:
于是,我们开始看到一些越来越像传统软件工程的东西:
Skill RegistrySkill ResolverSkill MatcherSkill LoaderSkill CacheSkill Runtime这时候你会发现:
Skills 本质上已经从“Prompt 文件”开始走向“软件组件”。
Codex 就已经把 Skill 的初始展示做了上下文预算控制:它会限制初始 Skill 列表占用的上下文空间,并在 Skill 很多时压缩描述或省略部分条目。
而 OpenClaw 这类 Agent,则进一步把多来源 Skill、优先级以及运行环境筛选等问题纳入 Skill 管理。
换句话说:
当 Skill 数量开始变多,Skill Runtime 就变得和 Skill 本身一样重要。
试着抽象出一个真正完整的Skills Runtime
如果让我现在自己设计一个 Skills Runtime,我大概会画成这样:
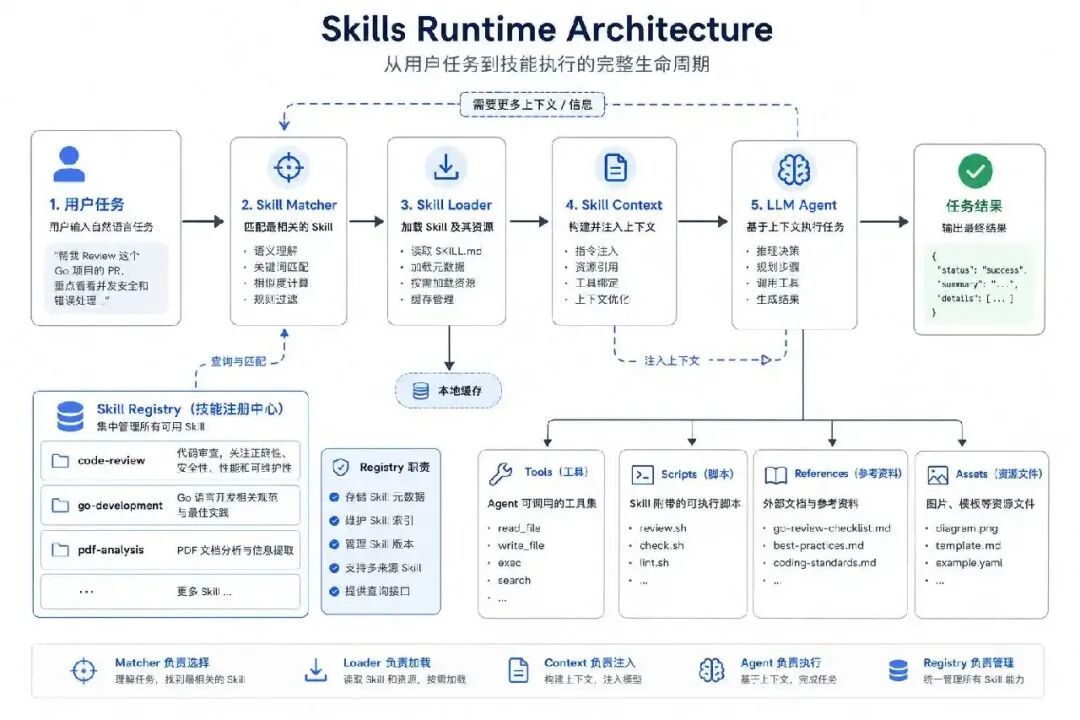
到了这里,我觉得 Skills 的轮廓已经非常清晰了:一个 Skill 并不是一个 Prompt。
更准确地说:Skill 是 Runtime 可以管理的一种 Agent Capability。
研究 Claude Code、Codex 等实现的时候,我越来越觉得虽然大家具体代码完全不同,但大方向其实非常接近。
Claude Code 现在明确采用“描述先进入上下文、完整 Skill 按需加载”的方式,同时支持手动调用、模型调用控制以及 subagent 场景下的预加载。
Codex 同样把 Skill 设计成模块化目录,并采用 Metadata → SKILL.md → Bundled Resources 的渐进式披露思路。
所以我现在看 Skills,已经不太喜欢单独看:
SKILL.md而更喜欢把它放到整个生命周期里:
SKILL.md ↓Discovery ↓Matching ↓Loading ↓Context Injection ↓Execution这才是一个完整的 Skill。
小总结
如果说第一篇是在回答 Skill 是什么
那么这一篇真正想回答的是:Skill 是怎么活起来的?
答案其实已经比较清楚:
发现 ↓匹配 ↓加载 ↓注入 ↓执行而这条链路里,每一步都值得单独研究。
尤其是:
SkillLoaderSkillRegistrySkillMatcherSkillContextSkillRuntime这些东西,才是我接下来真正想深入看的地方。
因为当我第一次看到一个 SKILL.md 的时候,我觉得: “这不就是个 Markdown 吗?”
但看到今天这里,我反而觉得真正有意思的,从来不是这本手册写了什么。而是 Agent 为什么在这一刻,决定翻开这本手册?
这可能才是 Skills 最值得研究的地方。