ARTICLE · 987532
不露脸、不买设备、不剪片:4 个 AI 工具组队,20 分钟做出一条口播视频
说实话,做口播视频这事儿,劝退过我很多次 😮💨
要么得自己上镜(灯光、背景、还得状态在线);要么得会剪片(转场、字幕、卡点); 要么得掏钱买设备(相机、麦克风、补光板,一套下来小几万)。最后的结果通常是—— 设备买了一堆,视频一条没发。
但现在这套流程真的变了。今天不聊虚的,就给你演示一件事: 一条完整口播视频,怎么用 4 个工具组队"拼"出来。 分工明确,谁都不闲着。
一、先认识一下这 4 位"团队成员"
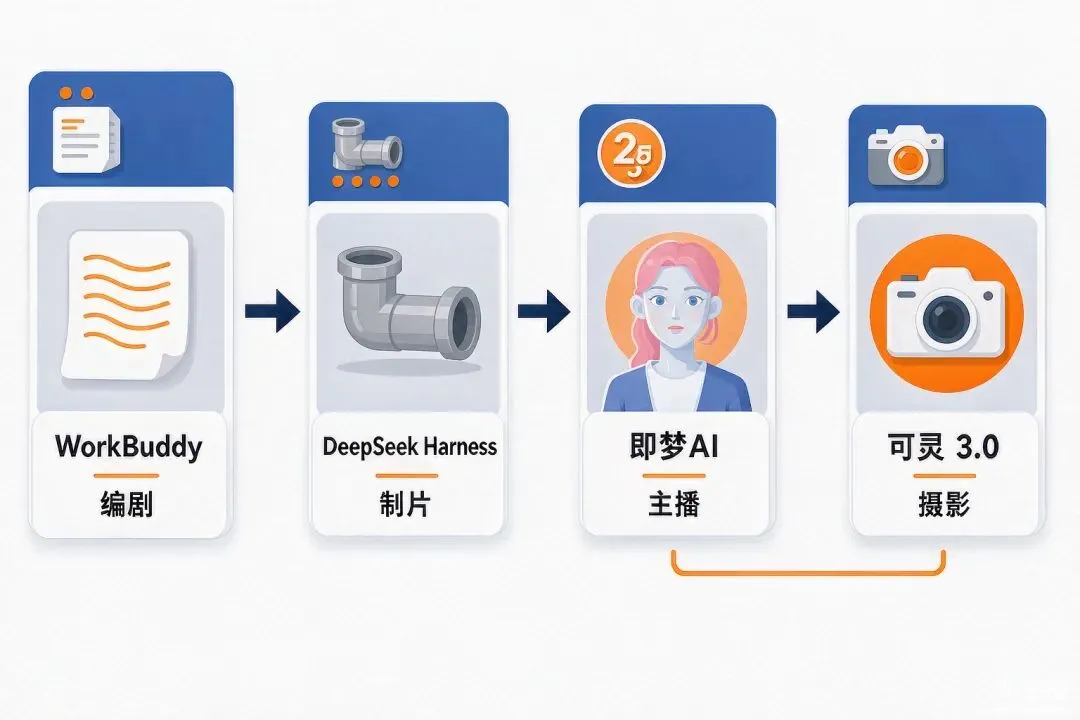
组队之前得先认人。这 4 位各管一段,谁也不抢谁的活 👇
🎬 ① WorkBuddy —— 编剧 + 场务
装在你电脑里的桌面 AI 助手。它不上镜,但它写剧本、出分镜、整理素材、跑全流程调度。 你说一句"帮我做一条 60 秒的 AI 工具科普口播视频",它就能把选题、口播稿、分镜表、各家工具的提示词全部备齐, 顺手还把素材归好类——这是它的主场。
🧠 ② DeepSeek Harness —— 制片主任
DeepSeek 开源的智能体框架,官方公式很简单:Model + Harness = Agent。 它最大的特点是"一切皆插件"——模型、工具、技能、沙箱、调度全都是可替换的插件。 放到视频流程里,它就是把"读稿 → 调即梦 → 调可灵 → 合成 → 归档"串成一条自动流水线的那个人, 而且每次运行都有完整日志,跑错哪步看得一清二楚,能回放、能分叉重试。
🧑💼 ③ 即梦 AI —— 出镜主播
字节跳动家的 AI 创作平台,视频模型是 Seedance。 它有个特别对口的"数字人工作台":上传一张形象图 + 一段口播音频,自动合成唇动、表情和肢体动作, 再做一次"对口型",你就有了一条不用本人露脸的口播视频。 更贴心的是它会自动给开头加引导动作(微抬头 + 视线移动),专治前 3 秒划走。
🎥 ④ 可灵 3.0 —— 摄影指导
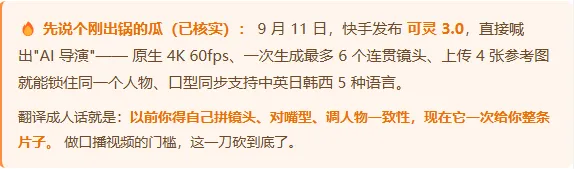
快手家的视频生成平台,刚发布的 3.0 主打"AI 导演"。 原生 4K 60fps、一次最多 6 个连贯镜头、角色锁定、5 语言口型同步、还能自己画运镜路径。 数字人负责"人",可灵负责"戏"——空镜、转场、氛围镜头,交给它。
二、实战:从 0 到 1,做一条 60 秒口播视频
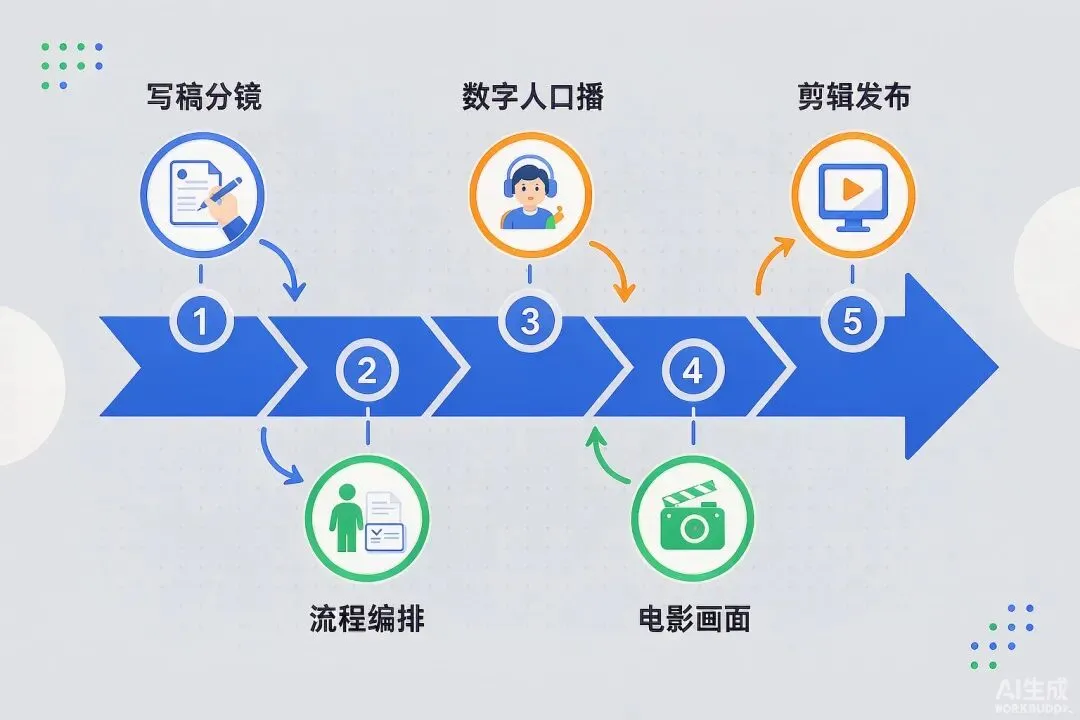
假设我要做一期《3 个 AI 工具帮你省下 10 小时》的口播短视频。整个流程走 5 步,每步谁干活我标给你看 👇
Step 1|定选题、写稿、出分镜 —— WorkBuddy 主场 🎬
我给 WorkBuddy 的指令就一句话: "写一条 60 秒 AI 工具口播稿,口语化、有钩子,再拆成 6 个分镜,每个分镜配好画面描述。" 它直接输出:口播稿 + 分镜表 + 每个镜头的画面提示词。 这一步以前要半天,现在几分钟。
💡 顺手它还干了件"场务"的活:把生成的素材按"口播音频 / 空镜 / 封面"分好文件夹,后面调工具时直接拿。
Step 2|把这套流程"焊"成流水线 —— DeepSeek Harness 🧠
单次做完不算本事,能重复跑才算生产力。 这里就轮到 Harness 出场:把"读分镜表 → 丢给即梦生成数字人 → 丢给可灵生成空镜 → 下载 → 归档"写成一个 Agent 工作流。
它"一切皆插件"的架构意味着你说的多模型切换、工具替换都是配置层面的事,不用改底层代码。 跑挂了也不慌——仅追加的会话日志把每一步都记下来了,Trajectory 视图里一眼能看出哪步翻车。
Step 3|生成数字人口播 —— 即梦 AI 🧑💼
进即梦的"数字人工作台":挑一张干净的正脸高清图(自己生成也行),配上刚写好的口播音频, 一键生成。它会自动对口型、加表情、加微动作。
💡 小经验:形象图质量决定成败。正脸、干净背景、高清,这三点做到了,出来的效果最稳。 音频控制在 10–30 秒一段,太长容易翻车。
Step 4|补空镜、做转场、上电影感 —— 可灵 3.0 🎥
口播有了"人",但整条片不能一直怼着脸拍,得有画面节奏。把分镜表里剩下的空镜描述丢给可灵:
● 多镜头一次出:一条提示里写清 Shot 1 / Shot 2 / Shot 3,它一次生成最多 6 个连贯镜头,不用你后期拼。
● 角色锁定:上传 4 张参考图,人物在各个镜头里不会突然"换脸"。
● 运镜可控:曲线运镜路径、多元素编舞、手持抖动,想要哪种电影感自己画。
💡 有人会问"即梦和可灵到底选哪个"——不是二选一,是分工。 批量素材、数字人口播找即梦;追求电影级画面和长叙事找可灵。两个都免翻、都有免费额度。
Step 5|合成、字幕、发布 —— 收尾环节 ✅
即梦生成的素材可以一键跳转剪映做二次剪辑,加字幕、配乐、卡点; 可灵那边的片段直接拖进去。最后 WorkBuddy 再把成片清单、封面图、发布文案整理成一份文件。 一条完整的口播视频,从选题到发布,齐活。
三、分工速查表:存下来,下次照着用
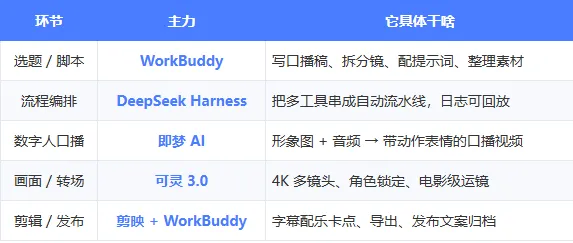
四、三个容易踩的坑,先说在前面
⚠️ 坑一:形象图随便找。 数字人效果对形象图极其敏感。别拿一张糊的、侧脸的、背景乱的图,出来的人会像"没睡醒"。正脸、高清、干净背景,缺一不可。
⚠️ 坑二:想一条提示词出整片。 可灵一次最多 6 个镜头、15 秒左右,长视频得分段生成再拼。别指望一口气出 3 分钟。
⚠️ 坑三:只做一次就完事。 真正的效率来自"能重复"。第一次手动跑通,第二次就该把它交给 Harness 变成流水线。 做一次叫玩具,能重复跑才叫工具。
五、最后聊聊:为什么这波值得你上手
前几年做视频,拼的是设备和手艺:谁的相机好、谁剪得快。 现在这套流程下来你会发现,拼的变成了"你会不会调度工具"。
WorkBuddy 负责想和写,Harness 负责串和跑,即梦负责"演",可灵负责"拍"—— 你从"什么都自己干"的执行者,变成了"决定要做什么"的导演。 这才是"一人一支队伍"的真正意思。
家人们,与其纠结"我不会剪辑、我不上镜",不如先跑一遍这 5 步。 第一次可能磕磕绊绊,第二次你就发现——原来做视频这件事,真的不需要等"准备好" 😎
—— 关注「老登带你玩转AI」——
每周拆解一个 AI 工具,用最接地气的话,帮你把 AI 真正用进工作里。