ARTICLE · 987874
别再把 AI IDE 当聊天框:Goal、Loop 与 Subagent 正在重写开发方式
AGENTIC IDE · 工作方式升级
传统 AI IDE 让你不断提问、复制代码、运行测试;Agentic IDE 则围绕可验证目标,自主调用工具、迭代验证并并行分工。
很多人理解 AI IDE 的升级,仍然停留在两个维度:补全更快,回答更准。
但最近真正值得关注的变化,不只是模型更会写代码,而是人与 AI 协作的基本单位变了。
过去,我们给 AI 一个问题,期待它返回一个答案;现在,我们开始给 Agent 一个目标,要求它调用工具、修改文件、运行测试、根据结果继续迭代,直到交付一个可验证的结果。
传统 AI IDE 以“对话”为中心;Agentic IDE 以“完成任务”为中心。
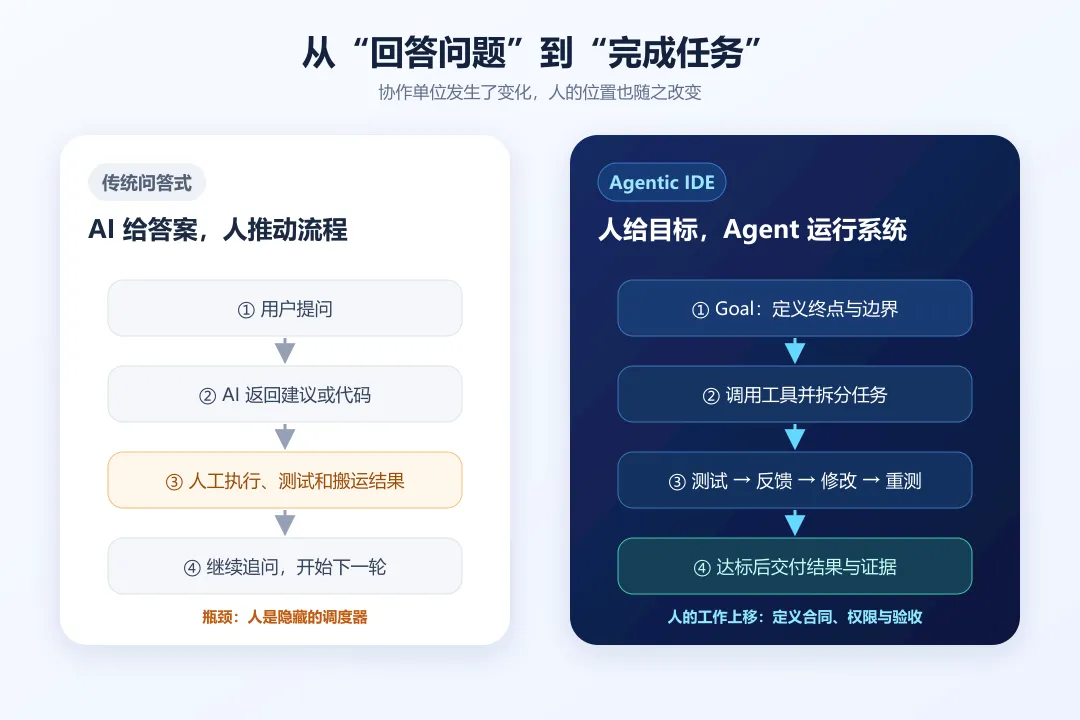
01|传统问答式 AI IDE:人其实是隐藏的调度器
典型的 AI IDE 会话大致是这样:
用户:这个错误怎么修?
AI:建议修改这里。
用户:我改了,但测试又失败了。
AI:那再调整另一个地方。
用户:现在出现了新的回归……
这种模式并没有过时。解释代码、生成小函数、查询 API、讨论设计方案,它仍然高效而直接。
问题在于,一旦任务变成长链条,用户就会默默承担四个角色:拆解任务的人、触发下一步的人、搬运上下文的人,以及最终验证结果的人。
AI 提供局部答案,但整个执行循环仍然在人脑里。所以,问答式 AI IDE 的上限往往不是“模型能不能想到答案”,而是人能不能持续、准确地组织整个过程。
02|四个概念,把聊天框变成任务系统
Goal、Loop Engineering、Subagent 和 Automation,分别解决四个不同的问题。
Goal:做成什么才算结束
/goal 的重点不是让 AI “更努力”,而是给长任务建立一个持久目标和可验证的终点。
/goal 完成支付模块的幂等性改造,直到重复请求不会产生二次扣款、现有回归测试全部通过,并新增并发测试。
普通提示词经常只描述“做什么”;好的 Goal 还要描述“什么证据能够证明做完了”。
Loop Engineering:每一轮怎样变得更好
“Loop Engineering”并不是 Codex 的正式命令。本文把它理解为一种工程方法;OpenAI 官方更接近的表述是 scored improvement loop,即评分驱动的改进循环。
执行 → 测试或评分 → 分析失败 → 修改 → 再测试 → 达标停止
普通 loop 只是重复;Loop Engineering 则要设计评测器、反馈规则、记录方式、成本边界和停止条件。
Subagent:哪些工作可以并行交给不同角色
Subagent 是主 Agent 临时派出的子代理。它适合处理彼此独立、边界清楚的工作:
• 一个 Agent 追踪前端调用链;
• 一个 Agent 检查后端并发逻辑;
• 一个 Agent 补充测试和复现脚本;
• 主 Agent 保留需求、关键决策与最终整合。
它解决的不是“重复”,而是“分工”。
Automation:什么时候自动开始或重复
Automation 负责时间触发,例如每天检查依赖更新、每周生成质量报告。它回答的是“什么时候运行”,而不是“目标是什么”或“怎样改进”。
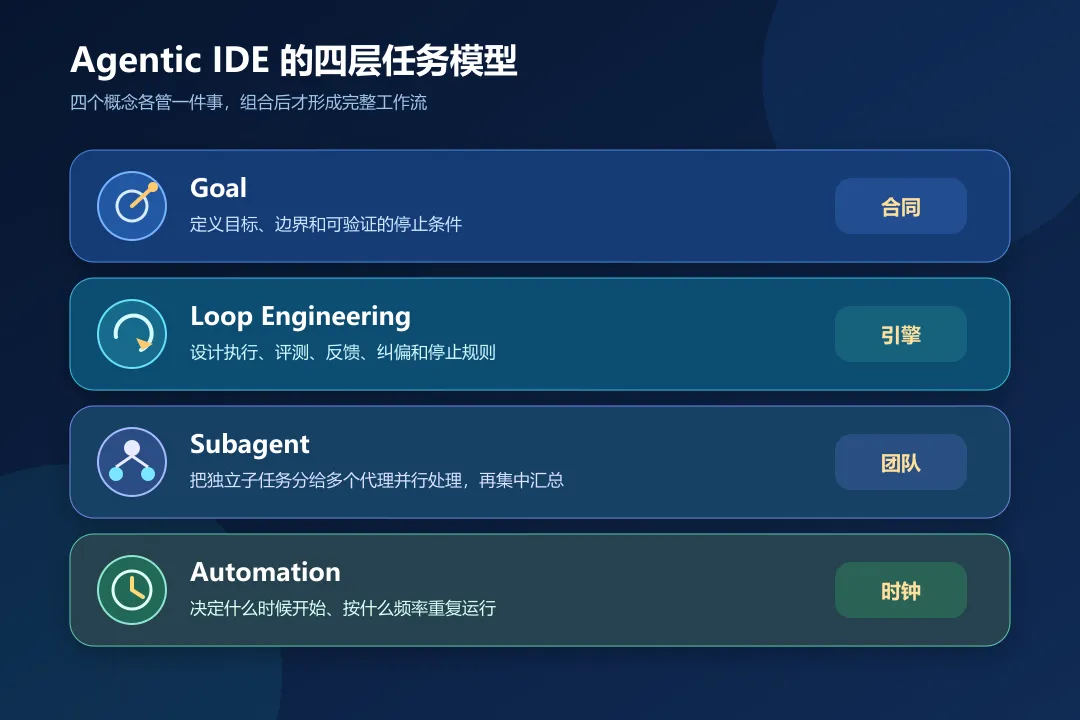
03|它们不是四个孤立功能,而是一套控制系统
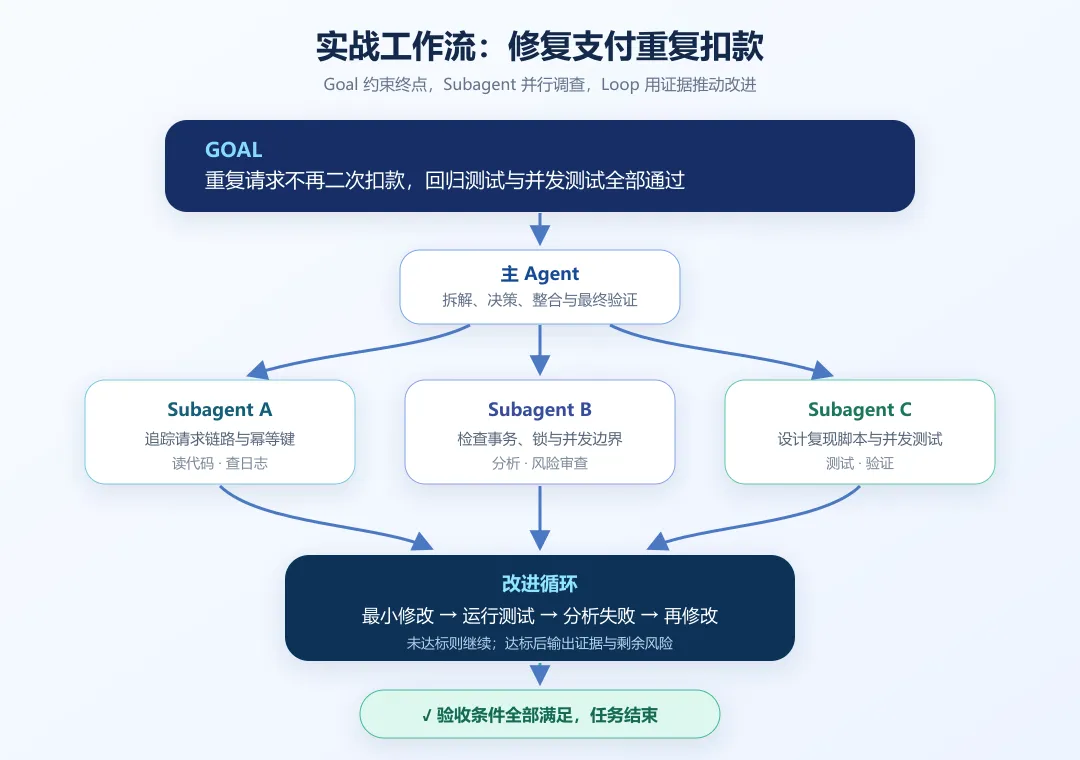
一个成熟的 Agent 任务通常这样组织:
Goal:定义目标、边界和验收标准
↓ 主 Agent 理解任务并拆解工作
Subagents:并行探索、测试或分析
Loop:修改—评测—纠偏—再评测
↓ 达到停止条件
主 Agent 汇总结果、证据与剩余风险
这里最重要的变化,是 AI 不再把“生成一段回复”当作默认终点。
回复只是过程中的状态报告;真正的终点是测试通过、指标达标、产物生成,或者某个明确的业务条件得到满足。
04|一个真实感更强的例子:修复重复扣款
假设线上出现支付重复扣款问题。在传统会话里,开发者需要不断把日志、调用栈和测试结果贴给 AI,再根据建议手动推进。
换成任务式工作流,可以提前定义:
目标:修复重复扣款问题。
① 复现用例由失败变为通过;
② 支付模块全部回归测试通过;
③ 新增并发重复请求测试;
④ 不修改与问题无关的接口行为。
用户不再负责每一步“接下来做什么”,而是负责一开始把目标、权限和验收规则定义清楚,并在关键节点审查结果。
05|开发者正在从“提问者”变成“系统设计者”
这种变化并不意味着开发者退出过程。相反,人类需要承担更高一层的工作。
1. 设计任务合同:把“帮我优化一下”改成带指标、边界和终点的目标。
2. 设计验证机制:用测试、benchmark、静态检查和评分标准决定优化方向。
3. 拆出独立子任务:让探索、测试和分析并行,避免多个 Agent 同时争抢同一批文件。
4. 划定权限和退路:把沙箱、审批、Git、备份、预算和停止条件纳入工作流。
06|这不是“万能自动驾驶”
Goal、Loop 和 Subagent 能减少微观管理,但不会自动消除风险。
目标写错:Agent 可能非常认真地完成错误任务。
指标写错:Agent 可能优化数字,却损害真实体验。
并行过度:Subagent 会增加 Token 消耗,并行写代码还可能制造冲突。
因此,不是每个问题都需要启动一支 Agent 团队:
• 解释代码、生成小函数:普通问答最快;
• 范围明确的一次修改:普通 Agent 回合即可;
• 跨模块、跨多轮且有明确终点:使用 Goal;
• 需要多次试验才能提升质量:设计 Loop;
• 可以独立并行探索或验证:使用 Subagent;
• 需要按时间重复执行:使用 Automation。
07|一个可以直接套用的任务模板
/goal 完成【目标】,直到【可验证终态】。
验收条件:
【必须通过的测试或指标】【不得破坏的现有行为】【需要交付的代码、文档或报告】
工作循环:
每次做一个聚焦改进;每次重要修改后重新验证;记录结果,未达到阈值时继续。
并行分工:
将独立调查或测试交给 subagent;主 Agent 负责决策、整合和最终验证。
约束:
禁止的高风险操作;时间或成本预算;必须由人决定时停止并请求确认。
最终输出:完成内容、验证证据、主要修改与剩余风险。
结语|AI IDE 的下一阶段,不是更会回答
传统 AI IDE 把模型放进编辑器;Agentic IDE 则把目标、工具、反馈、并行协作与停止条件组织成一个可运行的系统。
模型本身可能没有突然变得更聪明,但工作方式发生了根本变化:
人不再逐步遥控 AI,而是设计一套边界清晰、可以被验证的任务系统。
当协作单位从“回答”变成“结果”,真正重要的能力也不再只是 Prompt Engineering,而是目标设计、评测设计、任务拆解与权限治理。
参考资料
OpenAI Docs · Follow a goal:learn.chatgpt.com/use-cases/follow-goals
OpenAI Docs · Iterate on difficult problems:learn.chatgpt.com/use-cases/iterate-on-difficult-problems
OpenAI Docs · Subagents:learn.chatgpt.com/docs/agent-configuration/subagents
OpenAI Docs · Scheduled tasks:learn.chatgpt.com/docs/automations
本文基于 2026 年 9 月 1 日可查的 OpenAI 官方文档整理;产品功能可能持续变化。封面由 AI 生成,正文原理图为信息可视化制作。