ARTICLE · 990709
用豆包把 PDF 变成 Obsidian 笔记:四步工作流
用豆包把 PDF 变成 Obsidian 笔记:四步工作流
你大概率经历过这个场景:辛辛苦苦下载了一份几百页的 PDF 技术文档,读起来太累,想把它放进 Obsidian 知识库,结果第一步就卡住了。 直接复制?文字断成碎片。保存成附件?检索不了、链接也建不起来。转成 Markdown?表格、标题层级、代码块全乱。 问题不在 PDF,也不在你,而在一个经常被忽略的前提:PDF 和 Obsidian 之间,差的不是「格式」,而是「结构」。 这篇文章不绕弯子,给你一套可以直接照做的四步工作流:怎么把 PDF 变成 Obsidian 里真正能检索、能双链、能长期复用的 Markdown 笔记。 一句话先说清楚:PDF 是「排版文件」,Obsidian 是「结构文件」。 PDF 把内容按页面锁死——文字、表格、图片的位置固定,翻页即所见,但文本本身可能是被切碎的,尤其是表格和分栏。 Obsidian 只认纯文本 Markdown,它靠「结构」运转:标题层级、YAML 元数据(frontmatter)、双链、标签。 所以「PDF 转 Obsidian」并不是复制粘贴,而是一次结构重建,至少要做四件事: 识别标题层级:把「第 X 章 / X.X 节」翻译成 H1 / H2 / H3 还原表格:把 PDF 里粘成一团的表格,恢复成 Markdown 表格 重建链接:把文档里提到的「另一个概念 / 另一篇笔记」接上双链 补元数据:在文件开头写 frontmatter,让 Dataview 之类插件能索引 **判断转换是否成功的标准只有一条:**转出来的文档,在 Obsidian 里大纲能正常折叠、能被全文搜索、能和其他笔记建立链接。 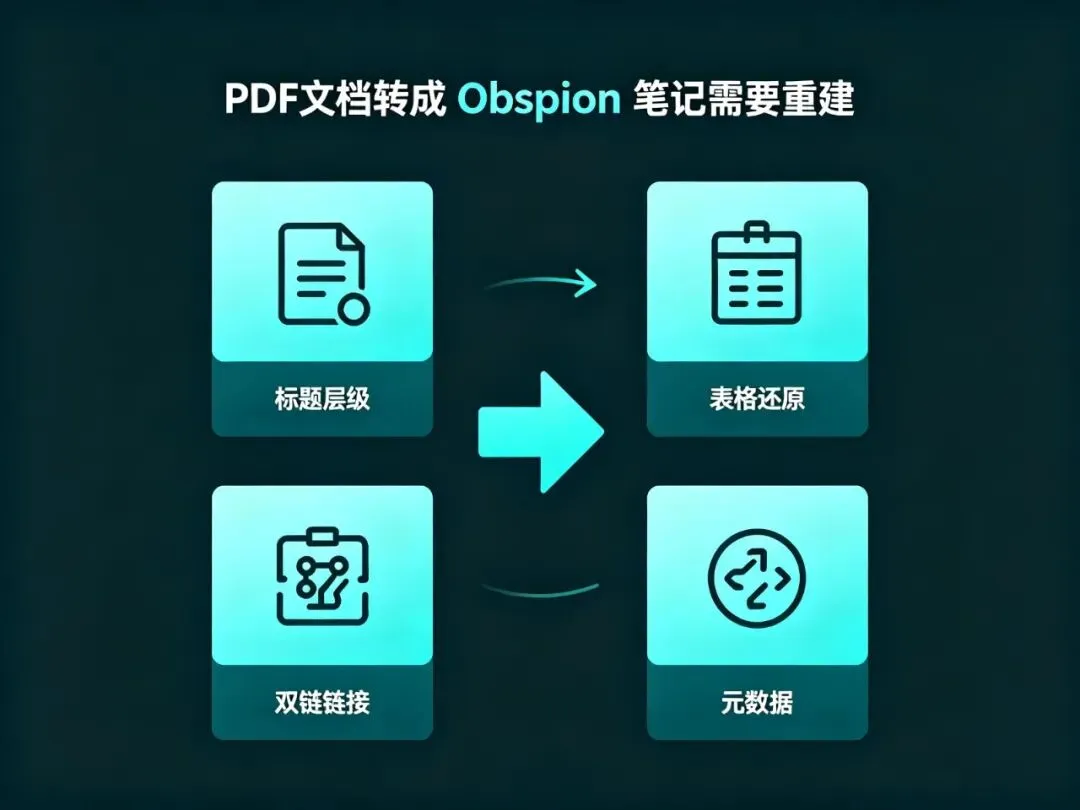
这一步的目的只有一个:让 AI 拿到干净、完整、不乱码的文本。有两条路径。 **路径 A:直接把 PDF 上传给豆包,让它分段转成 Markdown。**适合文本型 PDF(文字可以选中复制的那种)、页数不太多、版式规整的文档。要点:上传后不要只说「帮我转」,要给明确指令,比如「把这份文档按章节转成 Markdown,保留标题层级、表格和代码块,不要删减内容」。 **路径 B:先用本地工具把 PDF 抽成文本,再交给豆包整理。**适合扫描版 PDF(本质是图片,需要 OCR)、超大文件、图文混排复杂的文档。要点:抽取结果乱是正常的,豆包的价值恰恰是把「乱」整理成「结构」。 怎么选?一个判断标准:先试 A,如果出现乱码、表格错位、内容丢段,就切到 B,别在同一条路径上死磕。 完成标准:文本完整、不乱码、段落顺序对、表格内容没丢。 这是最容易翻车、也最值得先说的一步。 很多人图省事,把整本 PDF 一次性丢给 AI 让它「全部转完」。结果通常是:转到一半截断、章节层级乱套、越到后面越抽象。 正确做法是按章节拆: 一次只转一章或一个模块 每章转换都给同一套「输出结构指令」(标题层级、代码块、表格保留、列表,写清楚让 AI 照做) 转完一章,快速看一眼,没问题再转下一章 这里有两个高发坑,提前给你打预防针: · 表格:AI 很容易把表格「翻译」成一段文字。指令里要单独强调「表格必须还原成 Markdown 表格」。 · 代码块:命令、配置、SQL 之类,AI 可能自作主张「修正」或换行错乱。指令里要写「代码原样保留,不要改写」。 完成标准:每一章都独立成篇、结构干净,合并后大纲完整。 文本转换完,工作其实只完成了一半。Obsidian 的价值在「结构」,这一步是把它真正变成知识库成员的关键。 **第一,写 frontmatter。**在文件最顶部加一段 YAML,建议至少包含:标题、别名、标签、来源、原文日期、归档时间。有了它,Dataview 才能帮你做「索引面板」,把散落的笔记汇总成一张表。 **第二,校准标题层级。**把 PDF 的「章 / 节 / 小节」对应成 H1 / H2 / H3。打开大纲视图检查:能不能一层层折叠?如果全是平铺的一级标题,说明层级还没建好。 **第三,接双链。**文档里提到其他概念、其他资料时,用双链符号把它们包起来。别追求「每句话都链接」,先接高频概念。接完打开反向链接面板,看有没有入链,知识库就慢慢长起来了。 完成标准:打开该笔记,大纲可折叠、frontmatter 被 Dataview 识别、至少有一两个可跳转的双链。 AI 转换有一个特点:它会「自信地出错」——格式看起来完全正常,但内容可能被悄悄改写、表格列被合并、关键数字变了。 所以最后一步,别用肉眼扫,直接跑一遍验证清单: □ 大纲视图:标题层级完整,无塌陷、无错乱 □ 表格:每一处都还原成 Markdown 表格,列对齐 □ 代码块:命令、参数、SQL 原样保留,未被「修正」 □ 链接:原文超链接有效,未失效 □ 图片:引用路径有效,Obsidian 能正常显示 □ frontmatter:Dataview 查询能正确取到字段 这一遍做完,这份笔记才算真正「入库」,而不是「存了个文件」。 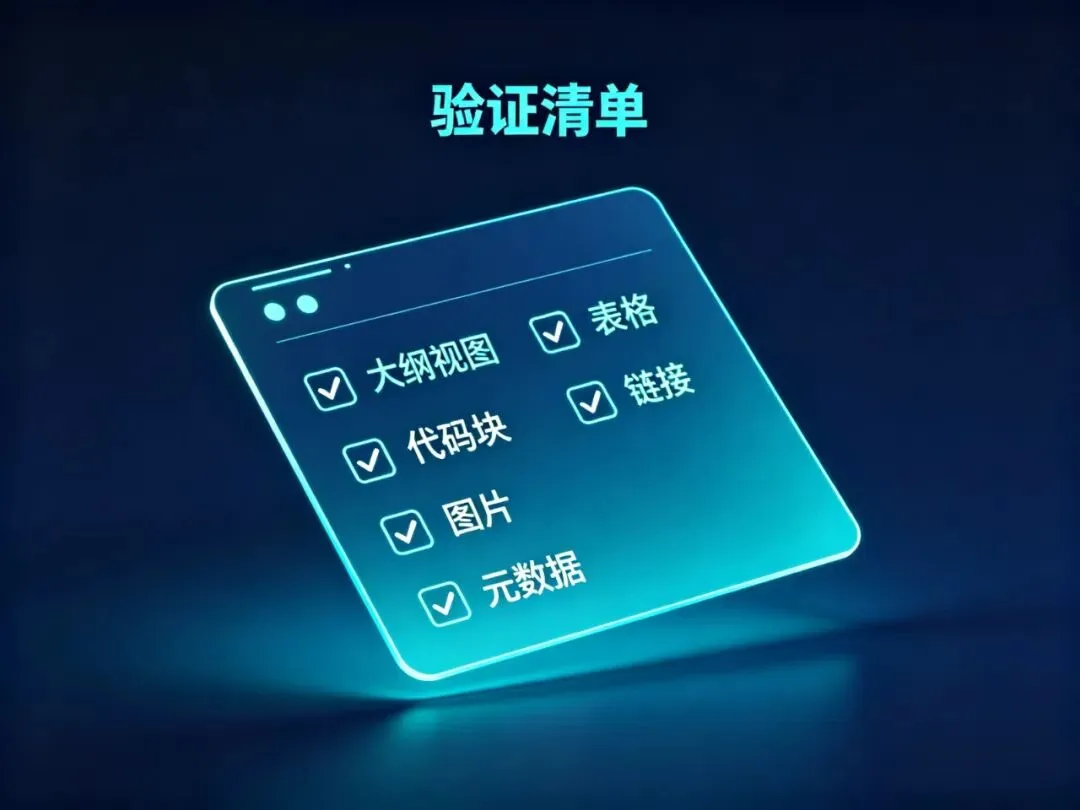
这套方法很实用,但不是所有 PDF 都适合。 **适合:**技术文档、白皮书、产品说明书、研究报告、政策文件——这类文档结构清晰,以文字和表格为主。 要小心: · 扫描版纯图片 PDF:效果取决于 OCR 质量,识别不出的部分需要人工补 · 版式极复杂的画册、杂志:排版即内容,强行转 Markdown 会损失大量信息 · 有版权的书籍、资料:只转换你拥有合法使用权限的文档,别踩版权红线 另外提醒一句:AI 工具的功能会持续更新,具体操作入口以豆包实际界面为准,这篇文章给的是「方法论」,不是某个版本的截图教程。 **如果你也想把自己的 PDF 资料变成 Obsidian 知识库的一部分,别一上来就转整本。**拿一份 20 页以内的 PDF 试一次:先转一章,跑一遍验证清单,确认结构没问题,再扩展到整本。 工具在变,但底层的方法不变:PDF 是死的排版,Obsidian 是活的结构。AI 负责把「死的」读进来,你负责把「活的」搭起来。 
封面推荐语:PDF 是死的排版,Obsidian 是活的结构——用豆包把资料真正装进你的知识库。 用豆包把 PDF 变成 Obsidian 笔记:一份能直接上手的四步工作流(主标题) 别再把 PDF 存进 Obsidian 了:转成能检索、能双链的 Markdown,其实只要四步 PDF 转 Obsidian 老是翻车?问题不在工具,在这四个动作 为什么你的 Obsidian 知识库「只存不用」?因为你没把 PDF 转成结构 拿一份 20 页 PDF 练手:用豆包搭出你的第一篇 Obsidian 长文笔记 本文为方法教程类常青内容,不涉及时效性数据与案例。 关于豆包的产品能力(上传 PDF、AI 对话、文本结构化整理):为通用能力描述,以官方产品实际表现为准,文中未引用未核实的数据、截图或版本信息。 Obsidian 相关概念(Markdown、frontmatter、双链、Dataview、大纲视图、反向链接面板)为公开且稳定的产品常识。 文中案例为通用场景描述,无虚构来源与权威背书。 配图为 AI 生成示意图,非真实产品截图,不指向具体品牌界面。
用豆包把 PDF 变成 Obsidian 笔记:一份能直接上手的四步工作流
01 先搞清楚:PDF 和 Obsidian 之间差的是「结构」,不是「格式」
02 第一步:先把 PDF 变成「可读的文本」,再谈转换
03 第二步:按「章节」转换,不要整本一次吞
04 第三步:重建 Obsidian 的「骨架」:frontmatter、标题、双链
05 第四步:用「验证清单」收尾,而不是肉眼抽查
06 适用边界:什么文档适合,什么要小心
封面图
备选标题
内容验真
(注:部分内容可能由 AI 生成)