ARTICLE · 992352
AI Agent 终于能连续干几十小时了?高德开源 LongHorizon-Harness
如果你真的把一个复杂任务交给过 AI Agent,大概率见过这种场面:前十分钟思路清晰,半小时后开始重复劳动;明明改坏了文件,却自信地说“已经完成”;上下文一刷新,刚才踩过的坑又踩一遍。
现在,高德 AMAP-ML 团队开源了一个专门治理这类问题的项目——LongHorizon-Harness。
它不训练新模型,也不打算取代 Codex、Claude Code 或 OpenCode。它做的是更务实的一件事:在现有 Agent 外面套上一套“计划—执行—验收—保存—恢复”的长任务循环,让 AI 不只是会做一轮,而是能在桌面应用和命令行之间持续推进,直到交付物真的通过检查。
项目给出的口号很直白:一次给出目标,让 Agent 连续工作几十小时。
这可能是近期最值得开发者关注的 Agent 基础设施之一。
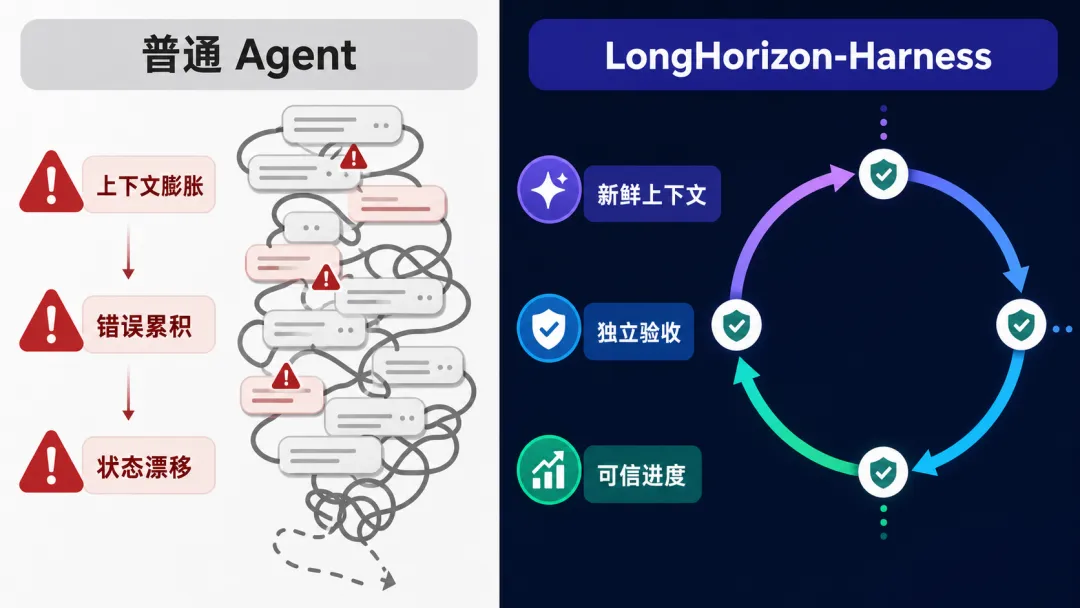
真正拖垮 Agent 的,往往不是智商,而是“断片”
短任务里,模型能力几乎决定了一切。但任务一旦拉长,新的麻烦就会出现:上下文越来越臃肿,任务状态和聊天记录混在一起,错误结论被带入下一步,最后连“到底做完没有”都由执行者自己判断。
这就像让同一个人连续加班几十个小时:他既负责制定计划,又负责动手,还要给自己的结果打分。即使能力很强,也很容易遗漏、误判和跑偏。
LongHorizon-Harness 的关键判断是:长周期 Agent 的问题,本质上是任务状态管理问题。
因此,它把“已经完成什么、哪些结果经过验证、下一步做什么”从不断增长的上下文中抽离出来,变成一份显式、可持续更新的状态记录。只有经过独立检查的事实,才能进入下一轮的可信状态。
三个角色,组成一个不会轻易自我欺骗的循环
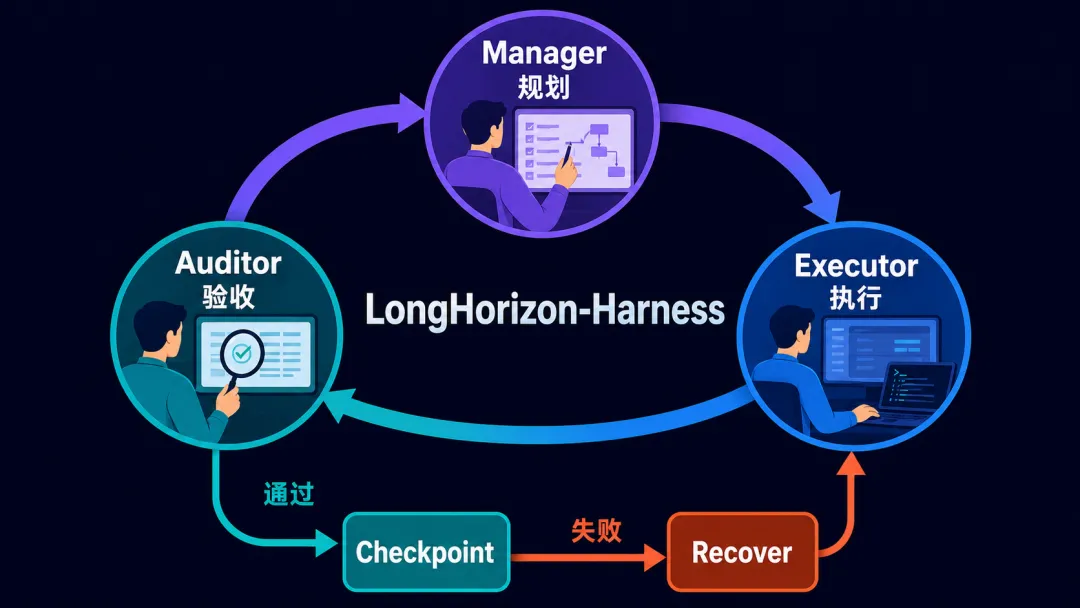
LongHorizon-Harness 采用 Manage–Execute–Audit,也就是 MEA 循环。你可以把它理解成一个三人小组。
Manager:管方向。 它读取原始目标、已验证进度、失败证据和剩余工作,只规划下一段边界清晰的小任务。
Executor:管执行。 它每轮使用新鲜上下文,在桌面软件或终端里完成当前步骤,避免历史对话越积越乱。
Auditor:管验收。 它以只读方式独立检查真实文件、界面、日志和测试,不直接相信 Executor 的“我做完了”。
如果验收通过,结果进入 checkpoint;如果失败,失败证据会被带回下一轮重新规划。于是整个流程变成:
计划下一步 → 执行 → 检查真实结果 → 保存可信进度或恢复 → 继续。
注意,这里的三个角色更像职责隔离,不是三个 Agent 各自发散。它要解决的是“谁有权宣布进度有效”,而不是单纯堆更多模型。
同一个模型,套上这层循环后发生了什么?
项目团队在 GUI、CLI 和混合环境的数百个复杂任务上进行了测试。README 公布的同模型、同执行后端对比中,Qwen 3.7-Plus 搭配 Claude Code 后端得到以下结果:
●WeaveBench 的通过率从 51.8% 提升到 80.7%;
●OSWorld 2.0 的完整完成率从 2.8% 提升到 8.3%,约为原来的 3 倍;
●Terminal-Bench 2.1 的成功率从 69.7% 提升到 77.2%,同时 token 使用减少 24%。
论文还报告,在 OSWorld 2.0 的一个子集上,Claude Opus 4.7 从 20.0% 提升到 34.3%。
这些数字最值得关注的地方,不是“某个模型突然升级”,而是:底层模型不变,只改执行循环,也能明显提高复杂任务的完成率。
当然,benchmark 不等于你的真实业务,OSWorld 的绝对完成率也说明桌面 Agent 仍远没有成熟。更准确的结论是:Loop Engineering 正在成为模型能力之外,另一个决定 Agent 上限的工程变量。
它已经不只是一个论文 Demo
LongHorizon-Harness 当前支持 Codex、Claude Code、OpenCode 和 DeepSeek Harness,也允许 Manager、Executor、Auditor 分别使用不同模型。你可以让强模型负责规划和验收,让更便宜的模型负责执行,在效果、速度和成本之间做组合。
它还能把同一个任务横跨浏览器、表格、文档、设计软件和终端:先从网页收集数据,再用命令行处理,接着进入桌面应用生成交付物,最后回到终端跑测试。任务状态始终由同一套循环管理。
v0.1.7 还把完成后的运行变成了可继续追问的会话。你可以在原有轮次账本上追加要求,而不是让系统从头规划。
想试试,五分钟就能跑起来
项目要求 Python 3.10 及以上,推荐使用 uv 安装。你还需要至少一个已经可用的 Agent CLI。
终端 · 命令
$ uv tool install lh-harness$cd /path/to/your/project$ lh-harness init$ lh-harness web --workspace-root .
浏览器工作台默认会在本地启动,你可以选择不同角色使用的后端和模型、处理授权请求、查看每轮进度,也可以中途追加指令。
如果任务需要操作图形界面,还要安装对应的 computer-use 插件。例如使用 Codex 时:
终端 · 命令
$ lh-harness plugin install codex-computer-use$ lh-harness doctor
doctor 会检查 Python、Agent CLI、Node.js 和插件状态。首次尝试建议先在副本目录或测试项目中运行,因为 Agent 会直接操作你指定的真实工作区。
哪些人最值得现在就关注?
如果你的工作只是让 AI 改一个函数、查一段资料,这套系统可能显得偏重。但下面几类场景很适合它:
●要跨浏览器、终端、表格和文档完成的复杂工作;
●需要多轮修改、测试、视觉检查和失败恢复的项目;
●希望 Agent 跑几个小时,又不能靠“它说完成了”来验收的任务;
●想研究多模型分工、长任务状态管理和 Agent 评测的开发者。
它也有现实门槛:目前主要在 macOS 上经过测试,Windows 虽已包含支持但尚未充分验证;长时间多角色运行会增加模型调用成本;桌面操作涉及系统权限,隔离目录和最小权限仍然非常重要。
最后说两句
过去一年,大家都在追更大的模型、更长的上下文、更强的工具调用。但 LongHorizon-Harness 提醒了我们:真正可用的 Agent,不只需要会思考,还需要会交接、会验收、会保存进度、会从失败中继续。
模型决定一轮能做多好,循环决定它能不能把几十轮串成一次可靠交付。
这也是“提示词工程”之后,一个正在快速升温的新方向:Loop Engineering,循环工程。
如果你正在使用 Codex 或 Claude Code 做复杂项目,这个开源项目值得收藏,更值得拿一个真实但可控的任务亲自跑一遍。
项目地址:https://github.com/AMAP-ML/LongHorizon-Harness
论文:https://arxiv.org/abs/2608.01964
项目主页:https://lh-harness.pages.dev/
PyPI:https://pypi.org/project/lh-harness/
注:文中功能、版本与 benchmark 数据核对时间为 2026 年 8 月 31 日;性能数字来自项目 README、项目主页及论文,实际效果会受模型、后端、权限、任务类型和环境影响。