ARTICLE · 992924
端侧 AI 的价值,藏在 token 成本、隐私合规与生态围墙里
英伟达单季营收 962 亿美元、AIPC 出货预计 1.43 亿台——算力两端同时狂飙。但端侧 AI 的真正价值,从来不是"取代云端",而是回应三个更现实的问题:成本、隐私、自主权。这篇文章把三个逻辑、一组数据、一个样本拆开讲透。
一、先放下"取代论"
过去两年,端侧 AI 的叙事常被拉向两极:要么"端侧革命、云端将死",要么"端侧只是过渡技术"。
两种都站不住。
•云端大模型在复杂推理与知识密度上依然不可替代,英伟达 962 亿美元的单季营收就是证明
•端侧在成本、隐私、响应速度上有结构性优势,AIPC 1.43 亿台的出货量是硬件侧的注脚
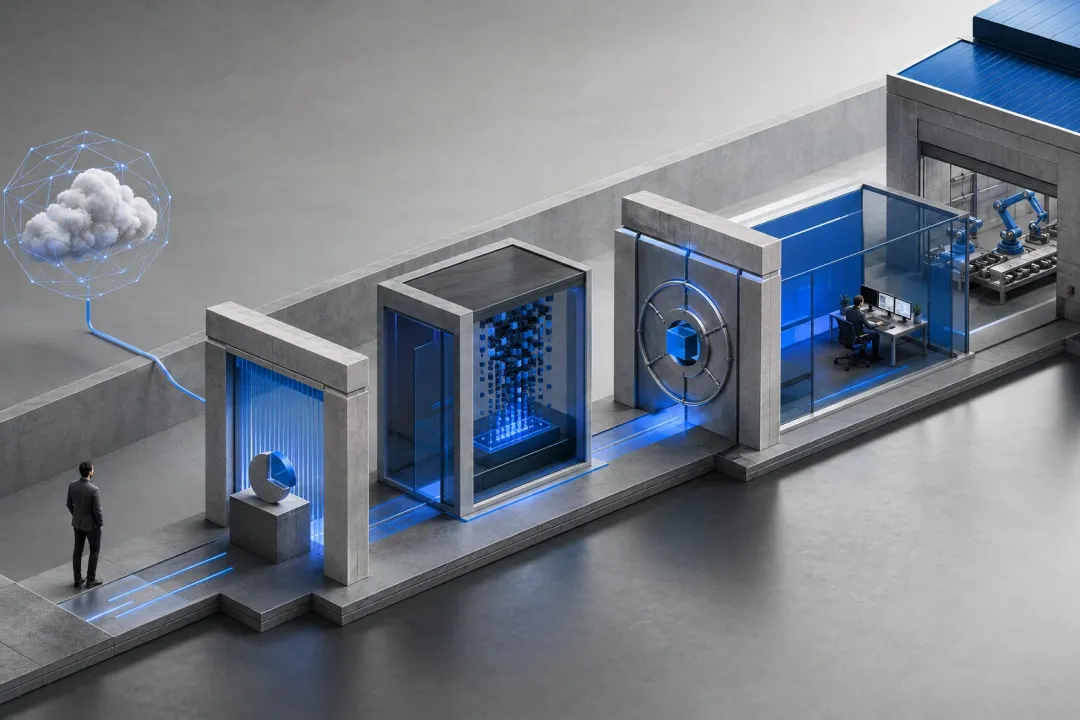
更准确的判断是分层协作:
•云端:负责"难而少"——深度分析、跨领域推理、长文理解、复杂生成
•端侧:负责"多而频"——会议纪要、邮件梳理、文件转换、日常检索、语音输入
这个判断不靠概念,靠三个实打实的商业逻辑。
二、逻辑一:token 成本高企,端侧是"分流阀"
2.1 一个反直觉的现象
大模型价格战打了两年,token 单价确实在跌,但企业的 AI 总账单反而越来越重。
这不是个别企业的错觉,而是普遍现象:用量涨得比降价快。
2.2 为什么?
经济学里有个"杰文斯悖论"(Jevons Paradox):效率提升不会减少总消耗,反而刺激更大规模的使用。token 降价恰恰触发了这个效应:
1.Agent 时代的调用量级变了:过去"问个问题"消耗几十个 token;如今一个 Agent 任务要拆解目标、调用工具、多轮反思、自我纠错,一次轻松烧掉几千甚至上万 token
2.高频任务反复计费:会议纪要、邮件梳理、文档处理——每天发生几十次,每次都走云端推理,积少成多
3.模型越强,企业越敢用:推理能力提升后,企业把更多任务交给 AI,频率与复杂度同步上升
于是出现一个反直觉现象:单价跌、总账涨。端侧的价值,就是把高频、重复、低延迟的任务分流到本地——零 token 成本、零网络依赖。这不是替代云端,而是给 AI 支出装一个"分流阀"。
三、逻辑二:垂直行业的隐私合规,端侧是"安全区"
如果说成本是普遍的痛点,隐私则是部分行业的红线。
医疗、金融、法律、政务、制造——数据天然敏感:
•医疗:患者病历、影像资料、用药记录,上云要过重重合规审计,很多三甲医院明确"核心医疗数据不出内网"
•金融:审计底稿、客户资产信息、风控模型,受数据安全法、个保法、行业监管多层约束,很多金融 AI 项目卡在数据准入环节
•政务与法律:涉密文档、案件材料、政策文件,政务内网与互联网物理隔离是铁律;律所客户保密协议同样要求数据不出所
端侧的逻辑很简单:数据不出域,就是最大的合规。文件、语音、操作记录留在本机,天然满足监管要求——对敏感行业来说,这不是可选项,是必选项。
值得注意的趋势:隐私合规正在从"卖点"变成"准入门槛"。当监管持续收紧,本地处理不再是加分项,而是投标、审计、合规检查的硬条件。这意味着端侧产品的市场空间不是"锦上添花",而是"雪中送炭"。
四、逻辑三:大厂生态围墙,端侧是"自主权"
第三个问题关乎数据自主。
今天的云侧 AI 服务,大多长在大厂的生态围墙之内:
•你的对话、文档、操作习惯,沉淀在别人的平台上
•换个生态,数据带不走,习惯要重来
•平台型公司的核心资产,就是用户沉淀在生态里的数据
端侧产品则不同——数据存在用户自己的设备上:
•本地记忆、本地模型、本地文件,不依赖任何单一云厂商
•换设备、换平台,数据跟着走
•用户对自己的数据有完整的控制权
在 AI 时代,数据自主权就是话语权。这不是反大厂,而是给用户多一个选择:云端的归云端,本地的归本地。
五、行业格局:谁在布局端侧
端侧 AI 不是小玩家的独角戏,巨头和初创正在同场竞技:
玩家 | 方向 |
苹果 | Apple Intelligence 本地推理,端侧模型随芯片迭代 |
高通 | NPU 算力平台 + 端侧模型优化,瞄准手机与 PC |
微软 | Copilot+ PC,Windows 本地 AI 能力 |
谷歌 | Gemini Nano 端侧小模型,Android 生态内嵌 |
华为 | 盘古端侧化 + 鸿蒙生态,国产端侧算力 |
初创公司 | 端侧智能体(如 Owlfy),专注高频办公场景 |
巨头做的是"端侧平台",把本地 AI 变成系统能力;初创做的是"端侧应用",把本地 AI 变成具体工作流。两条路线并不冲突,反而在互补——平台铺路,应用跑车。
六、端侧样本:三个逻辑如何落地
三个逻辑正在被端侧产品逐一兑现。以 Owlfy(www.owlfy.cn)为例:
•会议:自动记录、生成带时间戳纪要,本地完成
•邮件:收件箱优先级梳理、晨间早报、承诺识别,本地阅读
•文件:批量格式互转、合并、总结,全程不出设备
•多语种:100+ 语言实时互译,本地翻译不出设备
•自动化:定时任务 + 手机远程指挥,本地执行、远程触发
隐私设计上,六项保护:文件默认留本地、不训练用户数据、语音仅实时识别、高风险操作先确认、不暴露公网接口。支持 Mac、Windows、Linux 和微信,免费版即可体验。
七、风险与挑战:理性看待三个问题
端侧 AI 的前景值得关注,但也要理性看待挑战:
1.端侧模型能力上限:复杂推理仍需云端,端侧无法覆盖全部场景——这不是缺陷,是分工
2.碎片化问题:不同设备、不同芯片、不同系统,端侧应用要适配的硬件环境比云端复杂得多
3.生态迁移成本:用户习惯了大厂全家桶,端侧产品要说服用户"换一种方式用 AI",教育成本不低
但换个角度看,这三个挑战恰恰是机会:谁能把适配做好、把场景做深、把迁移成本降到最低,谁就能在端侧赛道站稳脚跟。
八、结语
端侧 AI 不会取代云端,就像本地发电不会取代电网。
它回应的是三个更现实的问题:成本往哪分流、隐私怎么守住、数据归谁所有。而最终的答案,几乎必然是混合架构——高频、敏感、低延迟的任务留在本地,复杂、深度、跨领域的推理交给云端。
AIPC 出货 1.43 亿台(Gartner)说明硬件底座已就位;剩下的,是让这些算力真正为用户服务。这个方向,值得行业持续观察。
*Owlfy(www.owlfy.cn)——一句话,就搞定。*