ARTICLE · 993268
18.3K+ Star 开源神器!PDF 200ms 极速解析,直接砍掉一半文档处理成本
18.3K+ Star 开源神器!PDF 200ms 极速解析,直接砍掉一半文档处理成本
你手里收到的一份 PDF,有可能是 Word 导出自带文字层的报告合同;有可能是纸质文件扫描生成的纯图片;也有可能一部分页面可复制文字、一部分页面是扫描件的混合文档。 绝大多数人的处理方案简单粗暴:拿到 PDF,全部送入 OCR 识别。 这个方案带来三大致命问题: 难道就没有办法先分清 PDF 类型,文本页本地提取、扫描页再交给 OCR? Firecrawl 团队开源的 pdf‑inspector,就是专门解决这个痛点的纯 Rust 高性能 PDF 解析库。上线不久 GitHub 星标已经突破 18.3k,它的定位不是一款全能 OCR 工具,而是你 PDF 处理流水线入口的智能分诊台。 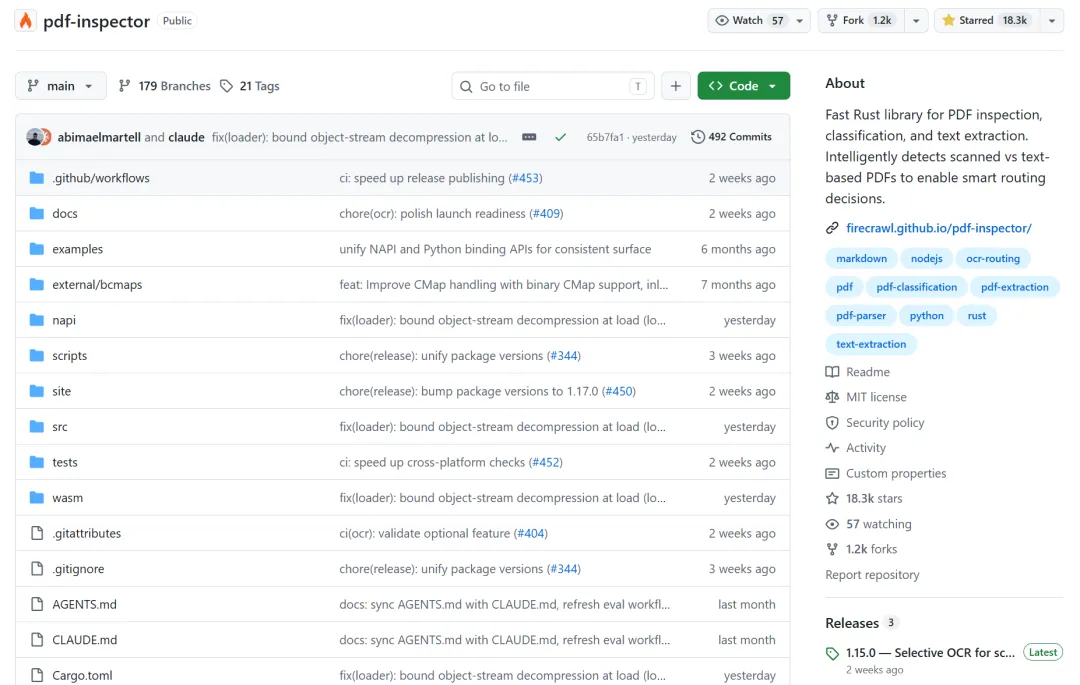
01 项目介绍 pdf‑inspector 是 Firecrawl 从自家生产环境 PDF 引擎 Fire‑PDF 当中抽离出来、单独开源的核心组件,底层完全基于 Rust 开发,仅依赖 lopdf 一个 PDF 解析库。 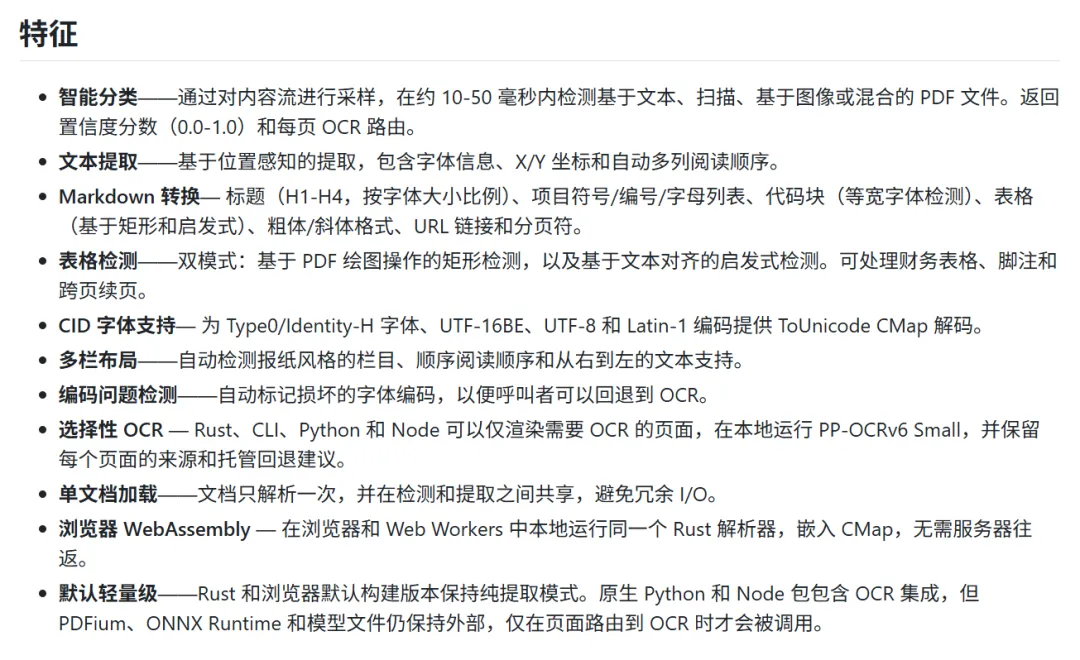
无机器学习模型、不调用任何外部云端接口,全部解析运算都在本地完成。 它的核心工作链路非常清晰: PDF 文档到达 → 10‑50ms 快速完成文档类型检测分类 → 文本型页面本地高速提取结构化 Markdown(耗时约 150ms,整体 200ms 以内)→ 扫描 / 图片页面标记出来交由下游 OCR 服务处理。 它一共输出四大核心能力: 1、智能 PDF 文档分类 将 PDF 精准划分成 4 大类,附带 0‑1.0 置信度打分,拒绝非黑即白的粗暴判定: 最核心的字段: 分类内置三种扫描策略,可以按需切换: 2、带坐标信息的精准文本提取 pdf‑inspector 并不是简单粗暴地把 PDF 文字一股脑导出。 提取出来的每一段文本都会附带:页面 X/Y 坐标、字体名称、字号大小。依靠坐标数据引擎自动识别多栏排版布局,论文、双栏报告能够按照人类正常阅读顺序输出文字,完美规避左右栏文字错乱拼接的经典问题。 同时针对国内开发者高频踩坑的 CID 字体乱码(Identity‑H Type0 字体) 问题内置解决方案,自带 ToUnicode CMap 解析器,支持 UTF‑16BE、UTF‑8、Latin‑1 编码回退,配套 Adobe Glyph List 字符映射表。 遇到无法解码、极有可能出现乱码的页面,引擎会主动打上 3、高质量 Markdown 结构化转换 这也是它对比 PyMuPDF、pdfplumber 等传统文本提取工具最大的优势:输出保留文档语义结构,而不是一坨无格式纯文本。 结构化的 Markdown 输出,后续直接送入大模型、向量知识库分块入库,理解效果远好于无格式纯文本。 4、双引擎表格识别(PDF 解析王牌能力) PDF 文档本身不存在 “表格” 语义标签,表格本质就是线条 + 文字拼接而成,也是 PDF 提取领域公认最难啃的硬骨头。 pdf‑inspector 采用双模检测方案,两种路径互相兜底: 实测可完美处理财务报表、带脚注表格、跨页连续续表,最终直接输出标准 Markdown 表格。 02 硬核跑分对比 官方基于 OpenDataLoader‑Bench 200 份真实 PDF 数据集,在 Apple M4 Pro 设备,关闭 OCR、仅对比本地解析引擎,得出一组可复现的基准测试数据:
从跑分结果我们可以清晰看到: 跑分结论:如果你核心痛点是表格解析、大批量 PDF 高速处理,pdf‑inspector 就是当前最优本地解析方案。 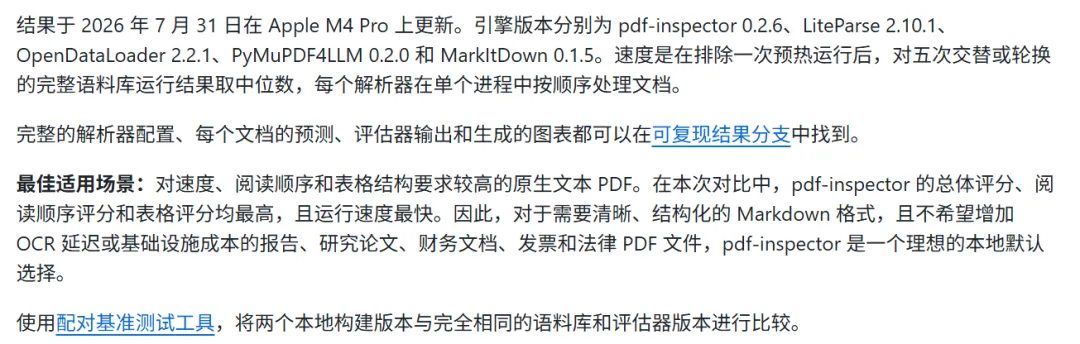
03 全平台接入教程 项目提供 5 种接入方式,覆盖后端服务、前端浏览器本地解析、快速调试场景。 方式 1:Rust 原生项目接入 Cargo.toml 添加依赖 业务代码示例 方式 2:Python 接入 ⚠️校准提示:Python 包支持 pip 直接安装,源码编译方案为备选方案 直接安装 如果源码编译构建 Python 代码示例 方式 3:Node.js/ Bun 后端接入 方式 4:浏览器前端 WASM(隐私友好方案) PDF 文件全程在浏览器本地解析,字节不上传给后端服务器,适合隐私文档、在线 PDF 工具场景 方式 5:CLI 命令行工具,快速调试 PDF 04 推荐落地架构 pdf‑inspector并不是用来替代 OCR,而是和 OCR 形成互补。 标准 RAG 文档处理流水线参考方案 PDF 文件 → pdf‑inspector 预检分支 1:TextBased 文本 PDF → 本地提取 Markdown → 文本清洗 → 知识库分块入库分支 2:Mixed 混合型 PDF → 可提取页面输出 Markdown,pagesneedingocr 标记页面送入 OCR → OCR 识别文本合并结果分支 3:Scanned/ImageBased 扫描 PDF → 全页送入下游 OCR 引擎处理 这套架构上线之后,54% 的文档直接绕过高成本、高延迟的 OCR 服务,大批量文档场景降本提速效果非常明显。 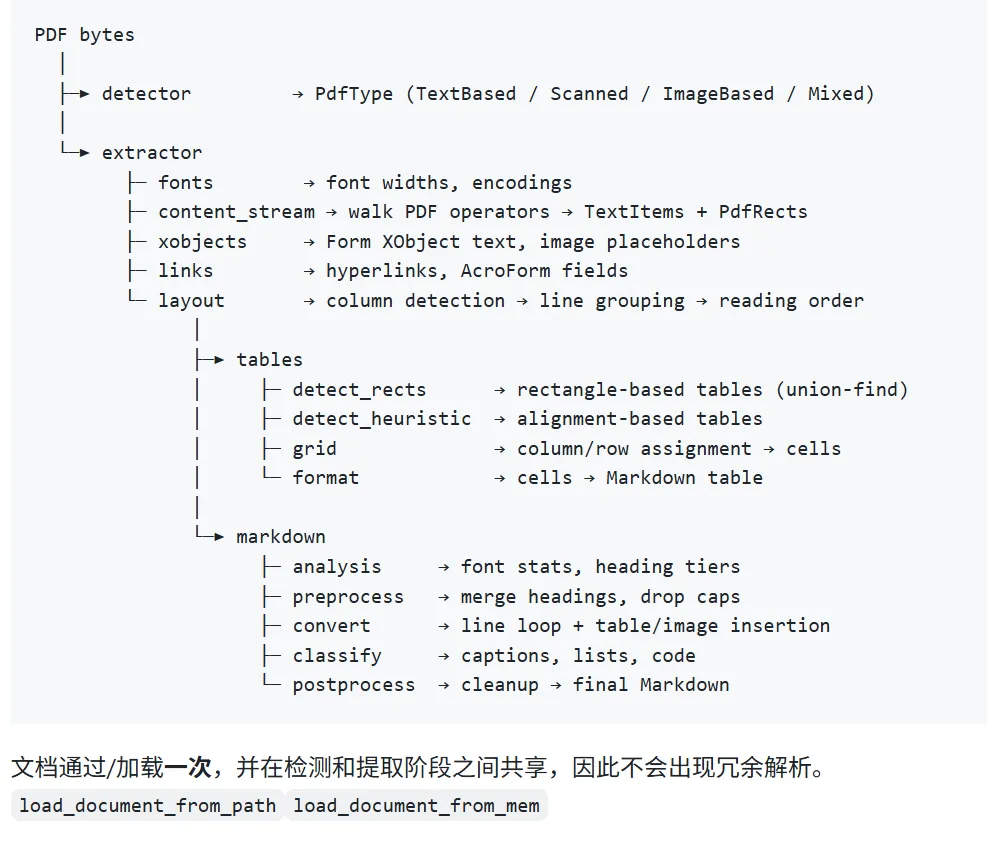
05 实战踩坑清单 没有一款 PDF 解析库能够做到万能适配,pdf‑inspector 当前版本也存在一些局限,选型前需要提前知悉: 选型建议:如果你处理文档以报告、合同、财报、论文这类标准导出 PDF 为主,pdf‑inspector 性价比极高;如果你业务扫描件占比超过 70%,它带来的收益有限,可以优先投入资源优化 OCR 管线。 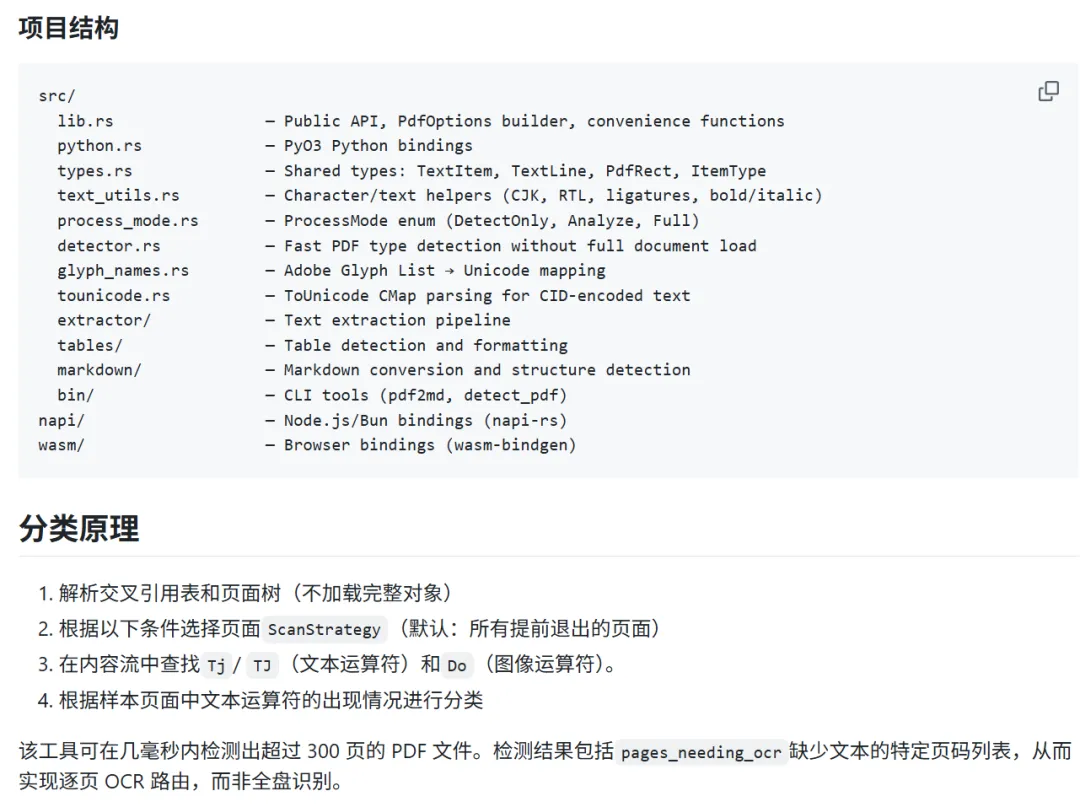
06 pdf‑inspector 适合谁 ✅ 强烈推荐使用人群 ✅ 不适合 pdf‑inspector 最大的创新点不在于技术有多炫酷,而是提供了一种务实高效的 PDF 处理思路:先预检,后分流,能本地解决绝不调用 OCR。如果你正在搭建文档处理管线,非常建议把它加到你的工具箱,放在 OCR 前面,充当第一道关卡。 项目地址: 07 扩展阅读 终身学习,深耕AI领域 持续分享,优质AI开源 感谢关注,携手AI同行
成本浪费:据统计约 54% 的 PDF 自带可选中的文本层,报告、论文、发票、合同这类文档根本不需要图像识别,全量 OCR 平白消耗大量接口费用、GPU 算力; 速度缓慢:云端 OCR 单页耗时 2‑10 秒,大批量文档场景下延迟会成倍放大; 识别出错:OCR 有可能凭空生成错字,破坏原有表格、标题的文档结构,反而降低知识库素材质量。
TextBased:文本型 PDF,自带文字层,直接本地提取;Scanned:扫描件 PDF,页面本质为图片,必须走 OCR;ImageBased:纯图片文档,没有任何可提取文字;Mixed:混合型 PDF,文档内一部分页面有文本,一部分页面为扫描图片。
pages_needing_ocr可以精确返回哪些页码需要 OCR 识别。举一个典型案例:一份 210 页财报文档,150 页自带文本、60 页扫描件。传统方案整本 OCR;接入 pdf‑inspector 后,仅 60 页送入 OCR,剩余全部本地解析,大批量场景成本降幅非常可观。EarlyExit(默认):遇到第一页非文本页面就停止扫描,适合绝大多数纯文本 PDF,几百页文档几十毫秒即可判定完成; Full 模式:遍历扫描全部页面,适合高精度混合型 PDF 检测; Sample (n) 抽样模式:仅抽样检测指定 N 页,用于超大 PDF 文档快速预检。
encoding issue标记,业务层可直接将该页面降级交给 OCR 兜底,不会悄无声息输出一堆乱码污染知识库。标题层级:依靠字号相对比值聚类自动识别 H1‑H4,聚类阈值 0.5pt; 列表识别:支持项目符号、数字序号、字母序号三类列表; 代码块:检测 Courier、Consolas、Fira Code 等宽字体,自动生成代码块; 富文本标记:粗体、斜体、上下标、超链接自动转为 Markdown 格式; 文本修复:自动合并跨行断开的英文单词; 冗余过滤:自动剔除页码、目录引导长串圆点; 分页标记:输出 <!-- Page N -->页面分割注释,开发者可在后处理自行过滤页眉页脚(当前版本暂未内置页眉页脚自动移除能力)。
矩形边框检测:解析 PDF 原始绘图指令,识别表格边框线条,使用并查集算法聚合单元格; 启发式对齐检测:无边框表格依靠文字坐标对齐规律,推断表格行列结构。
速度断层领先:200 份文档总耗时仅 0.47 秒,对比 PyMuPDF4LLM 快约 36 倍,MarkItDown 快 34 倍; 综合能力第一:综合得分、阅读顺序还原、表格识别三项指标全场第一; 微小短板:标题识别得分略低于 LiteParse,属于可接受范围。
[dependencies]pdf-inspector = "0.1"
usepdf_inspector::process_pdf;fnmain() -> Result<(), Box<dynstd::error::Error>> {let result = process_pdf("document.pdf")?;println!("PDF文档类型: {:?}", result.pdf_type);if let Some(markdown)= &result.markdown {println!("解析输出Markdown:n{}", markdown);}Ok(())}
pip install pdf-inspectorpip install maturinmaturin develop --release
import pdf_inspector# 完整解析:分类+提取+转Markdownresult = pdf_inspector.process_pdf("document.pdf")print(result.pdf_type)print(result.markdown)print(result.pages_needing_ocr)# 仅预检分类,不提取文本,速度更快detect_result = pdf_inspector.detect_pdf("document.pdf")if detect_result.pdf_type == "text_based":print("文本PDF,本地提取即可")else:print(f"需要OCR页面列表:{detect_result.pages_needing_ocr}")
npm install @firecrawl/pdf-inspectorimport { readFileSync } from'fs';import { processPdf } from'@firecrawl/pdf-inspector';const buffer = readFileSync('document.pdf');const result = processPdf(buffer);console.log(result.pdfType);console.log(result.markdown);
npm install @firecrawl/pdf-inspector-wasmimport init, { processPdf } from'@firecrawl/pdf-inspector-wasm';awaitinit();const response = awaitfetch('/document.pdf');const pdfBytes = newUint8Array(await response.arrayBuffer());const result = processPdf(pdfBytes);console.log(result.pdfType);console.log(result.markdown);
# 安装命令行工具cargo install pdf-inspector# PDF完整解析输出Markdownpdf2md document.pdf# JSON格式输出完整元数据pdf2md document.pdf --json# 指定页码解析,跳过不需要处理的页面pdf2md document.pdf --select-pages 1,3,5-10# 仅检测PDF类型,不提取内容detect-pdf document.pdf# 检测并开启布局分析,输出JSONdetect-pdf document.pdf --analyze --json
扫描件 PDF 无能为力:本身不包含任何 OCR 识别能力,扫描图像页面必须依赖第三方 OCR(PaddleOCR、Tesseract、云端 OCR 接口)兜底; 标题识别非全场最佳:跑分略低于 LiteParse,极少数文档标题层级识别可能出现偏差; 双栏排版极端复杂文档偶发文字顺序错乱,仓库 Issue 已有少量反馈; 中日韩特殊畸形字体解码异常:极少数加密、自定义字体 PDF 仍然会出现编码问题; 超大体积、大量矢量图形 PDF 解析耗时可能上升; 暂不支持页眉页脚全自动过滤,需要拿到 Markdown 结果后业务层自行后处理。
搭建 RAG 知识库、AI Agent 文档问答系统,每天大批量处理 PDF; 财报、法律合同、学术论文解析,表格文档占比较高; 需要浏览器端本地解析 PDF、对数据隐私敏感,文件禁止上传第三方服务器; 现有流水线全量调用 OCR,算力成本居高不下,想要降本提速; 私有化、气隙离线部署文档解析服务,无法调用外网 OCR 接口。
业务 PDF 绝大多数都是扫描件; 极度奇葩、自定义加密字体、非标准排版 PDF 占比极高。
https://github.com/firecrawl/pdf-inspector
23.9K+ Star!录音转写 + AI 摘要全程不上云,涉密会议零泄密风险 14.3K+ Star!AI Agent 时代开源统一身份认证!一站式搞定 SSO、IAM 与 MCP 鉴权 狂揽 57.9K+ Star!爆火开源多Agent 神器 !解决长任务失忆跑偏难题 23.4K+ Star!清华开源 AI 教育 Agent!55 万+ 创作者、100 万 + AI 课程,彻底改写知识学习方式 76K+ GitHub 星标!这款 AI 截图转代码工具一键转代码,解放 UI 复刻 90% 重复工作 36K+ 星标!148 个科研专用 Skill,让 Claude Code/Cursor 秒变全职科研助理 74.5K+ Star!越来越火的数据可视化平台,免费打造企业数据驾驶舱! 又一个 Agent 联网神器,不要 API Key,本地免费搜索 + 深度爬取 + 网页监控一站式搞定 12.4K+ Star!复刻Karpathy第二大脑,Claude+Obsidian落地LLM-Wiki,知识真正开始复利 31.7K+ Star!1100 + 大厂认证 AI 技能库,让 Cursor、Copilot、Claude 直接拥有一线团队工程经验 114K+ Star!OpenAI Codex Harness 完整开源,实测证明 Agent 成败不在模型而在运行时框架 一款能让 AI 帮你排查服务器的开源终端来了,把 AI、Docker、GPU 监控全部打包 腾讯朱雀开源 AI 红队工具:1900+CVE、14 大类 MCP 风险,给 Agent 做上线前安全体检 165.5K+ Star 的 DeepSeek Harness,终于有开源桌面版了。 GitHub 热榜 14MB、运行仅占 28MB 内存!Needle2 开源 45M 端侧 Agent,手表机器人离线跑工具调用 GitHub 40.4K+ Star!ToolJet 开源低代码,80+ 数据源搭建企业内部工具 461K+ Star 开源神仓!把全球免费 API 全部整理好,1400 + 接口,覆盖绝大多数开发场景 一夜6万星、3小时破3万!不是Claude竞品,而是它的操作系统,DeepSeek Harness如何重新定义Agent框架
关注我持续分享高质量内容