ARTICLE · 993423
08 AI 助手为什么会"跑着跑着就死了"?
—— 拆解 AI 编程助手的"上下文压缩"四层管线
一、一个所有 AI 用户都遇到过的场景
用 AI 编程助手写一个功能,前半小时它如鱼得水:读代码、改文件、跑测试,头头是道。
然后——它不动了。
没有报错,没有崩溃,就是停在那里,或者甩给你一句冷冰冰的"上下文太长,无法继续"。
发生了什么?
你让它读了一个 1000 行的文件,又读了 30 个文件,跑了 20 条命令。每一条命令的输出、每一个文件的内容,全都堆在它的"记忆"里。
AI 的记忆不是无限的。它叫上下文窗口(context window),满了之后,API 直接拒绝服务,返回 prompt_too_long——"提示词太长了"。
打个比方:AI 只有一张桌子。你每让它干一件事,它就把相关资料摊在桌上。桌子就那么大,东西越堆越多,最后连手都伸不进去,活儿自然就停了。
不解决这个问题,AI 根本没法在大项目里干活。
二、解决思路:便宜的先跑,贵的后跑
怎么解决?答案不是换一张更大的桌子(更长的上下文窗口不是没有,但永远有填满的一天),而是每次干活前,先把桌子收拾一遍。
但收拾也是有成本的。这里的"成本"很具体:整理动作要么是纯文本操作(免费,不调用大模型),要么要请大模型出马(贵,每调用一次都要花钱花时间)。
于是诞生了一个朴素却重要的设计原则:
便宜的先跑,贵的后跑。
也就是说:能用简单规则解决的,绝不动用大模型;只有简单规则实在搞不定了,才请大模型出手。
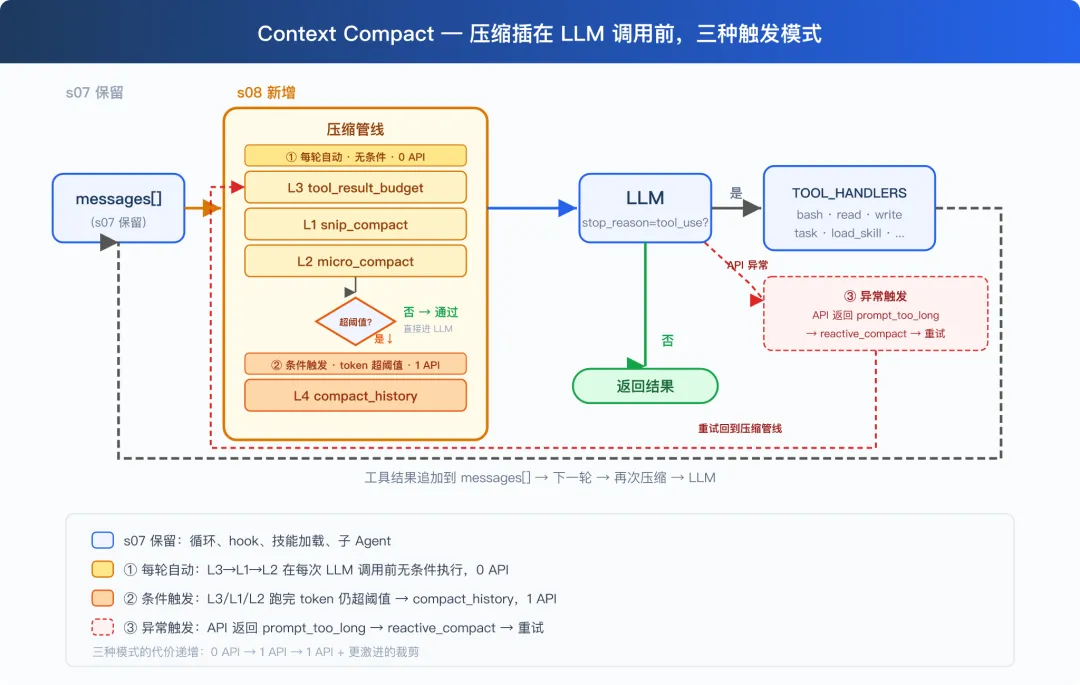
这套整理流程分四层,像四道筛子,一道比一道贵,一道比一道狠。
三、四层筛子,把上下文一层层"减负"
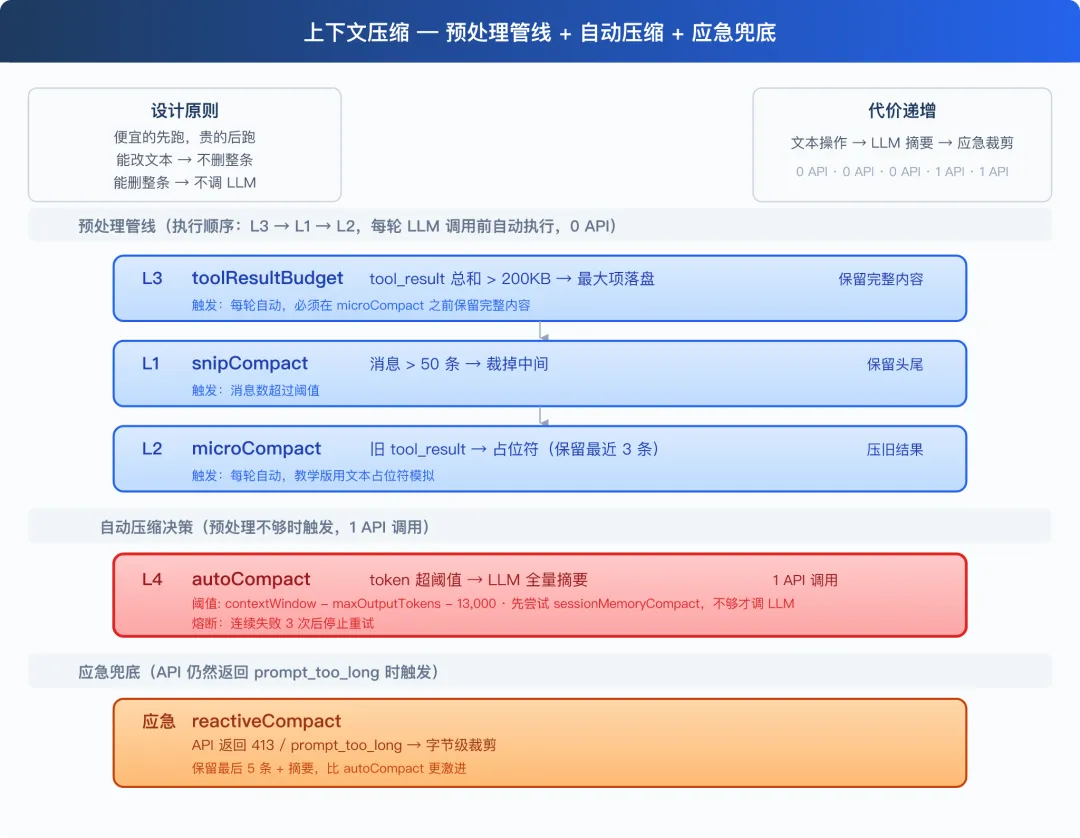
第一层:裁掉中间的老对话(几乎免费)
AI 跟你聊了 80 轮,最早的"帮我建个文件"和当前工作毫无关系了,但还占着位置。
第一层做的就是:只保留对话的开头(最初的背景交代)和最近的部分,把中间一大段直接裁掉,留个记号——"此处删掉了 N 条消息"。
就像整理聊天记录:开头知道你是谁,结尾知道在聊什么,中间那些客套和来回试探,划掉。
这一层纯做文本裁剪,不调用大模型,成本几乎为零。
唯一的讲究:裁的时候不能把"AI 调用工具"和"工具的返回结果"拆开,否则上下文就变成一堆对不上号的碎片。
第二层:旧工具结果占位(几乎免费)
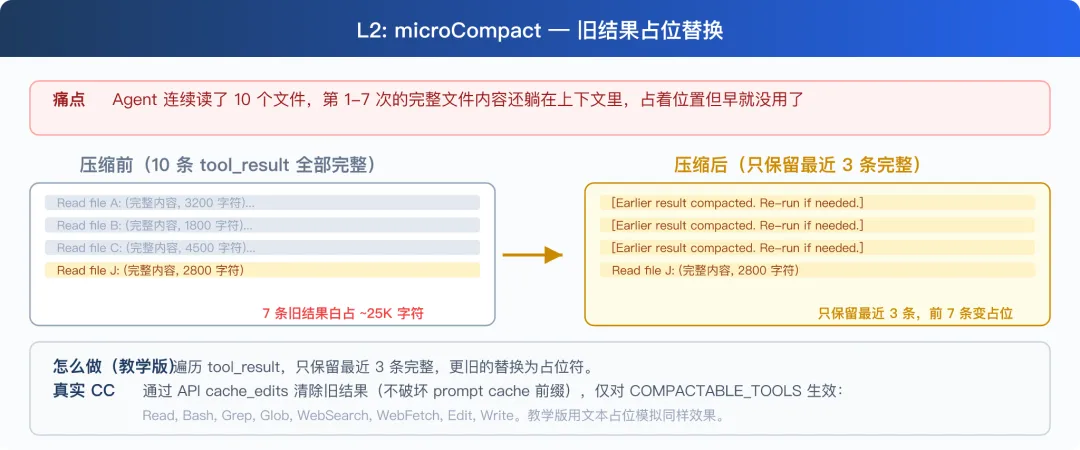
AI 连续读了 10 个文件。第 1 到第 7 个的完整内容还躺在上下文里,早就用不上了,却占着大量空间。
第二层做的:只保留最近 3 次工具调用的完整结果,更早的一律替换成一行字——"此处内容已压缩,需要时可重新读取"。
就像会议室的白板:写满了就擦,但只留一行"详见会议纪要",谁需要细节谁自己去翻。
这一层同样是纯文本操作,不调用大模型。
第三层:大结果落盘(免费,但要动手写文件)
有时候问题不是"旧内容太多",而是"单次内容太大"——一个 cat 大文件的输出就有 500KB,一次就能把上下文打满。
第三层做的:把超过阈值的大输出存到磁盘上的文件里,上下文里只留一个标记,附上前 2000 个字符的预览。模型看到标记就知道完整内容在哪,需要时可以再读回来。
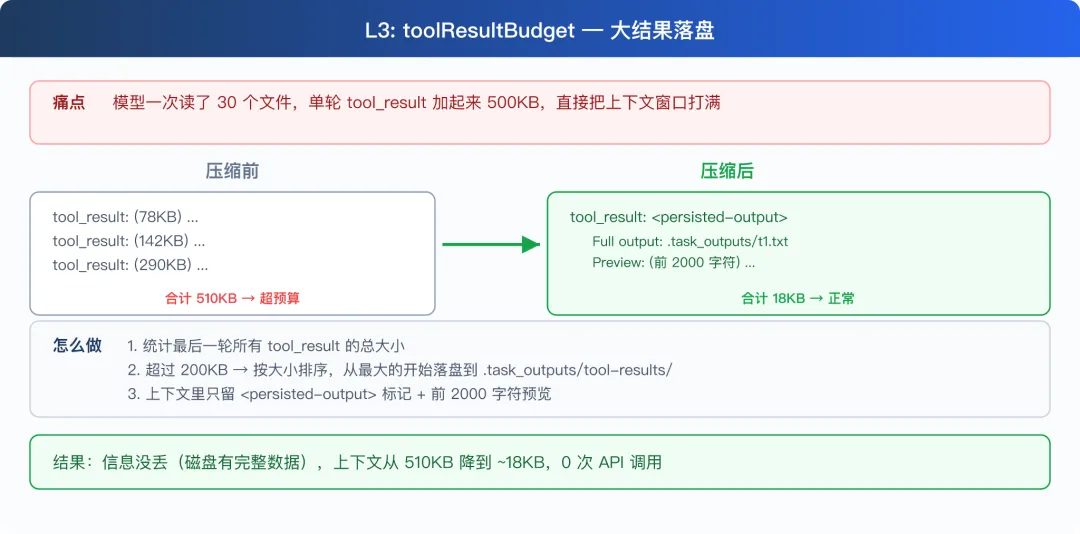
注意这里有个不能换的细节:第三层必须排在第二层前面。因为第二层会把旧的大结果替换成占位符——如果不先落盘,完整内容就真的丢了。顺序错了,数据就没了。
第四层:请大模型做全量摘要(贵,一次 API 调用)
前三层都是"整理",不花大钱。但在超大项目里连续干半小时,简单整理也压不住了。
第四层:先把完整对话保存成一份档案(transcript),然后请大模型把整个对话总结成一页纸——当前目标、重要发现、改过哪些文件、还剩什么活、你的要求。总结完,旧对话全部清掉,上下文里只剩这一页纸。
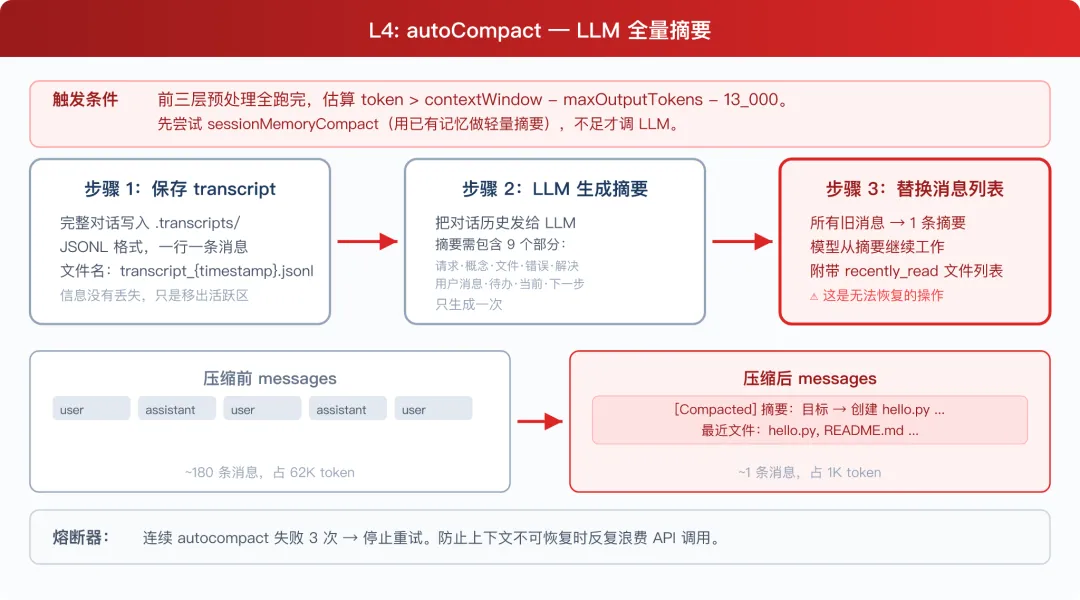
这一层贵,因为它要调用一次大模型。所以它只在前面三层都跑完、上下文仍然超阈值时才触发。
应急通道:API 报错了,灭火器上场
设计得再周到也有意外:上下文增长的速度比压缩触发还快,API 直接返回 prompt_too_long。
这时触发应急压缩:比第四层更激进,直接砍到只剩最后几条消息,再配一份摘要。它还有自己的熔断机制——连续失败 3 次就停止重试,绝不陷入"压缩→失败→再压缩"的死循环里烧钱。
四、动手试试:把四层筛子跑起来
光看原理不过瘾,这套管线其实很短——L1/L2/L3 加起来不到 60 行纯 Python,不依赖任何第三方库。我把整个教学版浓缩成了一个可运行的演示:它会伪造一段"跑了 123 轮、堆了 697KB"的对话,然后依次跑四层,你可以亲眼看到上下文一层层瘦下去。
把下面的代码保存为 demo_context_compact.py,然后运行:
python3 demo_context_compact.py# demo_context_compact.py — 四层上下文压缩管线最小可运行版# 纯标准库,无需安装任何依赖,无需 API Key。# (L1-L3 为 s08 教学版原文,L4 用假摘要代替真实 LLM 调用)from pathlib import PathTOOL_RESULTS_DIR = Path(”.task_outputs”) / ”tool-results”# ═══════════ 伪造一段”跑了很多轮”的对话 ═══════════def fake_messages():msgs = [{”role”: ”user”, ”content”: ”帮我写一个命令行工具 hello.py”}]for i in range(60):# 60 轮工具调用(每条结果约 600 字符)msgs.append({”role”: ”assistant”, ”content”: [{”type”: ”tool_use”, ”id”: f”t{i}”, ”name”: ”read_file”,”input”: {”path”: f”src/module{i}.py”}}]})msgs.append({”role”: ”user”, ”content”: [{”type”: ”tool_result”, ”tool_use_id”: f”t{i}”,”content”: (”def func_%d():\n return %d\n” % (i, i)) * 25}]})# 再补一条约 540KB 的大输出(模拟 cat 一个大文件),用于触发 L3msgs.append({”role”: ”assistant”, ”content”: [{”type”: ”tool_use”, ”id”: ”tbig”, ”name”: ”bash”,”input”: {”command”: ”cat data/dump.json”}}]})msgs.append({”role”: ”user”, ”content”: [{”type”: ”tool_result”, ”tool_use_id”: ”tbig”,”content”: '{”rows”: [' + ','.join(f'[1,”row-{i}”,{i}]' for i in range(30000)) + ']}'}]})return msgs# ═══════════ L1: 裁掉中间的老对话 ═══════════def _has_tool_use(m):return m.get(”role”) == ”assistant” and any(b.get(”type”) == ”tool_use” for b in m.get(”content”, []) if isinstance(b, dict))def _is_tool_result(m):return m.get(”role”) == ”user” and any(b.get(”type”) == ”tool_result” for b in m.get(”content”, []) if isinstance(b, dict))def snip_compact(messages, max_messages=50):if len(messages) <= max_messages:return messageshead_end, tail_start = 3, len(messages) - (max_messages - 3)# 切口保护: 不能把 tool_use 和它的 tool_result 拆开if _has_tool_use(messages[head_end - 1]):while head_end < len(messages) and _is_tool_result(messages[head_end]):head_end += 1if _is_tool_result(messages[tail_start]) and _has_tool_use(messages[tail_start - 1]):tail_start -= 1return (messages[:head_end]+ [{”role”: ”user”, ”content”: f”[snipped {tail_start - head_end} messages]”}]+ messages[tail_start:])# ═══════════ L2: 旧工具结果占位 ═══════════def micro_compact(messages):results = [(m, b) for m in messages if m.get(”role”) == ”user”and isinstance(m.get(”content”), list)for b in m[”content”] if isinstance(b, dict) and b.get(”type”) == ”tool_result”]if len(results) <= 3:# 只保留最近 3 条完整内容return messagesfor _, b in results[:-3]:if len(b.get(”content”, ””)) > 120:b[”content”] = ”[Earlier tool result compacted. Re-run if needed.]”return messages# ═══════════ L3: 大结果落盘(上下文只留标记 + 预览) ═══════════def tool_result_budget(messages, max_bytes=200_000):last = messages[-1]if not last or last.get(”role”) != ”user” or not isinstance(last.get(”content”), list):return messagesblocks = [(i, b) for i, b in enumerate(last[”content”])if isinstance(b, dict) and b.get(”type”) == ”tool_result”]total = sum(len(str(b.get(”content”, ””))) for _, b in blocks)if total <= max_bytes:return messagesfor _, b in sorted(blocks, key=lambda p: len(str(p[1].get(”content”, ””))), reverse=True):if total <= max_bytes:breakTOOL_RESULTS_DIR.mkdir(parents=True, exist_ok=True)path = TOOL_RESULTS_DIR / f”{b.get('tool_use_id', 'x')}.txt”if not path.exists():path.write_text(str(b[”content”]))b[”content”] = (f”\nFull output: {path}\n”f”Preview:\n{str(b['content'])[:2000]}\n”)total = sum(len(str(x.get(”content”, ””))) for _, x in blocks)return messages# ═══════════ L4: 全量摘要(演示用假摘要,真实实现是调 LLM) ═══════════def summarize_history(messages):return (”当前目标:写命令行工具 hello.py。已读取 60 个模块,接口已掌握。””剩余工作:编写 CLI 入口、接入 argparse、补充单元测试。””用户约束:Python 3 语法、无第三方依赖。”)def compact_history(messages):return [{”role”: ”user”, ”content”: ”[Compacted]\n\n” + summarize_history(messages)}]# ═══════════ 合起来跑(顺序不能换: budget → snip → micro → 摘要) ═══════════def estimate_size(msgs):return len(str(msgs))if __name__ == ”__main__”:msgs = fake_messages()orig = estimate_size(msgs)print(f”伪造对话: {len(msgs)} 条消息, {orig/1000:.0f}KB”)msgs = tool_result_budget(msgs); print(f”L3 落盘后: {estimate_size(msgs)/1000:.0f}KB”)msgs = snip_compact(msgs); print(f”L1 裁剪后: {estimate_size(msgs)/1000:.0f}KB / {len(msgs)} 条”)msgs = micro_compact(msgs); print(f”L2 占位后: {estimate_size(msgs)/1000:.0f}KB”)msgs = compact_history(msgs); print(f”L4 摘要后: {estimate_size(msgs)/1000:.2f}KB”)print(f”总压缩率: {100 * (1 - estimate_size(msgs) / orig):.1f}%”)
运行后你会看到这样一串输出(数字可能略有出入):
伪造对话: 123 条消息, 697KBL3 落盘后: 62KBL1 裁剪后: 26KB / 52 条L2 占位后: 10KBL4 摘要后: 0.14KB总压缩率: 100.0%
697KB 的对话,最终只剩 0.14KB。注意观察每一步:L3 把那 540KB 的大输出存到了 .task_outputs/tool-results/(真实工程里这就是"需要时重新读"的完整数据),L1 把 123 条消息裁到 52 条,L2 把旧结果换成占位符,L4 则把整个对话浓缩成一页摘要。
建议动手改一改:把 max_messages 从 50 改成 20、把"保留最近 3 条"改成 1 条,观察压缩率怎么变——你会直观体会到"压缩力度"和"信息损失"之间的取舍。