ARTICLE · 994153
科研范式正被重写:AI 如何走进生命科学研究的每一个环节
过去,科研效率很大程度上取决于研究者手里有多少工具;而现在,更具决定性因素的,是提出科学问题的能力,以及将问题转化为可执行、可复现、可验证研究路径的手段。
AlphaFold2 将许多蛋白质结构问题,从可能耗时数月乃至数年的实验探索,转变为数分钟至数小时内即可获得的高质量计算预测;不过预测结构目前仍不能普遍替代实验解析,尤其在无序区域、多构象状态、配体诱导变化、突变效应及复杂相互作用体系中。
通过重构研究方法,智能体(Agentic)平台正在逐步消弭"提出科学问题"与"跑完整套分析"之间的鸿沟。如果把“走进生命科学”定义为在一个核心基础科学问题上取得跨越式、广泛可见且可规模化的突破,AlphaFold2 可以被视为最重要的拐点之一。2024 至 2026 年间 MNC 高调宣布进军 AI 制药更是将既已发生的范式转变推至聚光灯下。
因此,这场变革最深刻的落点,并不在于某款"明星药物",而在于"研究"本身被重新定义。从假设提出、实验设计到数据分析,整条链路正在被重写。
一、AI 走进科研的三个阶段
AI 走进生命科学研究经历了至少三次具有范式意义的跃迁。
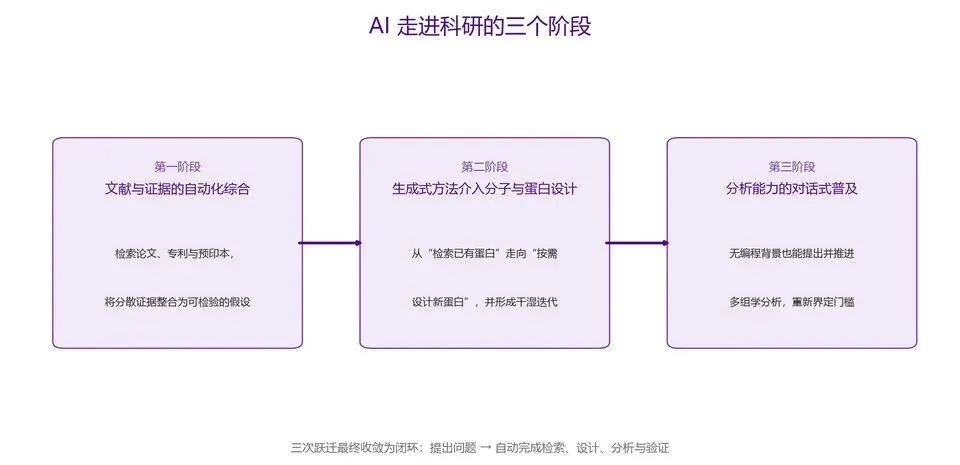
第一阶段,文献与证据的自动化综合。数十年来,科学假设高度依赖研究者在广泛阅读后形成的直觉。如今,文献与证据挖掘智能体能够系统性地检索论文、专利与预印本,将分散的证据整合为可检验的假设。在检索策略、证据分级和人工复核机制设计良好的前提下,AI 可以覆盖更多证据,使检索与筛选过程更容易审计。
第二阶段,生成式方法介入分子与蛋白设计。AlphaFold2 于 2020 年在 CASP14 中对多数单体蛋白给出接近实验的精度,相关论文、开源代码与结构数据库在 2021 年陆续发布,为随后兴起的生成式蛋白设计提供了重要技术和观念基础。RFdiffusion、ProteinMPNN 等方法使研究者从"在自然界中检索已有蛋白"走向"按需设计新蛋白"。更上游,生成式模型开始参与分子生成,并形成"干湿闭环",即模型设计的候选物在湿实验中验证,结果再反馈至模型,形成自我强化的迭代。
第三阶段,分析能力的对话式普及。这一阶段与一线科研者距离最近。过去完成一套多组学分析需要编程能力、流程知识与计算环境配置;而 AI 智能体平台将数据管理、自动化机器学习与可视化封装为可对话的接口,使不具备编程背景的研究者也能提出并推进分析。研究能力的门槛被重新界定。
需要注意的是,"智能体工具"与过去的"辅助式工具"存在本质差异:辅助式工具提升单点操作效率,而智能体能够接管一段完整工作流,自主调度多个子工具并迭代。正是这一差异,使"提问即研究"从概念走向现实。
三次跃迁并非彼此独立,而是最终收敛为一个闭环:提出问题 → 自动完成检索、设计、分析与验证。
这也是 AI for Life Science 区别于既往"实验室信息化"的本质,因为它改变的并非工具效率,而是研究的组织方式。
二、价值链上的不同角色
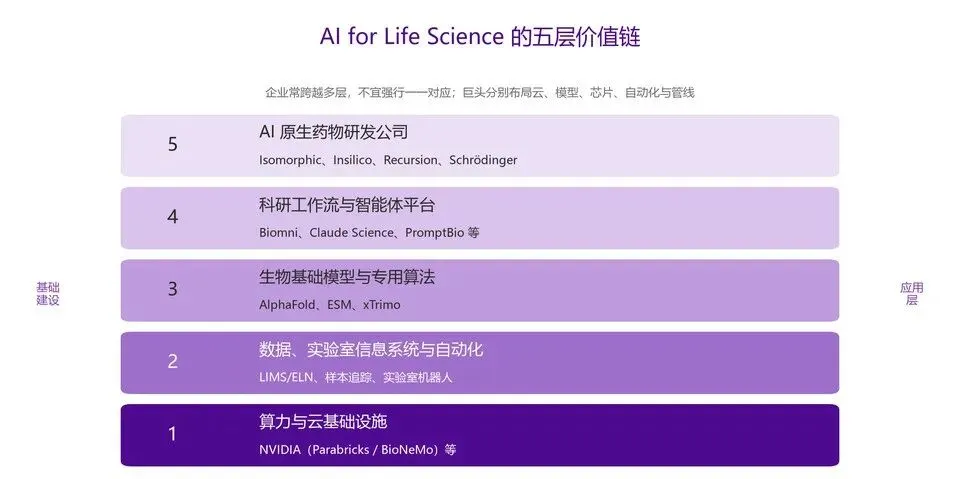
按价值链功能划分,AI for Life Science 的参与者大致可归为五层,且多数企业同时跨越多层。
第一层是算力与云基础设施。以英伟达为代表,它不仅提供 GPU,还通过 Parabricks(基因组学分析)与 BioNeMo(生物基础模型与智能体工具)向上延伸到软件、模型乃至智能体工具层,并不只是"卖芯片"。算力之外,云服务商与高性能计算集群构成了模型训练和推理的物理底座。
第二层是数据、实验室信息系统与自动化。样本追踪、LIMS/ELN(实验室信息管理与电子实验记录)、标准化实验协议与实验室机器人,是"干湿闭环"得以成立的物理基础,也是许多 AI 能力落到实验端的先决条件。
第三层是生物基础模型与专用算法。这一层提供通用的生物表示能力,代表包括 DeepMind 的AlphaFold 系列、Meta 与 EvolutionaryScale 的 ESM 系列、以及百图生科(xTrimo)等。
第四层是科研工作流与智能体平台。它们把检索、分析、可视化与报告串成可审计的流程,并封装为可对话的接口,是科研者日常直接接触的一层。Biomni、Claude Science、PromptBio 即处于这一层,将前述基础模型与分析能力整合为对话式工作流。
第五层是 AI 原生药物研发公司。Isomorphic Labs、英矽智能、Recursion、Schrödinger 等大多采用"平台加自有或合作管线"的垂直整合模式,既输出工具,也推进自有药物管线。
三、必须正视的现实约束
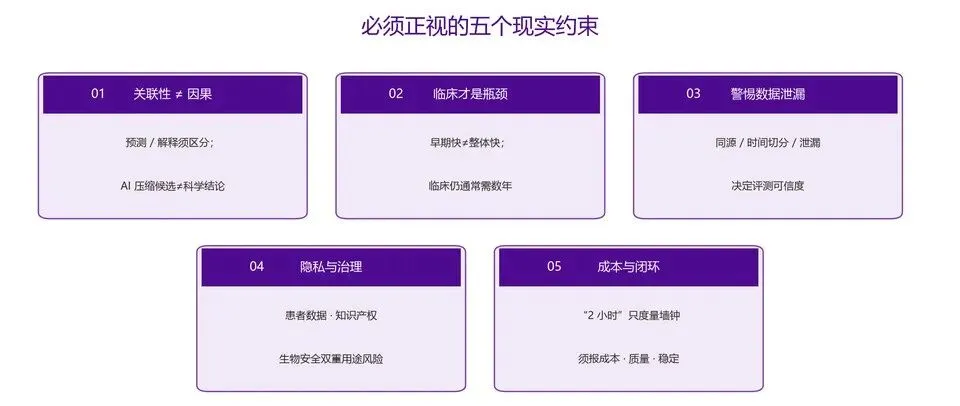
在乐观叙事之外,有五道约束必须被正视。
第一,相关性、预测、因果与验证需要区分。模型发现相关性,不等于找到因果机制;预测结构,不等于证明功能;预测靶点,不等于证明疗效;生成候选分子,也不等于具备安全性与临床价值。AI 可以压缩候选空间、提升实验优先级,但最终结论仍依赖适当的实验、统计与临床验证。
第二,临床开发才是真正的瓶颈。即使模型把早期筛选从数周缩短到数小时,也不意味着研发周期按同比例缩短。临床试验中的受试者招募、终点选择、疗效异质性、安全性、生产与监管通常仍需数年。截至 2026 年,尚无一款被业界普遍认定为由 AI 从头发现并设计的药物完成监管批准;已有部分AI 辅助发现或设计的候选进入临床阶段。
第三,评测可信度高度依赖对数据泄漏的控制。训练集与测试集的同源性、时间切分是否严格、患者级数据是否泄漏、批次与站点效应、负样本定义、外部队列验证、基准是否被训练数据污染、是否与简单基线公平比较,这些往往比模型架构更决定结论是否成立。可靠的平台还应输出证据等级、置信区间与不确定性,区分已知事实、模型推断与假设,主动报告冲突证据,保留失败运行并设置人工审批节点。"可追溯"不等于"正确",一个被完整记录的错误流程依然是错误流程。
第四,隐私、知识产权与数据治理不可回避。当平台处理患者组学或未公开研发数据时,需要回答数据是否用于训练、存放在哪里、是否支持本地或私有化部署、权限与审计如何落地、是否满足伦理与数据保护要求、AI 生成方案的知识产权归属,以及第三方模型与数据库的许可是否允许商业使用。生成蛋白、病毒设计、病原体优化等能力兼具研究价值与滥用风险,序列筛查、高风险工具访问控制、合成服务商筛选、权限分级与人工审查应被视为底线要求。
第五,实验自动化与成本需要被如实呈现。所谓"干湿闭环"通常还依赖实验室机器人、LIMS/ELN、标准化协议、样本追踪、机器可读结果,以及主动学习或贝叶斯优化对失败实验的结构化反馈。应当区分计算闭环、人工执行的干湿迭代、实验室自动化闭环与真正的自主实验系统。此外,"2 小时完成"一类的表述只度量了墙钟时间,评价平台至少应同时报告速度、成本、质量、稳定性与人工投入,以及在多少任务上能够稳定成功,而非依赖单个展示案例。是否存在第三方基准也不能单独作为可信度指标,因为基准可能狭窄、被污染或与实际任务不一致;前瞻性的真实任务与独立复现通常更具参考价值。
四、评估平台的六个维度
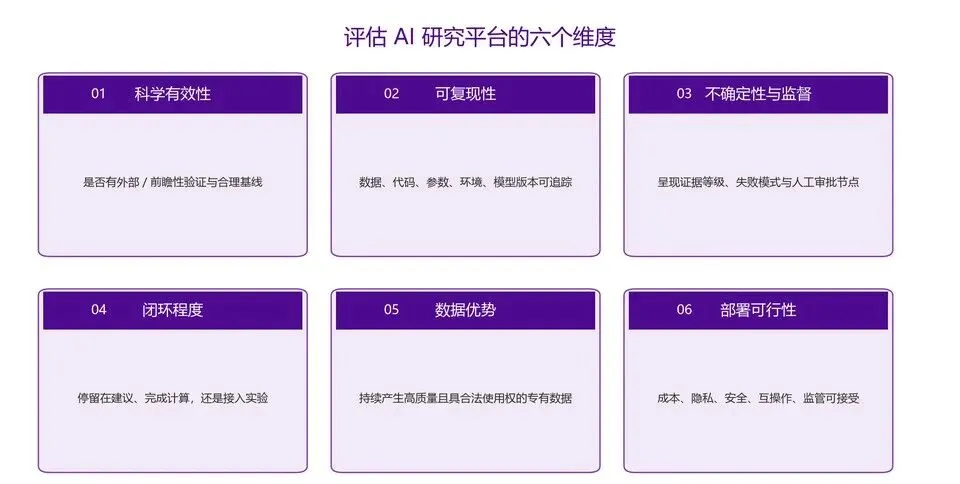
面对层出不穷的"AI 科研平台",如何快速判别其成色?可看以下六个维度。
1. 科学有效性:是否有外部验证、前瞻性验证和合理基线。
2. 可复现性:数据、代码、参数、环境、模型版本是否可追踪。
3. 不确定性与监督:是否呈现证据等级、失败模式和人工审批节点。
4. 闭环程度:停留在建议、完成计算,还是接入实验并用结果更新决策。
5. 数据优势:是否持续产生高质量专有数据,以及这些数据是否具有合法使用权。
6. 部署可行性:成本、隐私、安全、互操作性、监管和组织工作流是否可接受。
回看这一轮变化,真正值得记录的,未必是某一项具体能力的突破,而是科学研究"入口"的迁移。过去,进入一个领域要先翻过工具、环境与方法的围墙;如今,提出一个问题,正成为越来越多人走得进去的那扇门。这本身具有方法论之外的意义:当检索、分析与初步设计可以被分担,科学有机会不再只属于装备齐整的少数实验室。
但入口变宽,不等于结论变轻。模型可以替我们检索、计算与提议,却替我们承担不了怀疑、验证与接受证伪的责任。预测不等于机制,规模不等于证据,速度不等于正确——这些边界不会因为工具更强而消失,只会更频繁地出现在每一个急于下结论的时刻。换言之,这一轮范式迁移真正交还给研究者的,不是更少的功课,而是更纯粹、也更难的功课:让 AI 去做重复的工作,把精力放在提出对的科学问题,并为答案负起责任。