ARTICLE · 994336
GPU 原生数据库:解开 AI 智能体落地的底层枷锁
过去两年,大模型从"会聊天"快速走向"会办事",企业里越来越多业务开始交给 AI 智能体来跑。可一旦深入到生产环境,开发者普遍会发现一个尴尬的现象:智能体框架迭代了好几轮,提示词也调了无数版,但整套系统还是慢、还是卡、还是只能在演示环节“跑得很顺"。
更棘手的是响应时延。Agent 跑一个稍微复杂的任务,动辄要发起几十甚至上百次数据查询,每次都要等几秒返回,并发量一上来就积压排队。同时企业里数仓、向量库、记忆库往往各跑一套,数据在多套系统之间来回同步,不仅开发调试繁琐,运维成本也居高不下。
很多人会把这些问题归咎到大模型身上,反复换模型、调参数,结果收效甚微。问题真正的根源在于:AI 时代的数据库需求和过去完全不同了,而底层数据底座几乎没有跟着变。
一、使用者变了:数据库正在从服务人类转向服务AI 智能体
人类使用数据库,往往是打开报表、看几个汇总数字,等几秒完全可以接受。但AI 智能体的使用模式完全不同:它要在毫秒级时间里,自动拆解业务目标、连续发起成百上千次调用,既要查业务数据,也要跑语义检索,还要调取会话历史维持上下文。
传统CPU 数据库最初是为人的查询习惯设计的——单核性能强、并行度有限、内存带宽通常在百 GB/s 级别。面对 Agent 这种"机器对机器、海量并发、毫秒级响应"的新负载,原来的设计优势反而成了瓶颈。更关键的是,大模型推理跑在 GPU 上,数据却依然存在 CPU 侧,每一次调用都要跨 PCIe 总线来回搬运数据——这就是行业里常说的"内存墙"难题。模型再快,也快不过数据搬运。
市面上也有一些"GPU 加速"方案,但绝大多数只是把 GPU 当成外挂协处理器:核心计算依然在 CPU 上跑,只有少量算子下推 GPU 加速。这样的方案无法消除数据在 CPU 内存与 GPU 显存之间反复搬运的开销,提升幅度有限,扛不住真实业务压力。
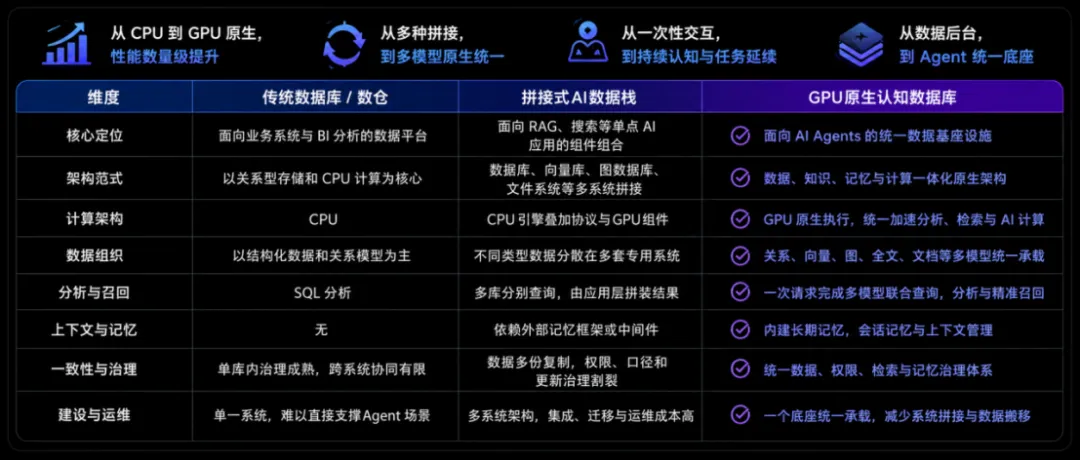
二、GPU 原生架构:让数据库真正"住"进 GPU
针对这一痛点,GPU 原生数据库选择了一条更彻底的技术路线:把整库执行引擎、存储管理、事务处理全部迁移到 GPU 上运行,而不是简单挂一个加速器。
全栈运行在GPU。数据过滤、关联聚合、向量检索、记忆召回这些核心算子全部在 GPU 显存内完成,CPU 只负责协调调度。GPU 拥有上万颗并行计算核心和 TB/s 级的高带宽显存,单卡算力是传统 CPU 服务器的数十甚至上百倍,复杂查询从过去的分钟级压缩到秒级甚至亚秒级。
GPU 直连存储。新一代 GPU 原生数据库普遍引入了"由 GPU 直接发起存储访问"的技术路径,绕过 CPU 与主机内存,避免数据在多级缓存之间反复中转。这样一来,从数据落盘、计算处理到模型推理,可以全部跑在统一的 GPU 加速体系内,端到端时延被进一步压缩。
横向扩展到多卡多节点。单卡容量终究有限,企业级GPU 原生数据库普遍支持把数据分布到多张 GPU 卡甚至多台 GPU 服务器上,节点之间通过高速互联保持一致性与查询并行度,支撑亿级到百亿级的数据规模。
性能差距体现在真实业务里。多家研究机构在TPC-DS、TPC-H 等权威基准上的对比测试显示,GPU 原生数据库对主流开源分析型数据库能实现数十倍到上百倍的性能提升,对主流公有云数据仓库也有数倍至数十倍的综合性价比优势,机器学习类查询的加速比同样可观。
这里也澄清一个常见误区:GPU 硬件单价高,不等于整套方案贵。任务效率实现百倍级提升之后,完成同等业务所需时间和硬件规模大幅下降,长期来看单任务成本反而更低。
三、一体化底座:让Agent 不再"拼乐高"
搭建一个能落地的AI 应用,企业过去往往要做"系统拼装":数仓做统计、向量库做语义检索、KV 库做记忆、图数据库做关系分析——每套系统独立部署、独立维护,数据在多套组件之间来回同步。
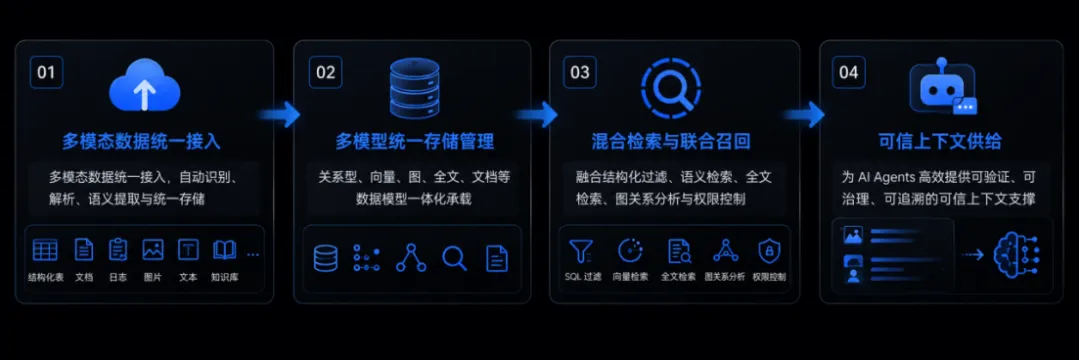
GPU 原生数据库的核心思路,是把这些能力收敛到同一套引擎里:
多模数据统一管理:结构化业务数据、向量、文档、图、全文、时序等多种数据模型在同一个底座上统一存储、统一权限治理。
混合检索能力:支持向量相似度检索与传统SQL 条件过滤的混合查询。例如"找出华东区最近三个月销售额过百万、且客户画像最相似的群体",一条语句就能完成。
一体化记忆系统:内置长期记忆与短期上下文管理,Agent 可以直接调取历史会话和业务记忆,不再需要外挂一套独立的记忆库。
自然语言交互:内置Text-to-SQL 与大模型协同能力,业务人员用日常语言描述需求,就能完成数据查询与分析;同时也支持传统 SQL、Python、API 等多种调用方式。
这样的好处是直观的:少部署几套系统、少维护几份数据副本、少处理几条同步链路。开发团队可以从繁琐的数据搬运工作中抽身,把精力放到真正产生业务价值的算法和场景上。
四、生产级稳定性:演示跑得通,更要生产扛得住
Agent 落地的另一个隐形门槛是稳定性。Demo 环境查询简单、数据量小,很多方案都能给出漂亮数字。但真实业务里,SQL 语句往往非常复杂,几十张表关联、子查询嵌套、并发混合负载,一个查询没写好就可能拖垮整个集群。
GPU 原生数据库的稳定性建设通常体现在几个方面:
复杂查询优化器:针对多表关联、嵌套子查询、高基数字段过滤等复杂场景做深度优化,避免单一慢查询拖慢整库。
资源隔离与多租户:支持按业务、按部门做细粒度的资源分配和访问控制,重要查询不会被低优先级任务挤占算力。
完整基准测试验证:在TPC-DS、TPC-H 等公开基准下做长期压力测试,确保在数百倍加速比的同时,查询结果准确率与传统数据库一致。
混合负载并发能力:同一集群内同时运行分析查询、向量检索、记忆读写等多种类型任务,彼此之间不会相互干扰。
换句话说:演示能跑通是基本功,规模化生产环境下依然稳定高效才是真本事。
五、定位澄清:它是Agent 的数据地基,不是替代大模型
需要明确一件事:GPU 原生数据库不是大模型,也不会替代现有的大模型和 Agent 框架。
它的定位非常清晰——做 AI 智能体的数据底座和记忆载体。模型负责思考和推理,数据库负责提供真实、可信、实时的业务数据和知识。具体来说:
为模型提供真实业务数据,缓解大模型"幻觉"问题。
统一管理企业知识库,让私域知识可以随时被检索和引用。
承载Agent 的长期记忆,让多轮对话、跨任务状态可以被持久保存。
部署上,这类数据库既支持私有化部署,也提供云上服务,可以和主流大模型平台、Agent 开发框架无缝对接,企业可以根据自身合规和成本要求灵活选择。
当然,GPU 原生数据库也不是"万能数据库"。它更适配 AI 智能体、海量复杂分析、混合检索这类场景;传统的事务型业务、高频小事务处理,依然更适合用成熟的 CPU 数据库来承载。
六、写在最后:AI 落地比拼的,是底层基础设施
行业里对AI Agent 的关注点,往往集中在大模型能力、上层应用和提示词工程。但越来越多的落地实践提醒我们:上层应用的能力边界,终究受限于底层数据底座。
如果底层还在用面向人类设计的传统CPU 数据库,哪怕 Agent 框架设计得再精巧,面对 AI 带来的高并发、混合负载、毫秒级响应,依然会撞上性能天花板。Demo 可以跑通,规模化生产却举步维艰。
GPU 原生数据库,给行业提供了一条新的解题思路:顺着 AI 智能体真实的业务负载重构底层架构,把数据库原生运行在 GPU 之上,打通大模型和业务数据之间的硬件隔阂。数百倍性能只是表象,更核心的价值,是降低企业落地 AI 智能体的工程复杂度,让 AI 真正走进业务流程。
AI Agent 的产业实践还在持续推进,未来会涌现更多技术路线。但可以确定的是:只有把数据读取、计算、检索、记忆这些底层问题解决好,AI 智能体才能在千行百业稳定落地,而 GPU 原生数据库,正是其中一条值得长期跟踪的方向。