ARTICLE · 995699
AI-native 软件开发,时间去了哪?
不知道有没有人和我一样的感受——
产品开发团队全面用上 AI 之后,交付周期确实被大幅压缩,进度条以前所未有的速度往前冲。
但另一个问题也随之变得突出,AI 一次生成的代码、测试、文档和变更记录体量惊人。它们看起来都很完美,却未必能立刻证明实际效果。于是,我和团队不得不频繁按下暂停键,把更多时间投入评审、测试与风险判断。
最近,Anthropic 发布了《The AI-Native SDLC Playbook》。其中一张图描绘了一个很有代表性的过渡状态,当 AI 已将 Build 大幅压缩、而周边流程仍沿用原有做法时,瓶颈会转移到 Plan、Test 与 Deploy 等其他环节。
这里的 SDLC 指 software development lifecycle,即软件开发生命周期。
手册更进一步讨论了如何重构 Plan、Design、Build、Test、Deploy 与 Maintain 六个阶段,减少交接、等待和重复劳动。
AI 确实能让多个环节变快。但当生成速度超过验证能力时,评审、测试与治理负担往往会随之增加,并抵消一部分原本可能释放的时间。
01 · ORIGINAL VIEW
第一张图:Build 不再是瓶颈
在《The AI-Native SDLC Playbook》开篇部分,作者 Louis Claxton 用下面这张图清晰的展示了 AI 时代软件开发周期的变迁。
在 Before agents ,软件开发周期被分为6个阶段 —— Plan、Design、Build、Test、Deploy、Maintain。每个阶段都主要按人类的速度运行,其中 Build 占据最长的一段时间(橙色部分)。
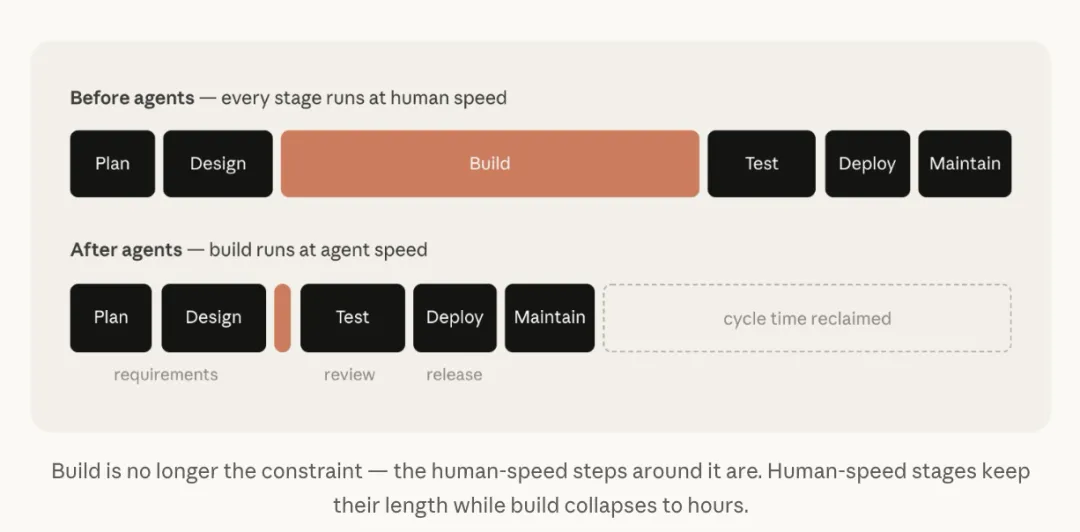
图一 build 阶段不再是最大阻碍
在 After agents 中,Build 被压缩成一个很窄的橙色方框,AI 使得这个阶段大幅压缩了时间,Build 已经不再是约束。约束转移到了它周围仍以 human speed 运行的几个阶段;这些阶段的长度保持不变,而 Build 缩短到以小时计算。
因此,图中出现了一块很长的虚线框 cycle time reclaimed。它表达的是如果其他条件暂时不变,仅仅把原本漫长的 build 阶段压缩掉,整个交付周期就能回收出一大块时间。
这张图的重点是表达了瓶颈转移:
软件开发周期的瓶颈会移到 Build 左右两侧,主要是 Plan、Review/Test 和 Deploy 过去依赖人工逐行检查的控制方式会越来越难以维持 如果人类仍然按周或按月召开的会议和委员会来处理异议,治理成本就会上升。
安全团队原本是按人的产出规模配置的。当 Agent 成倍增加代码产出时,要么评审队列越来越长,要么代码在评审不足的情况下发布。对组织来说,这两种结果都不能接受。
02 · ALTERNATIVE VIEW
第二张图:被压缩的不只有 Build
正如手册里提到的 AI-native SDLC 的目标不是只压缩 Build,而是重构六个阶段及其衔接,使每一阶段都减少等待、交接和重复劳动。
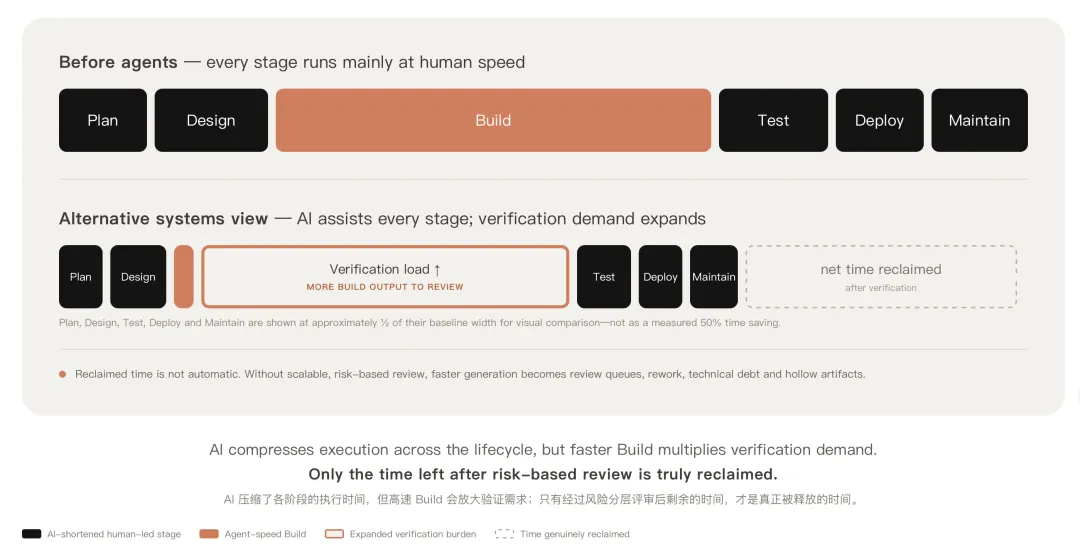
图二:为了视觉上能很快看出差别,图中的阶段压缩比例、Verification load 与 net time reclaimed 均为示意,不代表真实测量结果或结论。不同团队、系统和风险等级,实际改善幅度会相差很大。
Build 仍然被压缩成很窄的橙色方框,但在 Build 与 Test 之间,我增加了一个独立的 Verification load 方框。
它并不是传统 SDLC 中新增的第七个固定阶段,而是表示 AI 高速产出带来的一层额外负担。更多代码需要证明,更多测试需要判断是否有效,更多文档需要确认是否真实,更多变更需要检查是否符合意图、架构、安全和合规要求。
虽然其中大部分机械检查可以自动完成,但涉及业务意图、架构取舍、风险接受和例外处置的判断,不能只交给 AI。
因此,Agent 生成的产出物在进入人类的正式评审前,应先完成基础自检,并携带一组可检查的证据,来减轻评审负担。
这些证据可以是测试结果、构建日志、截图对比、静态检查、策略检查,以及实现与 spec.md、plan.md 的一致性结果。
03 · NET TIME
为什么第二张图里的净回收时间可能更短
两张图还有一个差别,是右侧虚线框的长度。
第一张图里的 cycle time reclaimed 较长,Build 大幅缩短,而周边阶段暂时保持不变,被压缩掉的 Build 时间直接表现为回收的周期。
第二张图里的 net time reclaimed 可能会更短一些。虽然多个阶段都因 AI 得到压缩,但其中一部分时间也许会重新投入验证、治理和人的判断。
我想用一个简化的概念关系来表示:
NET TIME RECLAIMED
真正回收的时间 ≈ 各阶段被 AI 压缩的时间 − 新增的验证与治理成本
这一现象,并非只来自个人观察。
DORA(DevOps Research and Assessment)是由 Google Cloud 运营的研究项目,长期关注软件交付与运维效能。
DORA 在一篇于 2026 年 3 月 10 日更新的专题分析中,对 1,110 条来自 Google 软件工程师的开放式问卷回答进行了主题研究。
分析显示,AI 在生成阶段节省下来的时间,往往又被投入到审计与验证中。开发者可以很快生成规模很大的 PR,但评审者需要理解和核验的内容也随之增加,认知负担反而更重。
为此,DORA 建议将自动检查尽量前移到作者侧;使用能够理解组织上下文的评审 Agent;同时坚持小批量变更,让每一次改动都保持可评审、可测试。
查看案例原文:https://dora.dev/insights/balancing-ai-tensions/
这里最大的风险,是把生成更快误判为交付吞吐更高。
如果 Agent 一天能生成十份方案、二十个 PR 和大量配套文档,而团队仍只能认真评审其中很少一部分,那么增加的不是有效产出,而是在制品、等待队列和形式化文件。
04 · OPERATING RULES
关键不是增加人工评审,而是重构验证体系
如果 AI 产出增长十倍,而仍要求人逐行评审十倍代码,这种模式很难持续。真正需要提高的是验证强度,不一定是人工阅读量。
有几个实践中的做法:
1. 先设置进入 Build 的条件
对于准备进入正式实现或合并的变更,如果没有以下内容,就不应直接进入 Build。:
明确的 intent 和验收标准 变更边界,以及明确不做什么 风险等级 预期测试和验证方法 负责最终判断的人
这层条件不是为了增加文档,而是为了避免 AI 为模糊需求批量制造看上去完整的产物。
2. 强制小批量和在制品上限
AI 最危险的地方,可能不是某一行代码质量差,而是低成本的大变更变得太容易了。
一个 PR 只解决一个可验证问题 设置 diff、文件数量和复杂度预算,超过阈值就拆分,或先做设计评审 为每名工程师同时等待评审的变更数量设置上限 旧任务进入验证阶段后,才启动新的 Agent 任务
SDLC 手册建议从两到三个并行会话开始,并指出,实际的上限取决于一个人能够认真评审多少条工作流。DORA 也把小批量工作列为应对 AI 大规模变更的关键措施。
它们指向同一个原则 —— 让 Build 的产出速度服从验证能力,而不是让验证团队被生成速度拖着跑。
3. 把机器检查前移到作者侧
提交给人之前,产物至少应该自动通过:
编译、类型、lint、单元测试和集成测试 静态分析、依赖检查和安全扫描 intend.md、spec.md、plan.md与实际 diff 的一致性检查未覆盖路径和边界条件分析 回滚可行性检查 文档、迁移脚本与配置同步检查
评审者收到的不应该是“请帮我检查这堆代码”,而应该是 “ 这是变更目的、风险、自动检查证据、仍未解决的问题,以及需要你判断的三个地方 ” 。
4. 把作者 Agent、独立评审 Agent 与人类判断分开
不能只让同一个上下文里的 Agent 产生方案,再证明自己的方案正确,它会继承同一套假设和盲点。
可以考虑把验证分成三个层级:
确定性检查
负责测试、类型、lint、安全规则和结果验证。
独立评审 Agent
对照 intent、spec 和 plan 检查遗漏、矛盾与风险。
人类专家
判断需求、架构、业务后果、风险接受和例外。
Anthropic 在 Agent eval 方法中也建议组合使用代码型、模型型和人工 grader,而不是依赖单一评估方式。
查看案例原文:https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
5. 人工评审按风险分层
人工最应该判断的不是代码风格,而是五个问题:
解决的是不是正确的问题? 变更有没有跨越原定边界? 测试是在证明业务行为,还是只复述生成代码的假设? 失败时会发生什么,能否观测和回滚? 哪些不确定性仍未解决?
研究型非营利机构 METR 在两个大型开源仓库中选取了 18 个真实任务,并对其中 15 个 Agent PR 进行了人工整体评审。研究使用 Claude 3.7 Sonnet 与基础 Agent scaffold,对照维护者编写的测试和人工整体评审结果。
结果显示,即使部分 PR 通过维护者编写的测试,仍可能需要补充测试覆盖、文档、格式和可维护性工作,才能达到可合并状态。
这个结果不能代表所有团队,也不意味着最新 Agent 都会出现同类问题。但它提醒我们的是 —— 功能测试通过,只证明了部分可自动验证的目标,并不等于产物已经整体可接受。
查看案例原文:https://metr.org/blog/2025-08-12-research-update-towards-reconciling-slowdown-with-time-horizons/
05 · ARTIFACT DISCIPLINE
防止产出物沦为形式
可以给所有产出物设置一条简单规则:
只产出真正会被使用的内容:它要么服务于用户或系统,要么帮助做决策,要么用于验证结果;三者都不具备,就不必生成。
例如:
intent.md —— 用于决定是否进入设计spec.md —— 用于决定方案是否可接受plan.md —— 用于约束实现边界测试用于证明可观察的业务行为 评审报告只记录会影响批准决定的问题
因此,软件团队不能只考核生成了多少代码、PR、测试或文档。
至少还应观察:
从 intent 到可验证上线的周期 评审队列等待时间 一次评审通过率和返工轮数 变更失败率、逃逸缺陷和部署返工率 生成的产物中,实际被下游读取或用于决策的比例
AI-native SDLC 最容易造成的错觉,是把执行动作变快直接等同于软件交付变快。
而被 AI 省下来的时间,只有在完成验证之后,才真正属于团队。