ARTICLE · 996252
这个GitHub工具太香了:扔进去一本PDF,AI直接帮你"吃透"整本书!
你有没有过这种经历?
年初咬牙花大几百买了本技术书,吭哧吭哧读完了,感觉收获满满。结果过了仨月,突然想查里面某个知识点,翻遍书架找不着。好不容易找到了,对着四百多页的PDF干瞪眼,完全记不得那东西在第几章。
问AI吧,它要么瞎编一通,要么直接说"我没这内容"。你把整本PDF丢进对话框?还没等你开口问,上下文就爆了。
做笔记?也不是没做过。可那些笔记文档散落在各个文件夹里,文件名起得稀里糊涂,最后照样找不到。
这种痛苦,懂的都懂。
直到我在GitHub上挖到 book-to-skill 这个项目,才发现原来还有这么聪明的解法。
它到底是个啥?
简单说,这玩意儿能把你的书、文档、资料夹,一键打包成 Claude Code(或者 GitHub Copilot CLI、Amp)的"技能文件"。
啥意思呢?就是AI以后能随时调用这本书里的知识,而且不是瞎蒙,是照着原文回答你。
它的 mascot 是个紫色小巫师,叫 Booklin,挺可爱的。
跟直接把PDF塞进AI那种笨办法不同,book-to-skill 会先对书做一轮"深度解剖"——拆框架、抽术语、建索引、分章节。最后生成一套结构化的技能文件,AI用到哪章才加载哪章,完全不浪费 token。
官方测过,比整本书丢进上下文省 24 到 51 倍 的 token。这个数字挺吓人的。
支持哪些格式?
基本上你平时能见到的文档格式,它都能吃:
PDF(最常用) EPUB(电子书) DOCX(Word) Markdown / HTML / RTF MOBI / AZW / AZW3(Kindle格式) 甚至直接扔一个文件夹进去也行
处理的时候它会问你:这是技术书还是叙事类书籍?
技术书的话,它走 Docling 那条线,表格、代码块、公式都能原样抽出来,精度高,就是慢点,大概一页要 1.5 秒。叙事类或者纯文字的书,用 pdftotext 之类的工具,秒级搞定。
安装步骤(超简单)
装这个东西有两种路子,看你习惯哪种。
路子一:当 Agent Skill 装(推荐)
这种方式装完,你在 Claude Code 里直接敲 /book-to-skill 就能用。
Claude Code 用户:
打开你的 Claude Code,复制下面这句话丢进去:
Install book-to-skill: https://raw.githubusercontent.com/virgiliojr94/book-to-skill/master/SKILL.md等它装完就行了。
或者你喜欢手动操作,也行:
git clone https://github.com/virgiliojr94/book-to-skill.git ~/.claude/skills/book-to-skillGitHub Copilot CLI 用户:
git clone https://github.com/virgiliojr94/book-to-skill.git ~/.copilot/skills/book-to-skill然后进 copilot 会话,执行:
/skills reload/skills info book-to-skill跨平台通用路径(Amp 也认):
git clone https://github.com/virgiliojr94/book-to-skill.git ~/.agents/skills/book-to-skill嫌 git clone 麻烦?还可以用 npx:
npx skills add virgiliojr94/book-to-skill一行命令,哪个平台都能用。
路子二:当独立 CLI 装
如果你只是想用它的文本提取功能,不当 skill 用,那就 pip 装:
pip install "book-to-skill[pdf,epub,docx]"装完以后可以跑:
book-to-skill --check这个命令会告诉你哪些提取器已经装好了,缺啥它会提示你。
使用前的小准备
不同格式的书,需要不同的"解锁工具"。不过别慌,大部分常用工具装起来都不费劲。
PDF 相关的:
# 纯文字书用这个,速度飞快sudo apt install poppler-utils# 技术书用这个,保留表格和代码pip3 install docling# 备选方案pip3 install pypdfpip3 install pdfminer.sixEPUB 相关的:
pip3 install ebooklib beautifulsoup4其他格式:
# Word 文档pip3 install python-docx# HTMLpip3 install beautifulsoup4# RTFpip3 install striprtf装完以后,建议先跑一遍检查:
python3 scripts/extract.py --check它会列出来你当前能处理哪些格式,缺啥一目了然。
怎么用?手把手教你
装好了之后,用法简直不要太简单。
第一步:转换一本书
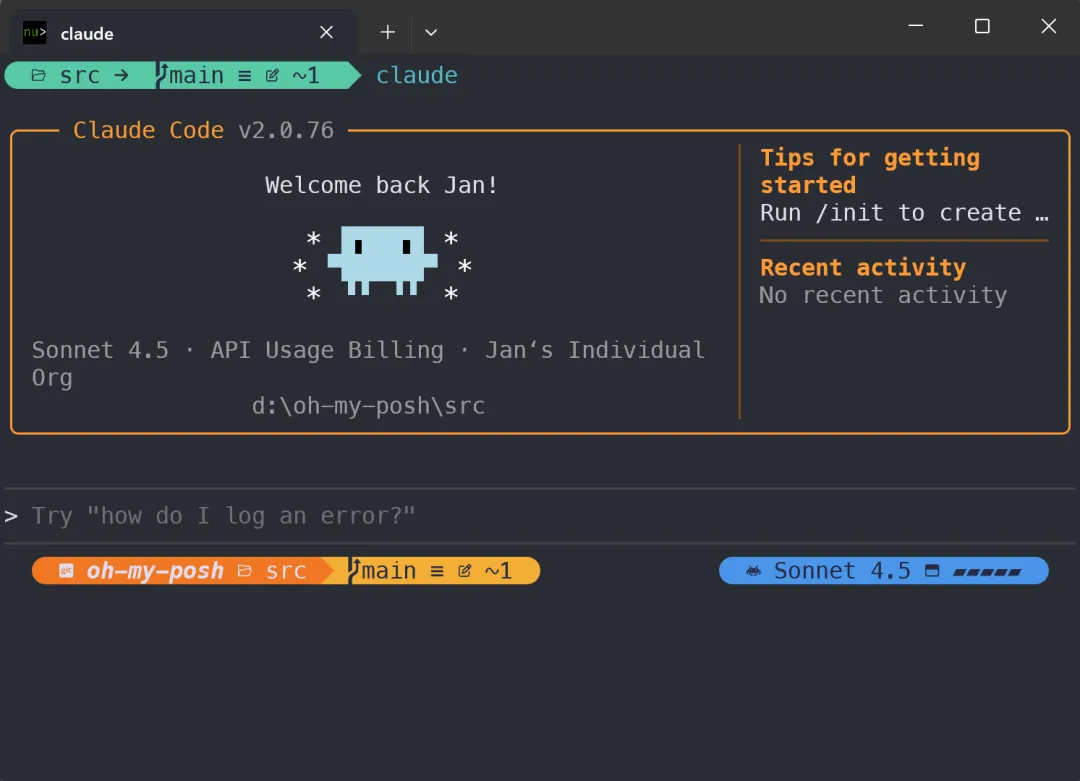
在 Claude Code 里,直接敲:
/book-to-skill ~/path/to/your-book.pdf你也可以扔一个文件夹:
/book-to-skill ~/Documents/my-tech-books/甚至支持 glob 模式:
/book-to-skill ~/papers/*.pdf回车之后,它会先问你这是技术书还是文字密集型书籍。你回答就行,然后它就开始干活了。
第二步:等它"消化"
这个过程它会干好几件事:
提取文本 —— 把PDF里的文字、表格、代码块扒出来 分析结构 —— 识别书名、作者、章节、目录 生成摘要 —— 每章来一段 800-1200 token 的总结 整理术语 —— 把专业词汇做成 glossary 提炼模式 —— 把设计模式、算法、决策规则单独存一份 输出技能包 —— 生成 SKILL.md + 分章文件 + 速查表
最终会在你的 skills 目录里生成这样一套东西:
~/.claude/skills/your-book/├── SKILL.md # 核心框架 + 章节索引(约4000 token)├── chapters/│ ├── ch01-xxx.md # 第一章,按需加载(约1000 token)│ ├── ch02-xxx.md # 第二章│ └── ...├── glossary.md # 术语表(约1500 token)├── patterns.md # 模式汇总(约2000 token)└── cheatsheet.md # 速查表(约1000 token)第三步:随时提问
书转好了,以后想问啥直接问。
比如你的书 slug 叫 design-patterns,你就敲:
/design-patterns singletonClaude 就会去加载对应章节,照着原文给你讲清楚单例模式,不会瞎编。
再比如:
/design-patterns 第三章的工厂方法它直接定位到那一章,精准回答。不用你翻PDF,不用烧大量 token,更不会 hallucination。
几种进阶玩法
book-to-skill 不止能"一次性转换",它还支持几种很实用的模式:
只分析不生成:
/book-to-skill ~/book.pdf --analyze-only先让 AI 看看这本书结构咋样,你心里有个数。
从已有的分析结果生成:
/book-to-skill --generate-from-analysis ~/previous-analysis/省得重复分析,加快流程。
追加新内容:
/book-to-skill ~/new-chapters/ --update existing-skill-name书出了新版?或者你后来又攒了一批论文?直接 fold 进去,原来的 skill 自动升级。
实际体验下来咋样?
我试了一本一百来页的技术书,用 Docling 模式跑,花了大概两分多钟。纯文本模式的话,真的是秒出。
精度方面,代码块和表格确实保留得不错。不过如果是那种扫描版PDF(图片形式的),它会直接报错提醒你先去 OCR,这点挺贴心的,不会傻乎乎跑半天输出个空文件。
有个小提醒:冷门书或者排版特别诡异的书,生成完最好自己过一遍。毕竟"合成质量"比"抽取速度"更重要,对吧?
另外,如果你是想在几十本书之间做横向检索,那可能 NotebookLM 更合适。book-to-skill 真正强的场景是:把一本书或一组核心资料吃透,然后无缝嵌入你的工作流。写代码的时候随手一问,比去翻PDF高效太多了。
隐私方面放心吗?
放心。所有处理都在你本地跑,你的书不会被上传到任何地方。生成的技能文件本质上是你自己的"结构化笔记",不是原文复制,所以合理使用是没问题的。
当然啦,别人写的书生成的 skill 别到处乱发,自己用就行。
写在最后
以前我们想让AI读懂一本书,第一反应就是把PDF往上怼。现在回头看,那做法确实挺笨的。
book-to-skill 换了个思路——先让AI把书"吃透、拆碎、整理好",再问的时候按需取用。书架上那些吃灰的技术书,终于有机会重见天日了。
下次你再想翻某本念念不忘的书,不妨先喂给这个小巫师试试。
GitHub地址:https://github.com/virgiliojr94/book-to-skill