ARTICLE · 997709
AI on the HK * 视觉智能前沿纪要
欢迎来到小行星M78
年轻人的聚集地
2026视觉AI,到底发生了什么❓
2026年,视觉AI的核心竞争力正在经历一次深层转变——从"看见"和"生成",向"理解视频 → 理解空间 → 建模世界 → 模拟世界 → 自主行动"的统一智能体系演进。
这一转变并非单一技术突破所驱动,而是七条研究主线——视频智能、空间智能、生成智能、视频生成、世界模型、AI智能体、物理智能——的同步推进与交叉融合。与此同时,生成式AI与影视/媒体产业的融合正在加速,学术视觉能力正走向内容生产工作流的产业落地场景。
AI on the HK聚焦生成式AI与影视/媒体/创意产业的深度融合,以香港作为亚太内容产业枢纽,探索AI在电影制作、数字内容、虚拟制片和创作者工作流中的产业落地路径。
📌 核心总结
▎ Video MLLM 竞争重心从模型规模转向高质量后训练与推理效率
▎ 空间智能(Spatial Intelligence)成为2026年增长最快的研究方向
▎ 生成模型竞争进入"效率+可控性+一致性"新阶段
▎ 世界模型是最值得关注的长期统一框架(但仍属开放问题)
▎ AI Agent 是学术视觉能力通向影视生产工作流的关键桥梁
全景架构:七大研究方向与三层能力体系
01 AI × 影视产业
AI如何进入影视、媒体和内容生产?
2026年,生成式AI正以前所未有的速度渗透影视与媒体产业——从AI Studios、AI辅助电影制作到创作者工作流自动化 Byedance Studios等头部机构已将AI深度融入生产链路。
本文采用"AI产业场景 + <AI on the HK>工业界前沿研究"的交叉框架展开,探讨学术能力如何转化为产业生产力。
二、Video Intelligence 视频智能
AI能否走向"理解事件、时序、空间与因果"?
视频智能是视觉AI从静态图像走向动态世界理解的核心战场。2026年的研究重心已从单纯扩大模型规模,转向高质量后训练(RL post-training)、样本效率、时空推理和推理成本优化。
而这条线索的起点比 LLM 早得多——1943 年,英国心理学家 Kenneth Craik 就预言:大脑里维护着一个"现实的小尺度模型",行动前先在脑子里跑一遍。80 年后,它正被这些大佬用各自的方式变成现实。
OraRL : Annotations as Rollouts
Efficient and Scalable Reinforcement Learning for Video MLLMs · arXiv:2608.20492
📋核心问题
Video MLLM的强化学习后训练面临两大瓶颈:RL rollout生成成本高昂(视频任务中尤甚),advantage estimation在视频感知任务中存在inversion问题。
🔬 方法创新
• Annotations as Oracle Rollouts:将已有标注从reward信号扩展为oracle rollout,避免昂贵的在线采样
• Decoupled Advantage Estimation
• Sign-balanced Pruning:提高训练效率
• 面向统一视频感知(temporal grounding tracking segmentation)
📊 实验结果(论文/项目页报告)
⚖️ 局限性
作为2026年8月发布的预印本,尚未经过同行评审。Oracle rollout策略依赖已有高质量标注的可用性,在标注稀缺的领域可能受限。统一视频感知的完整性仍需更多任务和数据集验证。
🔮 研究意义
OraRL代表了Video MLLM从"视频问答模型"向"统一视频感知模型"演进的重要一步,但不能据此宣称Video MLLM已完成统一——更严谨的表述是:研究正在朝unified video perception方向演进。
三、Spatial Intelligence 空间智能
空间智能是2026年视觉AI增长最快的研究方向之一。三项代表性工作分别从3D重建、空间VLM和全局空间感知三个角度推进了 2D → 3D → Spatial Intelligence 的技术路线。
SAM 3D : 3Dfy Anything in Images
CVPR 2026 Open Access, pp.7220–7232 · arXiv:2511.16624(首次公开2025-11)· Byedan
📋 核心问题
如何从单张自然图像重建具有几何、纹理和布局信息的3D物体,尤其在存在遮挡和复杂场景的真实世界条件下?
🔬 方法创新
• 单图3D重建:同时预测geometry、texture和layout
• Human-and-Model-in-the-Loop数据引擎:构建约314万网格的大规模训练数据
• 三阶段训练范式:借鉴LLM的pretraining → mid-training → post-training
• Synthetic pretraining + Real-world alignment:从合成数据到真实世界
📊 实验结果(论文报告)
人类偏好测试胜率:至少 5:1
⚠️ 这是human preference test的win rate,不是3D benchmark上的领先
⚖️ 局限性
单图3D重建本身存在固有的几何歧义问题;MITL数据引擎的构建成本高,可复制性需要验证;对极端遮挡或罕见物体类别的泛化能力有待更多测试。
🔮 研究意义
SAM 3D标志着3D重建从"受限场景"向"开放世界"的重要跨越,其数据引擎思路(human + model in the loop)为大规模3D数据生产提供了可扩展的范式。
SpatioLM
•核心创新:不依赖额外3D prior input,通过plug-and-play spatio-vision module激活VLM中已有的空间知识
• 监督方式:使用pseudo depth / camera information作为监督信号
• 作者报告:VSI-Bench达到71.6
• 定位:从"3D重建"向"VLM原生空间推理"延伸,是空间智能的重要补充路径
GST-Bench
•核心问题:长时间连续视频中的全局空间感知——从局部理解走向全局场景表示
• 任务:egocentric observation → global top-down map + novel viewpoint
• 规模:6,790分钟合成视频基准测试
• 作者报告:最强zero-shot模型 42.68 vs 人类 79.08
• 定位:Video Intelligence与Spatial Intelligence的重要交叉方向
💡 洞察:42.68 vs 79.08的巨大差距表明,全局空间感知仍是当前VLM的显著短板,这为未来研究指明了明确方向。
四、Generative Intelligence 生成智能
AI走向高质量、低延迟、低成本、可控的内容生成?
生成模型的竞争正在从"质量"进一步进入"效率 + 可控性 + 一致性"新阶段。Pixel-space训练路线的重新回归,是这一阶段最引人注目的研究趋势之一。
Pixel-Space Text-to-Image Diffusion
📋 核心问题
当前主流文生图模型依赖latent space训练(通过VAE压缩),pixel-space直接训练是否可行?效率和质量能否兼得?
🔬 核心发现
• 大规模直接pixel-space pretraining比latent-space收敛明显更慢
• 提出latent-to-pixel两阶段训练策略:先在latent space获取generative prior,再转入pixel space post-training
• 系统研究initialization、data composition、prediction target、decoder、noise schedule
• 推理无需VAE解码器,实现端到端加速
📊 推理加速(论文报告)
⚖️ 局限性
目前没有足够证据支持"pixel space已全面取代latent space"的判断。该工作是实证研究,其结论的泛化性仍需在更多架构和规模上验证。
🔮 研究意义
Pixel-space是一个正在重新获得关注的重要技术路线,其"去掉VAE"的思路可能对推理效率产生深远影响。但latent vs pixel的最优解仍是开放问题。
五、Video Generation 视频生成
从单帧生成到连续、可控、时空一致的动态世界生成
视频生成是AI与影视产业关联度最高的研究方向之一。当前研究正沿着明确的演进路线推进:
在影视制作场景中,视频生成面临的核心挑战不仅是画质,更是角色一致性、场景连续性、镜头运动可控性和时空物理合理性。这些需求正在倒逼生成模型从"看起来好"走向"结构上对"。
• Text-to-Video / Image-to-Video:基础生成能力持续提升
• Camera Control:精确镜头运动在影视制作中至关重要
• Character / Object / Scene Consistency:跨帧一致性是产业化的前提
• 3D-aware Video Generation:空间智能与生成的交叉前沿
• Long Video Generation:从短片段到完整叙事的关键跨越
六、World Model 世界模型
AI能否学习世界的状态、动态规律,并预测或模拟未来状态?
世界模型是本研究最重点关注的"核心前沿层"。它被视为潜在的统一中间层——连接理解、建模与生成——但目前仍属于开放研究问题,而非已被证明的终点。
🔗 与核心论文的连接:
• OraRL:annotation → oracle rollout,训练范式创新指向世界级学习
• SAM 3D:human + model in the loop → 可扩展的3D世界数据构建
• 两者代表数据飞轮的不同实现路径,但不应被描述为同一个技术
七、AI Agent & Physical AI
从"回答视频问题"到"基于视觉信息自主完成任务"
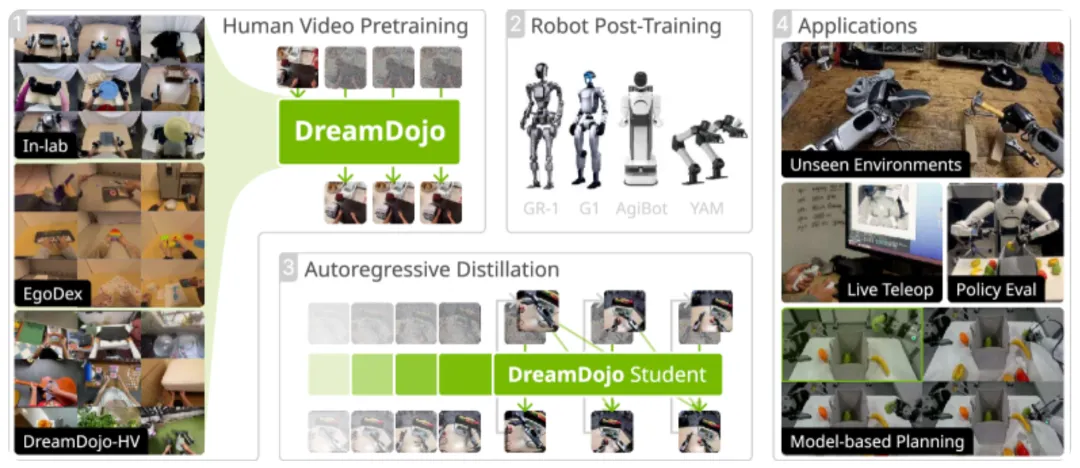
AI Agent是学术视觉能力与影视生产工作流之间的关键桥梁。视觉AI与产业的真正连接点,不只是"AI生成视频",而是——AI能否进入完整的内容生产workflow。
🤖 Physical AI / Embodied AI —— 物理智能
Physical AI代表视觉智能从"数字内容理解/生成"向"现实世界行动"的更长期演进。其技术路线为:
Vision → Spatial Intelligence → World Model → Planning → Vision-Language-Action → Embodied Agent
⚠️ 该方向作为"长期前沿"呈现。它与影视产业不是直接同一应用领域,但代表了视觉智能的终极演进方向。
八、五大交叉研究前沿
2026年最值得关注的方向交汇
① Video × Spatial
视频不仅是时间序列,也是空间世界的连续观测。代表:OraRL、GST-Bench、SpatioLM
② Spatial × Generation
生成模型能否产生具有稳定3D geometry的内容?方向:3D-aware generation、camera-consistent generation
③ Video × Generation
从"理解视频"走向"生成视频":Understand → Edit → Generate → Simulate
④ Generation × World Model
生成模型是否可以成为世界模拟器?这是前沿假设(emerging hypothesis),非已确立事实
⑤ World Model × Agent
长期最重要的交叉:Perception → World Model → Planning → Action → Feedback 闭环
九、2026–2028 技术演进路线图
四条主线的并行演进(趋势研判,非确定性预测)
十、2026研究前沿七大判断
判断一:
视觉AI核心竞争从"感知"(classification/detection/segmentation)转向"理解"(reasoning/grounding/spatial understanding/long-video understanding)
判断二:
Video MLLM正在从"视频问答模型"向"统一视频感知模型"演进。OraRL是典型案例,但不能宣称"已完成统一"——研究正在朝unified video perception方向演进
判断三:
Spatial Intelligence是2026年视觉AI非常重要的增长方向。SAM 3D、SpatioLM、GST-Bench分别从3D重建、空间VLM、全局空间感知三个角度推进 2D → 3D → Spatial Intelligence
判断四:
生成模型竞争进入"效率+可控性+一致性"新阶段。Pixel-space是正在重新获得关注的重要技术路线,但不能简单得出pixel space一定优于latent space
判断五:
World Model是最值得关注的长期统一框架,应被视为"潜在的统一中间层"——但目前仍属于开放研究问题,不是已被证明的终点
判断六:
AI Agent是"模型能力→产业应用"的桥梁。视觉AI与产业的真正连接点是:AI能否进入完整的内容生产workflow
判断七:
长期路线可能从Digital AI进入Physical AI。Digital Perception → Digital World Model → Digital Agent → Physical World Model → Embodied Agent。这属于更长期研究趋势
CONCLUSION
2026年视觉AI的核心变化,不再只是让AI"看见"和"生成",而是正在向"理解视频 → 理解空间 → 建模世界 → 模拟世界 → 自主行动"的统一视觉智能体系演进,并加速从模型能力走向影视与内容生产工作流的产业落地。
参考文献
[1] OraRL — Annotations as Rollouts: Efficient and Scalable RL for Video MLLMs. arXiv:2608.20492, 2026-08. 预印本
[2] SAM 3D — 3Dfy Anything in Images. CVPR 2026, pp.7220–7232. arXiv:2511.16624. Meta. 同行评审
[3] Pixel-Space Diffusion — An Empirical Study of Training Pixel-Space T2I Diffusion Models. arXiv:2608.16887, 2026-08. 预印本
[4] SpatioLM — Towards General Physical Spatial Intelligence in VLMs. arXiv:2608.01899, 2026-08. 预印本
[5] GST-Bench — Can VLMs Develop Global Spatial Awareness from Video? arXiv:2608.05747, 2026-08. 预印本