ARTICLE · 997716
4.4毫秒转14种文档:Firecrawl 用 Rust 重写了 RAG 的隐藏瓶颈
一、问题:文档入口的碎片化,是 RAG 最后一块没被工程化的荒地
过去两年,RAG 和 Agent 把注意力几乎全砸在模型侧——向量化、chunking 策略、重排序、多路召回。但你只要真的搭过一条文档摄入管道,就会撞到同一堵墙:没有一个库,能把用户随手丢进来的各种办公文档,稳定地转成干净的 Markdown。
一个 .docx 合同要接 mammoth,一个 .xlsx 财报要接 openpyxl,一个 .pptx 路演要接 python-pptx,碰上 2009 年导出的老 .xls,还得 shell 出去调 LibreOffice 转一圈。结果是四个工具、四套依赖、四种输出形状、四种各自的失败模式。最阴险的是:同一个表格,在你的 docx 路径里转义正确,在你的 rtf 路径里就变成乱码——因为这两个序列化器根本不是一个人写的。
后果传导到下游极其致命。一个合并单元格在提取层被拍平成乱码,会污染它后面的每一个 chunk,再强的 reranker 也救不回来。检索质量的天花板,从来不在检索,而在它上游的"垃圾进"。
Firecrawl 这家公司,做的正是"把网页抓取做成 LLM 基础设施"的生意。它自己跑生产,比谁都清楚这个痛。于是 2026 年 8 月 3 日,它把答案开源了:anydoc,一个纯 Rust 库,把 Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV、PDF 一共 14 种格式,收束成同一个函数调用,输出同一份 GitHub 风格的 Markdown。上线不到一个月,19,669 颗星。
二、机制:不是"每格式一个工具",而是"一个模型收束 14 种格式"
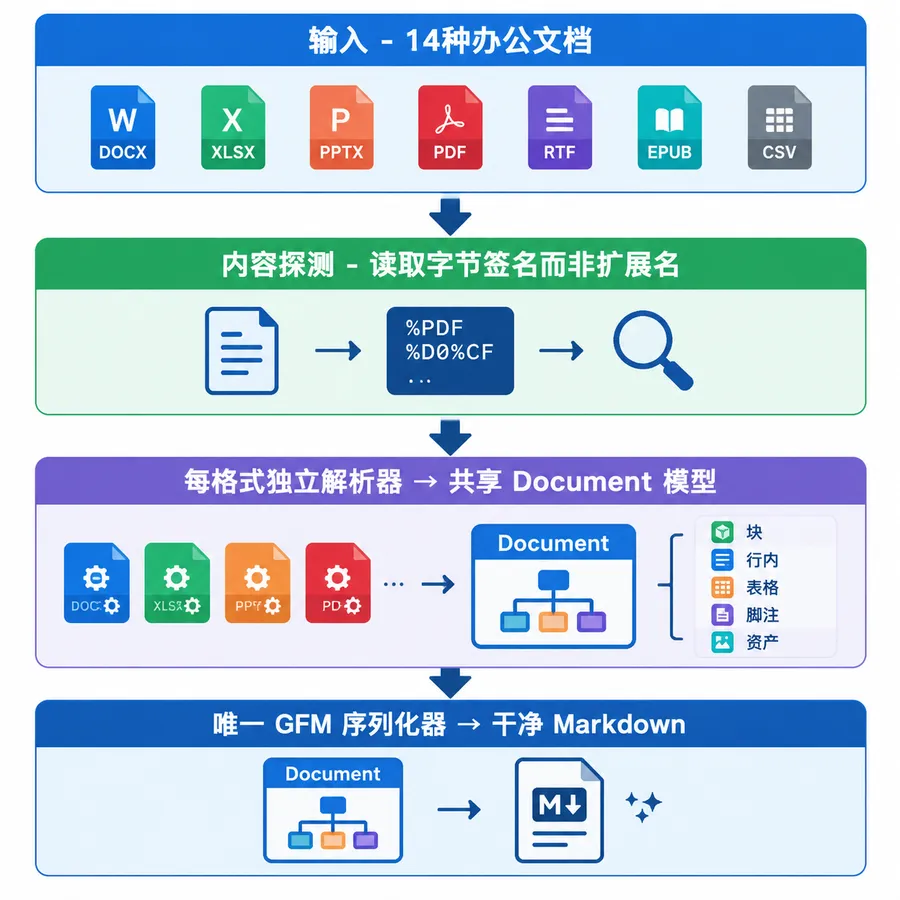
anydoc 的答案不是更聪明的算法,而是更干净的架构——四层收束。它的核心论点写在 README 里一句话:"对 docx 的表格转义修复,自动就是对 rtf、odt 和所有其它格式的修复。"
第一层,内容探测,只信字节不信扩展名。它读的是 PDF 的文件头、RTF 的开组标记、OLE 复合文档的流名、ZIP 包的 mimetype。你把 report.docx 改名成 mystery.bin,它照样认出这是 DOCX 并正确转换——因为格式是从原始字节本身读出来的,不是从文件名猜的。
第二层,每格式一个解析器。doc、docx、ppt、pptx、xls、xlsx、odt、ods、odp、rtf、epub、csv,各自有专门的解析器,处理本格式的结构。
第三层,共享 Document 模型。这是关键。所有解析器拆完格式后,都把结果映射进同一个内部表示——块、行内样式、表格、脚注、嵌入资产,全进同一个中间结构。这就是"收束"二字的由来。
第四层,唯一的 GFM 序列化器。标题锚点、脚注、列表编号、表格转义,所有这些行为对 14 种格式完全一致。维护成本被压到最小:逻辑只集中在"模型 + 序列化器"这一层,不用给每种格式各写一套输出。
PDF 是唯一的旁路:文本型 PDF 交给 Firecrawl 另一个开源库 pdf-inspector 直接本地直转。它的思路同样克制——读取 PDF 内部结构(字体编码、文本算子、图像覆盖率),毫秒级判断每一页到底是"文本型"还是"扫描型",只把扫描页交给 OCR/视觉管线。一个 200 页的报告里 150 页是纯文本,这 150 页就彻底跳过 GPU。
三、论证:4.4 毫秒能成立,是因为它放弃了"什么都要用模型"
anydoc 的速度数字在官方基准里是中位 4.4 毫秒/篇,500 个 docx 只要 1.7 秒,比 LibreOffice 快 256 倍。这个快,不是靠优化出来的,是靠"放弃"换来的。
它没有 ML 模型、没有 GPU、没有 API key、没有任何系统依赖。纯 Rust,CPU-only,二进制分发。Node 绑定跑在 libuv 线程池里不阻塞事件循环,Python 绑定释放 GIL。一句话:它把"任何办公文档 → LLM 可读的 Markdown"这条路径,做成了确定性的、亚毫秒级的本地计算。
而这背后有一个更本质的判断,值得单独拎出来讲:"把每个上传都丢给视觉模型"的时代,正在变贵。
过去一年,很多团队的处理习惯是——不管什么文档,先路由到多模态大模型,用 GPU 逐像素看一遍。对真正是扫描件、图片型 PDF 的文件,这条路是对的;但对绝大多数结构可读的 .docx、.xlsx,这条路是杀鸡用牛刀,最终都会在财务的账单上现形。anydoc 加 pdf-inspector,走的就是那条"确定性、CPU-only"的路径,专门承接那些根本不真正需要像素的文档。
它诚实的地方在于,边界也写得很清楚:扫描件、图片型 PDF 它不做 OCR,直接返回 Unsupported 并指向 Firecrawl 自家的托管 Parse API;加密文档 hard-fail;电子表格的数字格式当前会丢(issue #27 还开着)。这种"把不做的部分讲明白"的姿态,反而让"做的部分"更可信。
四、对比:覆盖率,是唯一没有争议的第一
官方基准拿 anydoc 和六个常见工具,在 100 份真实文档、14 种格式上对比,质量由 LLM 评委对参考图盲评。anydoc 总分 81 排第一,且在每个被评格式上单项第一。
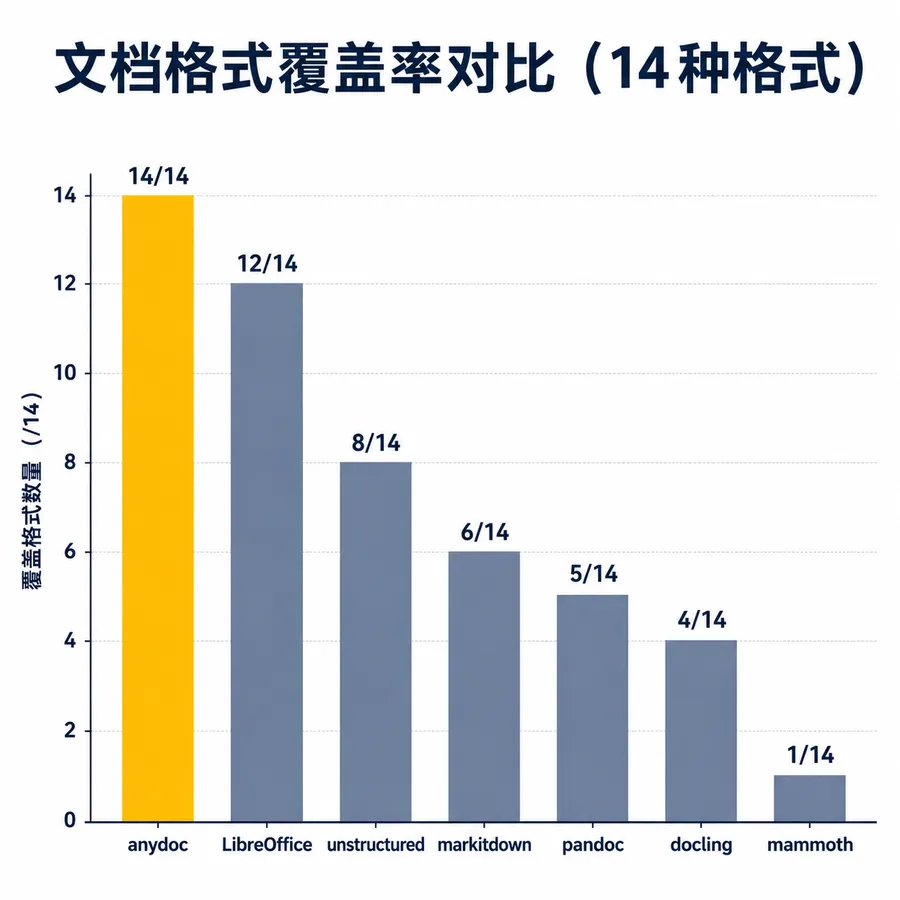
但这份基准要打三个折扣:厂商自测、语料不可再分发、LLM 当评委。真正能独立验证的,只有一列——格式覆盖率:
| 14/14 | ||
"一个入口吃掉全部办公格式"这件事,anydoc 目前没有同形态对手。和 markitdown 比,它赢在覆盖面、速度和 Rust 单二进制分发;和 pandoc 比,它输在长文档互转的成熟度,但赢在 Office 格式的保真和嵌入资产模型。
还有一步棋值得注意:anydoc 是以 Agent Skill 形态分发的。npx skills add firecrawl/anydoc,就能让 Claude Code、Codex、Cursor 这些编程 Agent,直接获得"读任何它撞见的办公文档"的能力。它在抢的不只是"文档转换库"这个位子,还有"Agent 的文档 Skill"这个入口。
五、启示:可靠性正在从模型层,一路下移到解析层和上下文层
把 anydoc 放进这一个月的时间轴里看,会发现一个清晰的主线:AI 工程的重心,正在从"让模型更强"转向"让模型所依赖的上下文更可靠"。
前有 archify 把架构图从"概率抽卡"做成"确定性编译",有 GitNexus 把代码库预编译成关系图谱,让 Agent 改代码不再靠猜;现在 anydoc 又补上了最前端的一环——把"真实世界最脏、最杂的办公文档",确定性、统一地转成 LLM 能可靠消费的结构。
这几件事指向同一个判断:当模型能力趋同,竞争的胜负手不再是谁的模型更聪明,而是谁喂给模型的东西更干净、更一致、更便宜。anydoc 的 4.4 毫秒不是炫技,是"解析层也要工程化"这个共识落地的一个信号。
对个人开发者,它是一行命令替换掉四个库;对做 Agent 或 RAG 产品的团队,它是一个提醒:你们的下一个性能瓶颈,大概率不在模型,而在那条被忽视的、从"用户上传"到"LLM 读进去"之间的缝隙里。
一句话:当所有人在卷模型更聪明的时候,Firecrawl 用 Rust 证明了一件事——RAG 的瓶颈在解析,不在模型。