ARTICLE · 998104
AI-reads-books:几百页 PDF 别硬塞给 AI,它真会读到后面开始编
AI-reads-books:几百页 PDF 别硬塞给 AI,它真会读到后面开始编把一本几百页的 PDF 技术书直接丢给 AI,让它总结。 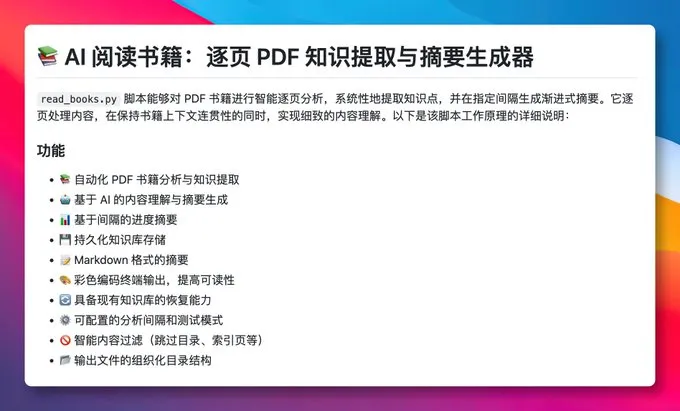
前面几十页一般挺像回事,术语、章节、重点都能接住。再往后就开始糊,到了结尾,好家伙,模型已经在靠“理解能力”补剧情了。
GitHub 上这个 AI-reads-books-page-by-page,办法反而特别笨:一页一页读。
每处理一页,就提取这一页的知识点,存进本地知识库。读到一定页数,再产出一份阶段小结;整本书处理完,最后拿这些积累下来的内容拼全书总结。
东哥看到这里反而觉得挺对路。长文档最怕一次塞太多,context 看着很大,不代表模型真的能把 300 页每个细节都惦记着。拆成逐页任务,慢是慢点,但至少哪一页读了、留下了什么,是能追的。
目录、索引、空白页这种没啥正文的页面,它会自动跳过。
还有个很实际的设计:支持断点续跑。 几百页 PDF 跑一半挂了,不用第二天重新从第一页开始。老开发看到这种功能会多瞅一眼——长任务最烦的不是慢,是跑到 87% 因为网络、额度、脚本异常全没了。
整个项目就一个 Python 脚本,改 PDF 文件名就能开跑。你还可以先限制只读前几页,看看提取效果、模型费用、输出格式顺不顺眼,再决定要不要整本放进去。
我一般也更喜欢这种试法,先拿 10 页折腾明白,别上来就让几百页一起烧 token。
啃大部头技术书、论文合集,或者手里几十份资料要做统一摘要,这种“逐页搬砖”的方案没那么炫,但确实更像工程。
项目地址:echohive42/AI-reads-books-page-by-page