ARTICLE · 998120
Cursor被断供给AI工具站上的一课:上游模型不能只有一家
Cursor被断供给AI工具站上的一课:上游模型不能只有一家8月28日,OpenAI公开表示,已通知SpaceX,计划逐步终止向Cursor提供OpenAI模型的合同,拟定停止日期是2026年11月12日。两周前,Cursor刚宣布已被SpaceX正式收购。 这件事最值得独立开发者关注的,不是谁对谁错,也不是下一款模型更强,而是一个很具体的经营风险:当产品的核心体验压在一家模型供应商上,商业关系的一次变化,就可能变成你的功能下线通知。需要强调的是,11月12日是OpenAI公告中的拟定停止日期,不是已经发生的停服结果。 OpenAI的公告是其单方公开立场。Cursor的公告则强调,加入SpaceX后将获得更多算力,并用更低成本提供更强模型。公开材料没有披露完整合同,也不足以判断双方尚未公开的动机。我们能确认的只有两点:Cursor的控制权发生了变化;OpenAI随后给出了拟停止供模的时间表,并表示不会向Cursor提供未来模型。 对AI工具站来说,这已经足够构成一次产品连续性演练。 
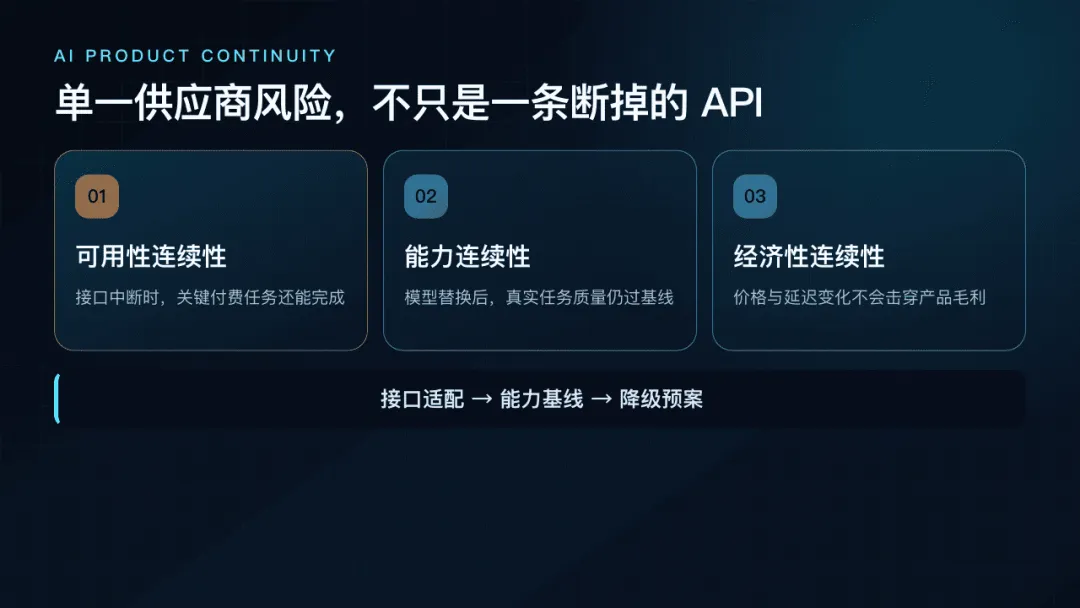
很多小团队把模型选择当作工程配置:今天GPT效果好就接GPT,明天另一个模型便宜就换一个。真正上线收费后,模型却会进入产品的每一层。 提示词依赖它的指令遵循方式,结构化输出依赖它的格式稳定性,工作流依赖它的工具调用习惯,客服话术依赖它的语气,风控规则依赖它的拒答边界。用户买到的不是一个API,而是这些行为叠在一起后的结果。 因此,换供应商从来不是把模型名改掉这么简单。一个备用模型即使能返回答案,也可能在长上下文、工具调用、中文表达或JSON稳定性上表现不同。只要关键任务通过率下降,产品就已经发生了变化。 我的判断是:单一供应商风险至少有三层。 第一层是可用性风险。合同、区域政策、账户风控、限流或产品下线,都可能让接口无法继续使用。 第二层是能力风险。原模型仍可用,但下一代能力不再向你的渠道提供,你的产品会逐渐落后,而不是在某一天突然宕机。 第三层是经济风险。供应商调整价格、缓存规则、推理档位或限额后,你的毛利和响应时间可能同时变化。 这三层都不是“买一份保险”就能解决。它们需要被写进产品架构和运营指标。 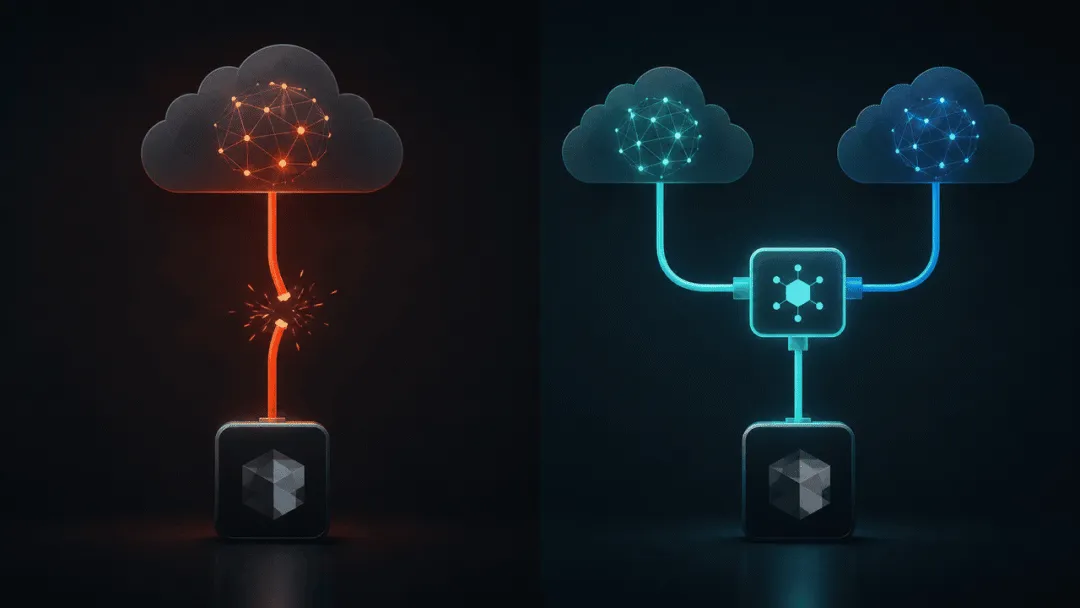
不是一上来接五家模型,也不是做一个宏大的通用路由平台。最小可行方案只有四步。 不要从全部调用开始。先选一条最接近付费价值的链路,例如“上传合同后生成风险清单”“把会议录音转成待办”或“根据仓库问题生成可合并补丁”。 写下这个任务的输入、允许等待多久、什么结果算成功、失败后能否人工兜底。没有成功标准,就无法判断备用模型到底能不能接班。 业务代码只调用统一的任务接口,不直接散落供应商特有参数。适配层负责模型名称、鉴权、工具格式、重试、超时和错误映射。 这并不要求构建复杂框架。对小产品,一个明确的接口、两份供应商实现和一组固定测试样本已经够用。关键不是代码多漂亮,而是切换时不必全仓库搜参数。 准备20个真实代表任务,至少覆盖正常输入、超长输入、含糊指令、工具失败和恶意内容。对主模型与备用模型同时记录:一次通过率、重试次数、端到端延迟、人工修正时间和每次成功任务成本。 这里最容易犯的错,是用单次演示判断备用方案。真正决定能否切换的,是稳定完成用户任务的比例,而不是某个漂亮答案。 为关键链路保留供应商开关,但不要允许静默切换。每次切换都应记录时间、原因、受影响任务、质量差异和回滚条件。涉及高风险输出时,还要明确哪些能力下降后必须暂停服务,而不是硬着头皮继续生成。 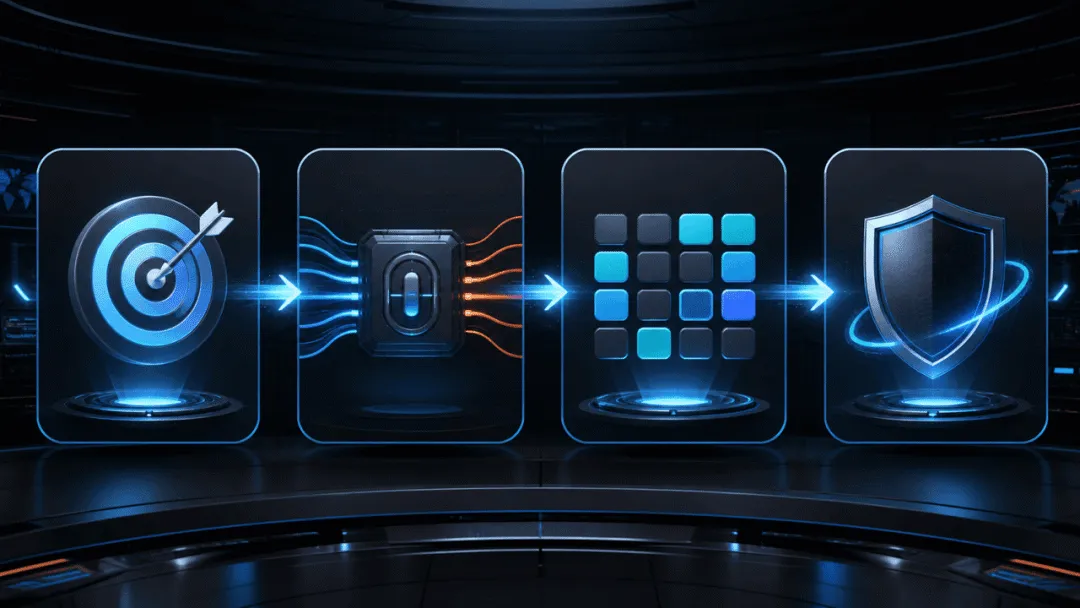
第一天,列出所有模型调用,并标出直接影响付费结果的那一条。 第二天,为这条链路整理20个脱敏真实样本,定义成功标准。 第三、四天,接入第二供应商,只覆盖必要的文本、结构化输出或工具调用能力。 第五天,同时跑两套结果,记录任务通过率、延迟、重试和单次成功成本。 第六天,补齐降级规则:哪些功能可以暂时简化,哪些必须停用,哪些交给人工。 第七天,做一次不影响真实用户的切换演练,并把恢复步骤写成一页操作清单。 这套方案的价值,不是让你永远不受上游影响,而是把“临时重写产品”变成“按预案降级”。 小团队最容易从一个极端走向另一个极端:昨天完全依赖一家,今天听到断供就要求所有请求同时跑两家。这样会直接增加模型费用、测试分支和排障难度。 更实际的分层是:关键付费链路必须有经过验证的备用方案;普通生成能力可以接受短时关闭;实验功能只需要保留数据导出和明确告知。对关键链路,也不必持续双跑,可以每天抽样或在版本升级前回归测试。 同时要保存供应商无关的业务状态。用户原始输入、任务进度、必要日志和结果版本应能被下一套执行器读取;不要只保存某家接口返回的内部ID。否则即使模型切换成功,正在进行的任务仍然无法恢复。 连续性设计的目标不是“永不失败”,而是在有限预算下,让最重要的用户结果先恢复,并且让用户知道哪些能力正在降级。 
Cursor有收购方的算力、自己的模型路线和庞大工程团队。普通工具站没有必要复制它的基础设施,也不可能用同样方式处理供应链变化。 但小团队有一个优势:链路短,能更快找出唯一关键任务,也能更早把供应商依赖显性化。 不要把多供应商理解为到处加API。真正要做的是三件事:业务与供应商解耦、用真实任务定义能力基线、提前决定降级边界。没有这三件事,接再多模型也只是更多不可控分支。 这次事件的核心判断很简单:模型适配层、备用供应商和能力基线,不是大公司的过度工程,而是AI产品最基本的连续性设计。 如果你的网站今天只能靠一个模型完成最重要的付费任务,那么现在最该问的不是“下一家便宜多少”,而是:明天它不能用时,你能在多长时间内恢复一个用户愿意继续付费的版本?
这不是采购问题,而是产品问题
普通独立开发者能抄什么
先找出唯一不能停的任务
把供应商差异关进适配层
建一套“能力基线”,而不是看跑分
让切换成为一个可执行动作
七天可以完成的连续性检查
不要把连续性做成昂贵的双活
我不会抄Cursor的规模,只会抄这次提醒