ARTICLE · 999019
PDF里的文字复制不了?这个离线OCR工具,截图就能直接提取
PDF里的文字复制不了?这个离线OCR工具,截图就能直接提取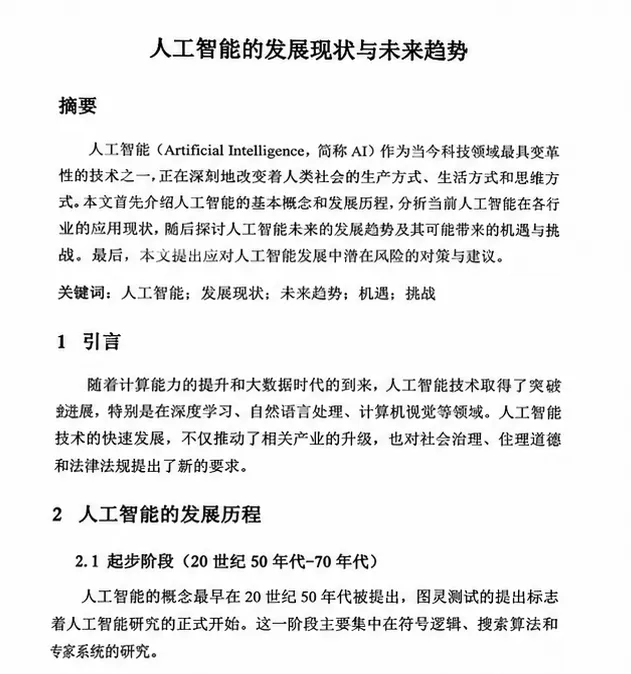
这两天整理资料的时候,我遇到一个挺常见的问题:PDF和图片里的文字明明看得见,却根本没办法复制。
如果内容只有几句话还好,遇到几百上千字的扫描件,一个字一个字重新敲,实在太浪费时间。
所以现在遇到这种情况,我基本都会用OCR文字识别工具来处理。
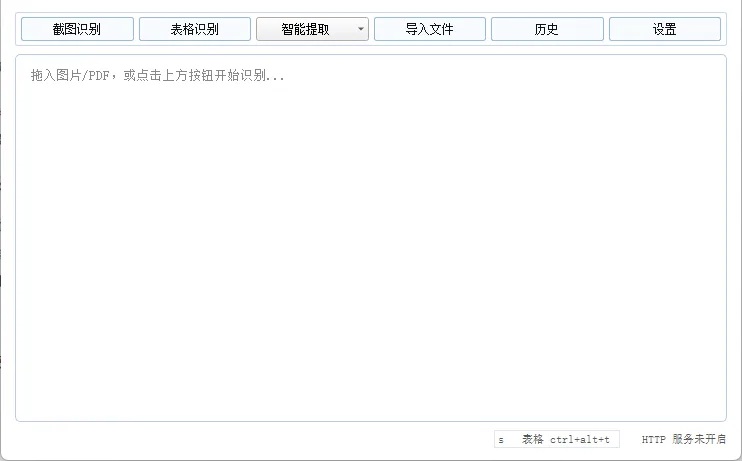
我最近用的这款工具操作很简单,需要提取屏幕上的文字时,直接点击「截图识别」,然后框选需要识别的区域。等待几秒钟,图片里的内容就会自动转换成可以复制、编辑的文字。
实际使用下来,普通中文资料的识别效果还是不错的,原来的标点符号和换行基本都能保留下来。
识别完成以后,如果发现排版比较乱,还可以直接清除多余空行、合并段落,不用再复制到其他软件里一点点整理。
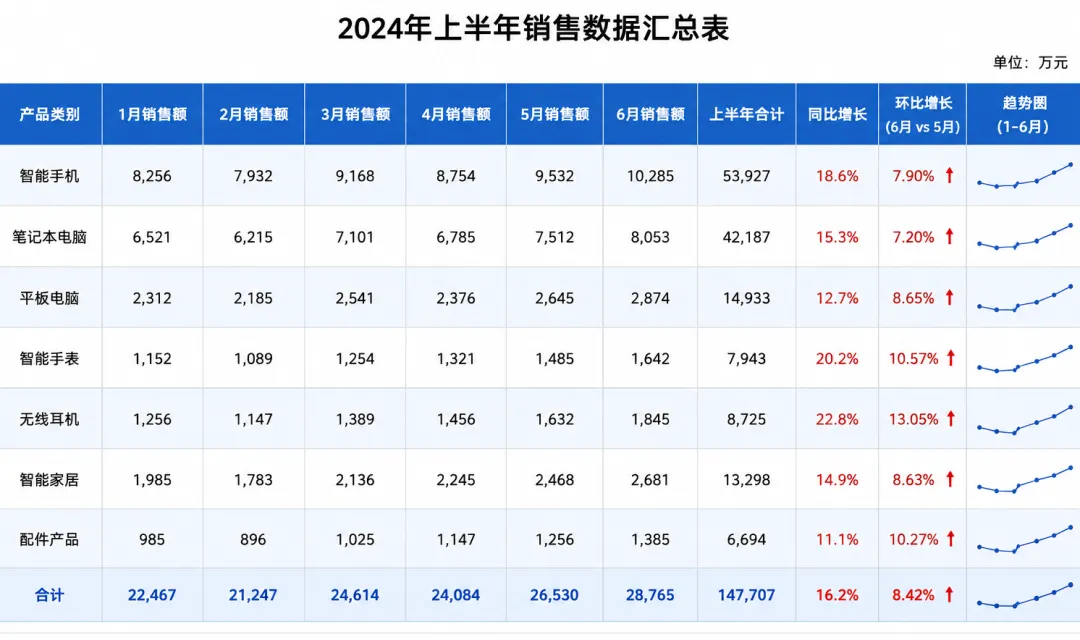
除了截图识别,它也适合处理平时收到的扫描版PDF、图片以及图片里的表格。遇到不能直接复制的资料,可以导入文件,也可以直接截图处理,整理资料的时候能省下不少时间。
我比较喜欢的一点是,它可以在本地离线完成OCR识别。即使电脑没有网络,也不影响正常使用;一些不方便上传到在线网站的资料,也可以直接留在本地处理。
如果你平时经常整理文档、PDF或者图片资料,这类离线OCR工具还是非常实用的。能复制的就别手敲,几分钟的工作,有时候几秒钟就能解决。