2017 年计算机学科专业基础综合试题参考答案
一、单项选择题
1.
B
2.
9.
B
10.
17.
C
18.
25.
B
26.
33.
A
34.
1. 解析:
sum +=++i; 相当千廿i; sum = sum + i; 。进行到第k 趟循环,
sum = (l+k)*k/2 。显然需要进
行O(n112)趟循环,因此这也是该函数的时间复杂度。
2. 解析:
I 的反例:计算斐波拉契数列迭代实现只需要一个循环即可实现。
III 的反例:入栈序列
为
1 、
2, 进行如下操作PUSH 、
PUSH 、
POP 、
POP,
出栈次序为2 、
1; 进行如下操作PUSH 、
POP 、PUSH 、
POP,
出栈次序为
1 、
2 。
IV, 栈是一种受限的线性表,只允许在一端进行操作。
因此II 正确。
3. 解析:
三元组表的结点存储了行row、列col、值value 三种信息,是主要用来存储稀疏矩阵的一种
数据结构。十字链表将行单链表和列单链表结合起来存储稀疏矩阵。邻接矩阵空间复杂度达O(n2),
不适千存储稀疏矩阵。二叉链表又名左孩子右兄弟表示法,可用千表示树或森林。因此A 正确。
4. 解析:
先序序列是先父结点,接着左子树,然后右子树。中序序列是先左子树,接着父结点,然
后右子树,递归进行。如果所有非叶结点只有右子树,先序序列和中序序列都是先父结点,然
后右子树,递归进行,因此B 正确。
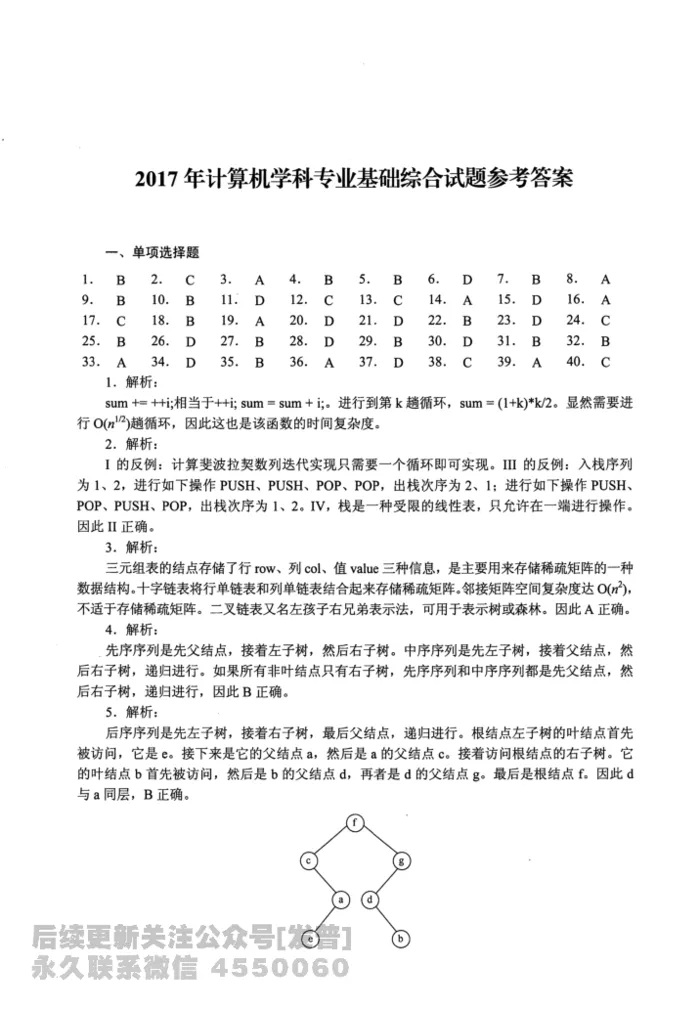
5. 解析:
后序序列是先左子树,接着右子树,最后父结点,递归进行。根结点左子树的叶结点首先
被访问,它是e 。接下来是它的父结点a,
然后是a 的父结点c 。接着访问根结点的右子树。它
的叶结点b 首先被访问,然后是b 的父结点d,
再者是d 的父结点g。最后是根结点f。因此d
与a 同层,
B 正确。
CBBDD
3.
11.
19.
27.
35.
4.
12.
20.
28.
36.
5.
13.
21.
29.
37.
6.
14.
22.
30.
38.
7.
15.
23.
31.
39.
AACBC
BDDBA
DABDC
BCDBD
BCDDA
ADABB
8.
16.
24.
32.
40.
6. 解析:
哈夫曼编码是前缀编码,各个编码的前缀各不相同,因此直接拿编码序列与哈夫曼编码一
一比对即可。序列可分割为0100
011 001 001 011 11 0101, 译码结果是a fee f g d,
选项D正确。
7. 解析:
无向图边数的两倍等于各顶点度数的总和。由于其他顶点的度均小于3, 可以设它们的度
都为2, 设它们的数量是X, 可列出方程4x3 + 3x4 + 2x = 16x2, 解得x = 3。4 + 3 + 3 = 11, B
正确。
8. 解析:
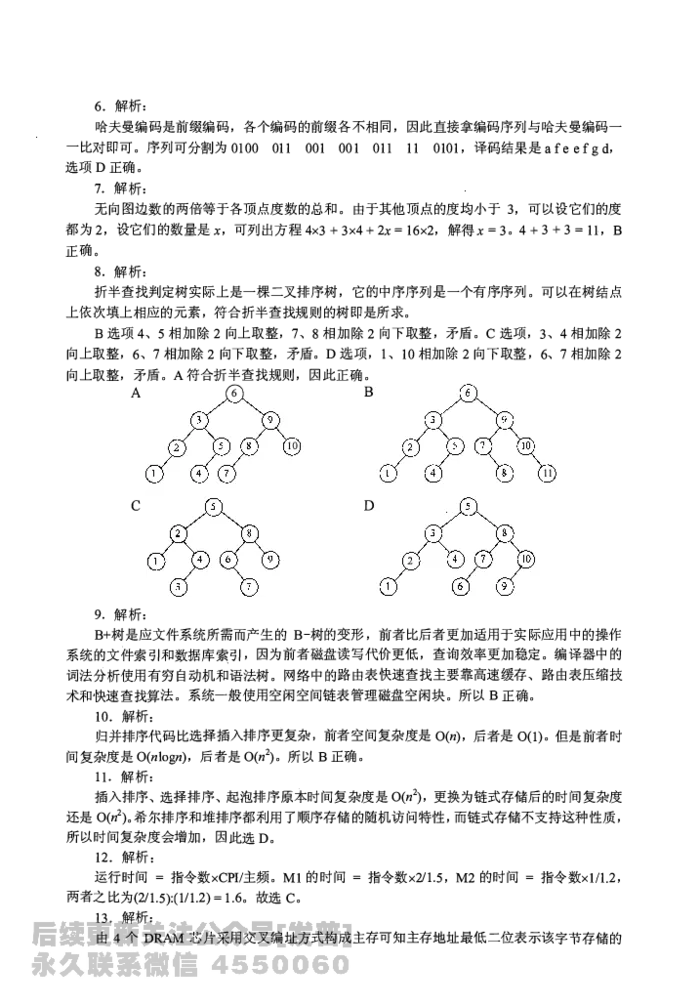
折半查找判定树实际上是一棵二叉排序树,它的中序序列是一个有序序列。可以在树结点
上依次填上相应的元素,符合折半查找规则的树即是所求。
B选项4、5相加除2向上取整,7、8相加除2向下取整,矛盾。C 选项,3、4相加除2
向上取整,6、7相加除2向下取整,矛盾。D选项,I、10相加除2向下取整,6、7相加除2
向上取整,矛盾。A符合折半查找规则,因此正确。
A
{6)
B
c

10
D
2
II
9. 解析:
B+树是应文件系统所需而产生的B-树的变形,前者比后者更加适用于实际应用中的操作
系统的文件索引和数据库索引,因为前者磁盘读写代价更低,查询效率更加稳定。编译器中的
词法分析使用有穷自动机和语法树。网络中的路由表快速查找主要靠高速缓存、路由表压缩技
术和快速查找算法。系统一般使用空闲空间链表管理磁盘空闲块。所以B正确。
10. 解析:
归并排序代码比选择插入排序更复杂,前者空间复杂度是O(n), 后者是0(1)。但是前者时
间复杂度是O(nlogn), 后者是O(n2)。所以B正确。
11. 解析:
插入排序、选择排序、起泡排序原本时间复杂度是O(n2), 更换为链式存储后的时间复杂度
还是O(n2)。希尔排序和堆排序都利用了顺序存储的随机访问特性,而链式存储不支持这种性质,
所以时间复杂度会增加,因此选D。
12. 解析:
运行时间=指令数xCPI/主频。Ml的时间=指令数x2/1.5, M2的时间=指令数xl/1.2,
两者之比为(2/1.5):(1/1.2) = 1.6。故选C。
13. 解析:
由4个DRAM芯片采用交叉编址方式构成主存可知主存地址最低二位表示该字节存储的
芯片编号。double型变量占64位, 8 个字节。 它的主存地址804 001 AH最低二位是 10, 说明
它从编号为 2 的芯片开始存储(编号从0 开始)。一个存储周期可以对所有芯片各读取一个字节,
因此需要3轮,故选C。
14. 解析:
时间局部性是一旦一条指令被执行,则在不久的将来它可能再次被执行。空间局部性是一
旦一个存储单元被访问,那么它附近的存储单元也很快被访问。显然,这里的循环指令本身具
有时间局部性,它对数组a的访问具有空间局部性,故选A。
15. 解析:
在变址操作时,将计算机指令中的地址与变址寄存器中的地址相加,得到有效地址,指令
提供数组首地址,由变址寄存器来定位数据中的各元素。所以它最适合按下标顺序访问一维数
组元素,故选D。
相对寻址以PC 为基地址,以指令中的地址为偏移量确定有效地址。寄存器寻址则是在指
令中指出需要使用的寄存器。直接寻址是在指令的地址字段直接指出操作数的有效地址。
16. 解析:
三地址指令有29条,所以它的操作码至少为5位。以5位进行计算,
它剩余32 - 29 = 3
种操作码给二地址。而二地址另外多了6位给操作码,因此它的数量最大达3x64 = 192。所以
指令字长最少为23位,因为计算机按字节编址,需要是8 的倍数,所以指令字长至少应该是
24位,故选A。
17. 解析:
超标量是指在CPU中有一条以上的流水线,并且每个时钟周期内可以完成一条以上的指
令,其实质是以空间换时间。I错误,它不影响流水线功能段的处理时间;II、III正确。故选C。
18. 解析:
主存储器就是我们通常说的主存,在CPU外,存储指令和数据,由RAM 和ROM 实现。
控制存储器用来存放实现指令系统的所有微指令,是一种只读型存储器,机器运行时只读不写,
在CPU的控制器内。cs 按照微指令的地址访问,所以B错误。
19. 解析:
五阶段流水线可分为取指(IF)、译码/取数(ID)、执行(EXC)、存储器读(MEM)、写回
(Write Back)。数字系统中,各个子系统通过数据总线连接形成的数据传送路径称为数据通路,
包括程序计数器、算术逻辑运算部件、通用寄存器组、取指部件等,不包括控制部件,故选A。
20. 解析:
多总线结构用速率高的总线连接高速设备用速率低的总线连接低速设备。一般来说,CPU
是计算机的核心,是计算机中速度最快的设备之一,所以A正确。突发传送方式把多个数据单
元作为一个独立传输处理,从而最大化设备的吞吐量。现实中一般用支待突发传送方式的总线
提高存储器的读写效率,B正确。各总线通过桥接器相连,后者起流量交换作用。PCI-Express
总线都采用串行数据包传输数据,所以选D。
21. 解析:
I/0端口又称I/0接口,是CPU与设备之间的交接面。由于主机和I/0设备的工作方式和
工作速度有很大差异,1/0端口就应运而生。在执行一条指令时,CPU 使用地址总线选择所请
求的I/0端口,使用数据总线在CPU寄存器和端口之间传输数据。所以选D。
22. 解析:
多重中断系统在保护被中断进程现场时关中断,执行中断处理程序时开中断,B错误。
CPU 一般在一条指令执行结束的阶段采样中断请求信号,查看是否存在中断请求,然后决定
是否响应中断,A、D正确。中断请求一般来自CPU以外的事件,异常一般发生在CPU内部,
C正确。
23. 解析:
先来先服务调度算法是作业来得越早,优先级越高,因此会选择JI。短作业优先调度算法
是作业运行时间越短,优先级越高,因此会选择J3。所以D正确。
24. 解析:
执行系统调用的过程是这样的:正在运行的进程先传递系统调用参数,然后由陷入(trap)
指令负责将用户态转化为内核态,并将返回地址压入堆栈以备后用,接下来CPU执行相应的内
核态服务程序,最后返回用户态。所以C正确。
25. 解析:
回收起始地址为60K、大小为140KB的分区时,它与表中第一个分区和第四个分区合并,
成为起始地址为20K、大小为380KB的分区,剩余3个空闲分区。在回收内存后,算法会对空
闲分区链按分区大小由小到大进行排序,表中的第二个分区排第一。所以选择B。
26. 解析:
绝大多数操作系统为改善磁盘访问时间,以簇为单位进行空间分配,因此选D。
27. 解析:
进程切换带来系统开销,切换次数越多,开销越大,A正确。当前进程的时间片用完后,
它的状态由执行态变为就绪态,B 错误。时钟中断是系统中特定的周期性时钟节拍。操作系统
通过它来确定时间间隔,实现时间的延时和任务的超时,C 正确。现代操作系统为了保证性能
最优,通常根据响应时间、系统开销、进程数量、进程运行时间、进程切换开销等因素确定时
间片大小,D正确。
28. 解析:
多道程序系统通过组织作业(编码或数据)使CPU总有一个作业可执行,从而提高了CPU
的利用率、系统吞吐量和1/0设备利用率,I、III、IV是优点。但系统要付出额外的开销来组织
作业和切换作业,II错误。所以选D。
29. 解析:
一个新的磁盘是一个空白版,必须分成扇区以便磁盘控制器能读和写,这个过程称为低级
格式化(或物理格式化)。低级格式化为磁盘的每个扇区采用特别的数据结构,包括校验码,III
错误。为了使用磁盘存储文件,操作系统还需要将其数据结构记录在磁盘上。这分为两步。第
一步是将磁盘分为由一个或多个柱面组成的分区,每个分区可以作为一个独立的磁盘,I错误。
在分区之后,第二步是逻辑格式化(创建文件系统)。在这一步,操作系统将初始的文件系统数
据结构存储到磁盘上。这些数据结构包括空闲和已分配的空间和一个初始为空的目录,II、IV
正确。所以选B。
30. 解析:
可以把用户访问权限抽象为一个矩阵,行代表用户,列代表访问权限。这个矩阵有4行5
列,1代表true, 0代表false, 所以需要20位,选D。
31. 解析:
硬链接指通过索引结点进行连接。一个文件在物理存储器上有一个索引节点号。存在多个
文件名指向同一个索引节点,II正确。两个进程各自维护自己的文件描述符,III正确,I错误。
所以选择B。
32. 解析:
在开始DMA 传输时,主机向内存写入DMA命令块,向DMA控制器写入该命令块的地
址,启动1/0设备。然后,CP U继续其他工作,DMA控制器则继续下去直接操作内存总线,
将地址放到总线上开始传输。当整个传输完成后,DMA控制器中断CPU。因此执行顺序是2, 3,
l, 4, 选B。
33. 解析:
OSI参考模型共7层,除去物理层和应用层,剩五层。它们会向PD U引入20Bx5 = lOOB
的额外开销。应用层是最顶层,所以它的数据传输效率为400B/500B= 80%, 选A。
34. 解析:
可用奈奎斯特采样定理计算无噪声情况下的极限数据传输速率,用香农第二定理计算有噪
信道极限数据传输速率。2叭og2Ny叭og2(1 + SIN), W是信道带宽,N是信号状态数,SIN是信
噪比,将数据代入计算可得Ny32, 选D。分贝数=IOlog心IN。
35. 解析:
IEEE 802.11 数据帧有四种子类型,分别是IBSS、From AP、ToAP、WDS。这里的数据帧F
是从笔记本电脑发送往访问接入点CAP),所以属于To AP子类型。这种帧地址l是RA (BSSI D),
地址2是SA, 地址3是DA。RA是Receiver Address的缩写,BSSI D是basic service set identifier
的缩写,SA是source address的缩写,DA是destination address的缩写。因此地址l是AP的MAC,
地址2是H的MAC, 地址3是R的MAC, 选B。
36. 解析:
根据RFC文档描述,0.0.0.0/32 可以作为本主机在本网络上的源地址。127.0.0.1是回送地
址,以它为目的IP地址的数据将被立即返回到本机。200.10.10.3是C类IP地址。255.255.255.255
是广播地址。
37. 解析:
RIP是一种分布式的基于距离向量的路由选择协议,通过广播U DP报文来交换路由信息。
OSPF是一个内部网关协议,不使用传输协议,如UDP或TCP, 而是直接用IP包封装它的数
据。BGP是一个外部网关协议,用TCP封装它的数据。
因此选D。
38. 解析:
这个网络有16位的主机号,平均分成128个规模相同的子网,每个子网有7位的子网号,9
位的主机号。除去一个网络地址和广播地址,可分配的最大1P地址个数是29-2=512-2=510,
故选C。
39. 解析:
按照慢开始算法,发送窗口= min{拥塞窗口,接收窗口},初始的拥塞窗口为最大报文段
长度1KB海经过一个RTT, 拥塞窗口翻倍,因此需至少经过5个RTT, 发送窗口才能达到32KB,
所以选A。这里假定乙能及时处理接收到的数据,空闲的接收缓存y32KB。
40. 解析:
FTP协议使用控制连接和数据连接,控制连接存在于整个FTP会话过程中,数据连接在每
次文件传输时才建立,传输结束就关闭,A 和B是正确的。默认情况下FTP协议使用TCP 20
端口进行数据连接,TCP 21端口进行控制连接。但是是否使用TCP 20端口建立数据连接与传
输模式有关,主动方式使用TCP20端口,被动方式由服务器和客户端自行协商决定,C错,D
对。所以选C。
二、综合应用题
41. 解答:
(I)算法的基本设计思想
表达式树的中序序列加上必要的括号即为等价的中缀表达式。可以基于二叉树的中序遍历
策略得到所需的表达式。(3分)
表达式树中分支结点所对应的子表达式的计算次序,由该分支结点所处的位置决定。为得
到正确的中缀表达式,需要在生成遍历序列的同时,在适当位置增加必要的括号。显然,表达
式的最外层(对应根结点)及操作数(对应叶结点)不需要添加括号。(2分)
(2)算法实现(IQ分)
将二叉树的中序遍历递归算法稍加改造即可得本题答案。除根结点和叶结点外,遍历到其
他结点时在遍历其左子树之前加上左括号,在遍历完右子树后加上右括号。
void B七reeToE(BTree *root
BtreeToExp(root, 1);
//根的高度为1
void. 13七reeToE:xp(BTree *roqt, int deep)
{
//空结点返回
if(root == NULL) return;
else if(root->left==NULL&&rɝot今right==NULL)
!/若为叶结点
printf ("%s", root->data);
//输出操作数,不加括号
else{
if (deep>l) printf (" (");
//若有子表达式则加1层括号
BtreeToExp(root->left, deep+l);
printf("%s", root->da七a);
/ /输出操作符
Btree'1'6Exp (roo七一>right, .'\ieep+l l;
if (deep>l) printf (") ");
/ /若有子表达式则加1层括号
【评分说明】CD若考生设计的算法满足题目的功能要求,则(1)、(2)根据所实现算法的
策略及输出结果给分,评分标准见下表。
分数
15
14
II
9
:,;;7
备注
采用中序遍历算法且正确,括号嵌套正确,层数适当
采用中序遍历算法且正确,括号嵌套正确,但括号嵌套层数过多。例如,表达式最外层加
上括号,或操作数加括号,如(a)
采用中序遍历算法,但括号嵌套层数不完全正确。例如,左右括号数量不匹配
采用中序遍历算法,但没有考虑括号
其他
@若考生采用其他方法得到正确结果,可参照@的评分标准给分。
@如果程序中使用了求结点深度等辅助函数,但没有给出相应的实现过程,只要考生进
行了必要的说明,可不扣分。
@若在算法的基本设计思想描述中因文字表达没有清晰反映出算法思路,但在算法实现
中能够表达出算法思想且正确的,则可参照心的标准给分。
@若算法的基本设计思想描述或算法实现中部分正确,可参照@中各种情况的相应给分
标准酌情给分。
@参考答案中只给出了使用C 语言的版本,使用C++语言的答案参照以上评分标准。
42. 解答:
(1) Prim算法属于贪心策略。算法从一个任意的顶点开始,一直长大到覆盖图中所有顶点
为止。算法每一步在连接树集合S 中顶点和其他顶点的边中,选择一条使得树的总权重增加最
小的边加入集合S。当算法终止时,S 就是最小生成树。
CD s 中顶点为A, 候选边为(A,D), (A, B), (A, E), 选择(A,D)加入S。
@s中顶点为A,D, 候选边为(A, B), (A, E), (D, E), (C, D), 选择(D,E), 加入S。
@s中顶点为A,D,E, 候选边为(A,B), (C, D), (C, E), 选择(C,E)加入S。
@s中顶点为A,D,E,C, 候选边为(A,B), (B, C), 选择(B,C)加入S。
@s就是最小生成树。
依次选出的边为
(A, D), (D, E), (C, E), (B, C) (4分)
【评分说明】每正确选对一条边且次序正确,给1 分。若考生选择的边正确,但次序不完
全正确,酌情给分。
(2)图G的MST是唯一的。(2分)第一小题的最小生成树包括了图中权值最小的四条边,
其他边都比这四条边大,所以此图的MST唯一。
(3)当带权连通图的任意一个环中所包含的边的权值均不相同时,其MST 是唯一的。(2
分)此题不要求回答充分必要条件,所以回答一个限制边权值的充分条件即可。
【评分说明】@若考生答案中给出的是其他充分条件,例如
“ 带权连通图的所有边的权值
均不相同
”,同样给分。
@若考生给出的充分条件对图的顶点数和边数做了某些限制,例如,限制了图中顶点的
个数(顶点个数少于3个)、限制了图的形状(图中没有环)等,则最高给l分。
@答案部分正确,酌情给分。
43. 解答:
(1)由于i和n是unsigned型,故"i <= n-1"是无符号数比较,n= O时,n - 1 的机器数
为全1, 值是232_ 1, 为unsigned型可表示的最大数,条件"i <= n-1"永真,因此出现死循环。
(2分)
若i 和n改为int类型,则不会出现死循环。(1分)
因为"i <= n-1"是带符号整数比较,n= O时,n-1 的值是-1, 当i = 0 时条件"i <= n-1"
不成立,此时退出for循环。(1分)
(2) fl(23)与双23) 的返回值相等。(1分)f(23) = 223+!_ 1 = 224 -1, 它的二进制形式是24个1。
int占32位,没有溢出。float有1个符号位,8个指数位,23个底数位,23个底数位可以表示
24位的底数。所以两者返回值相等。
fl(23)的机器数是OOFF FFFFH。(1分)
位(23)的机器数是4B7F FFFFH。(1分)
显而易见前者是24个1,
即0000 0000 1111 1111 1111 1111 llll llllc2)'后者符号位是o,
指数位为23 + 127c10) =1001 OllOc2)'底数位是111 1111 1111 llll llll llllc2J•
(3)当n= 24时,f(24) = 1 1111 1111 1111 1111 1111 1111 B, 而float型数只有24位有效位,
舍入后数值增大,所以讫(24)比fl(24) 大1。(1分)
【评分说明】只要说明双24)需舍入处理即可给分。
(4)显然f(31)已超出了int型数据的表示范围,用fl(31)实现时得到的机器数为32个1,
作为int 型数解释时其值为-1, 即fl(31)的返回值为-1。(I分)
因为int 型最大可表示数是0 后面加31 个I, 故使fl(n)的返回值与f(n)相等的最大n 值是
30。(1分)
【评分说明】对千第二问,只要给出n = 30 即可给分。
(5) IEEE 754 标准用
“阶码全L 尾数全O" 表示无穷大。位返回值为float 型,机器数7F80
OOOOH 对应的值是+=。(1分)
当n = 126 时,f(126) = 2'27 - 1 = 1.1…1 x2126' 对应阶码为127 + 126 = 253, 尾数部分舍入
后阶码加1, 最终阶码为254, 是IEEE 754 单精度格式表示的最大阶码。故使位结果不溢出的
最大n 值为126。(1分)
当n = 23 时,f(23)为24 位1, float 型数有24 位有效位,所以不需舍入,结果精确。故使
仅获得精确结果的最大n值为23。(1分)
【评分说明】对于第二问,只要给出n = 23, 即可给分。对于第三问,只要给出n = 126,
即可给分。
44. 解答:
(1) M 为CISC。(1分)
M的指令长短不一,不符合RISC 指令系统特点。(1分)
(2) fl 的机器代码占96B。(1 分)
因为fl 的第一条指令"push ebp" 所在的虚拟地址为0040 1020H, 最后一条指令"ret'' 所
在的虚拟地址为0040 107FH, 所以,fl 的机器指令代码长度为0040 107FH-0040 1020H + 1 = 60H =
96 个字节。(I分)
(3) CF = 1。(1分)
cmp 指令实现i与n - 1 的比较功能,进行的是减法运算。在执行fl(O)过程中,n = O, 当i=
0 时,i= 0000 OOOOH, 并且n-1 = FFFF FFFFH。因此,当执行第20 条指令时,在补码加I减运
算器中执行"0 减FFFF FFFFH" 的操作,即0000 OOOOH + 0000 OOOOH + 1=0000 0001H, 此时,
进位输出C = O, 减法运算时的借位标志CF = C EB I= 1。(2 分)
(4) 仅中不能用shl 指令实现power*2。Cl分)
因为shl 指令用来将一个整数的所有有效数位作为一个整体左移;而位中的变量power 是
float 型,其机器数中不包含最高有效数位,但包含了阶码部分,将其作为一个整体左移时并不
能实现
“ 乘2" 的功能,因而位中不能用shl 指令实现power*2。(2 分)浮点数运算比整型运
算要复杂,耗时也较长。
45. 解答:
(1)函数fl 的代码段中所有指令的虚拟地址的高20 位相同,因此fl 的机器指令代码在同
一页中,仅占用1页。(I分)页目录号用于寻找页目录的表项,该表项包含页表的位置。页表
索引用于寻找页表的表项,该表项包含页的位置。
(2) push ebp 指令的虚拟地址的最高10 位(页目录号)为00 0000 0001 , 中间10 位(页
表索引)为00 0000 0001, 所以,取该指令时访问了页目录的第1 个表项,(1分)在对应的页
表中访问了第1个表项。(1分)
(3)在执行scanf()的过程中,进程P 因等待输入而从执行态变为阻塞态。(1分)输入结束
时,P 被中断处理程序唤醒,变为就绪态。(I分)P 被调度程序调度,变为运行态。(1 分)CPU
状态会从用户态变为内核态。(I分)
46. 解答:
先找出线程对在各个变量上的互斥、并发关系。如果是一读一写或两个都是写,那么这就
是互斥关系。每一个互斥关系都需要一个信号量进行调节。
semaphore mutex_yl=l; //mutex_yl用千threadl与thread3对变量y的互斥访问。
semaphore mu七ex.,._y2=1; //mutex_y2用于thread2与thread3对变量y的互斥访问。
semaphore mu七ex_z=l;
//mutex_z用千变量z的互斥访问。
互斥代码如下:
(5分)
【评分说明】
thread!
!
:
(num w;
wait (mutex_y I) ;
W = aiJd (X, y) ;
signal(nmtex_yl);
...
lhn•ad2
I
}
cnum w;
wail (mutex_y2) ;
wail(mulex_1.) ;
w = add (y , z) ;
呴ignal(mut忙x_z);
signal (mutex_y2) ;
...
thread3
I
:
cnum w;
w .a= 1 ;
w.h= I;
wuit(mutcx_z);
z = add (z , w) ;
叫,nal(mutc,_z);
虹1l(mu廿x_yI);
阳iii(mulrx_y2) ;
y = add (y , w) ;
signal (mutcx_y I) ;
ʆignal (mult•x_y2) ;
...
@各线程与变量之间的互斥、并发情况及相应评分见下表。
三
变益
thread! 和thread2
thread2和thread3
thread! 和thread3
X
不共享
不共享
不共享
y
同时读
读写互斥
读写互斥
z
不共享
读写互斥
不共享
@若考生仅使用一个互斥信号量,互斥代码部分的得分最多给2分。
@答案部分正确,酌情给分。
47. 解答:
给分
1分
3分
1分
(1压时刻到ti时刻期间,甲方可以断定乙方已正确接收了3个数据帧,(1分)分别是So,o,
S 1 ,0, S2 ,0 C 1分)。R3,3说明乙发送的数据帧确认号是3, 即希望甲发送序号3 的数据帧,说明乙
已经接收了序号为0ʇ2的数据帧。
(2)从/1 时刻起,甲方最多还可以发送5个数据帧Cl分),其中第一个帧是Ss,2C 1分),
最后一个数据帧是S 1 ,2C 1分)。发送序号3位,有8个序号。在GBN协议中,序号个数>发送
窗口+1, 所以这里发送窗口最大为7。此时已发送了s3,o和s4,1, 所以最多还可以发送5个帧。
(3)甲方需要重发3个数据帧(1分),重发的第一个帧是S2 ,3C 1分)。在GBN协议中,
接收方发送了N帧后,检测出错,则需要发送出错帧及其之后的帧。S2 ,0超时,所以重发的第
一帧是S2。已收到乙的R2 $.贞,所以确认号应为3。
(4)甲方可以达到的最大信道利用率是
8x1000
7x
100x106
8xl000
0.96x10⁻³ +2x
100x106
X 100% = 50% (2分)
U= 发送数据的时间/从开始发送第一帧到收到第一个确认帧的时间=Nfd/(Td+ RTT+Ta)
U 是信道利用率,N 是发送窗口的最大值,Td是发送一数据帧的时间,RTT 是往返时间,
Ta 是发送一确认帧的时间。这里采用捎带确认,Td=Ta。
【评分说明】答案部分正确,酌情给分。