ARTICLE · 1001127
读数据可视化21文本和文档(上)
读数据可视化21文本和文档(上)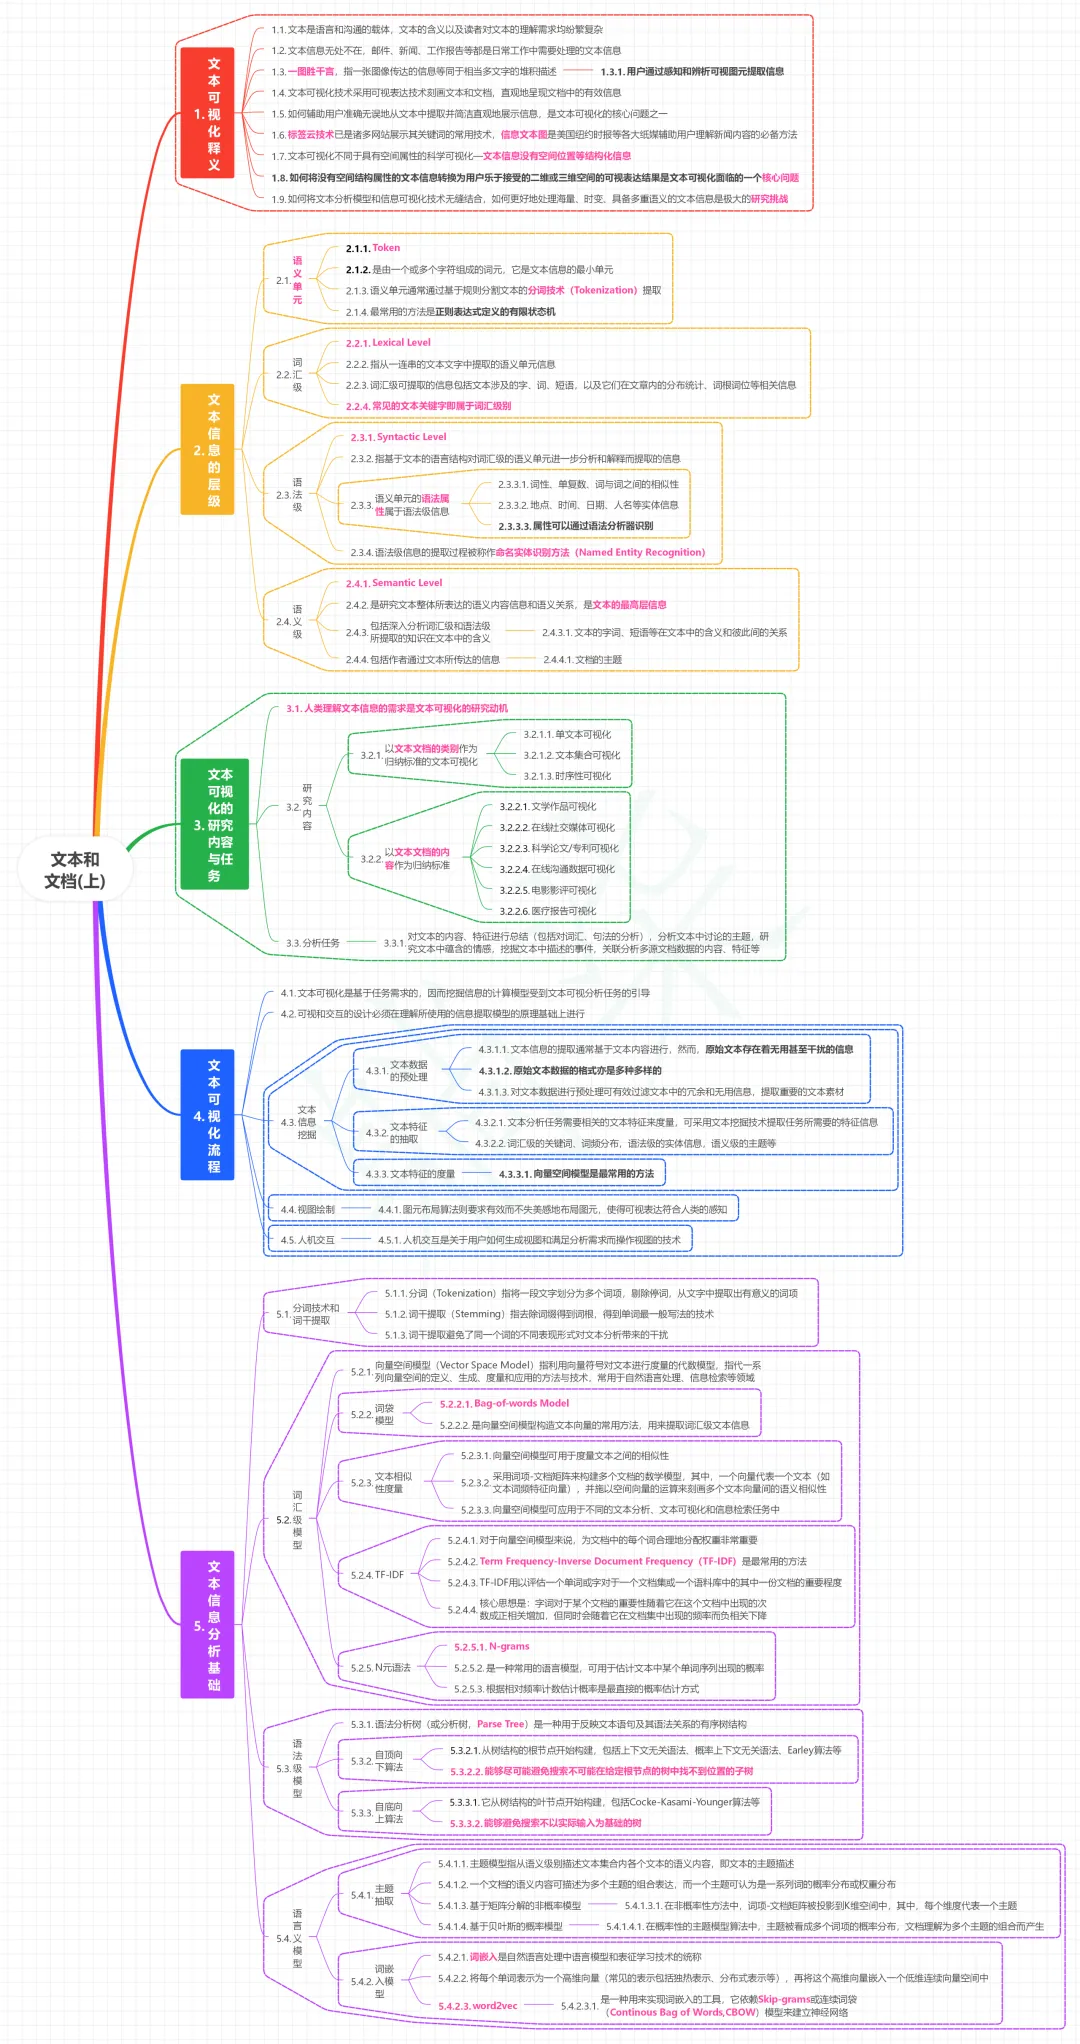
1.1. 文本是语言和沟通的载体,文本的含义以及读者对文本的理解需求均纷繁复杂 1.2. 文本信息无处不在,邮件、新闻、工作报告等都是日常工作中需要处理的文本信息 1.3. 一图胜千言,指一张图像传达的信息等同于相当多文字的堆积描述 1.3.1. 用户通过感知和辨析可视图元提取信息 1.4. 文本可视化技术采用可视表达技术刻画文本和文档,直观地呈现文档中的有效信息 1.5. 如何辅助用户准确无误地从文本中提取并简洁直观地展示信息,是文本可视化的核心问题之一 1.6. 标签云技术已是诸多网站展示其关键词的常用技术,信息文本图是美国纽约时报等各大纸媒辅助用户理解新闻内容的必备方法 1.7. 文本可视化不同于具有空间属性的科学可视化—文本信息没有空间位置等结构化信息 1.8. 如何将没有空间结构属性的文本信息转换为用户乐于接受的二维或三维空间的可视表达结果是文本可视化面临的一个核心问题 1.9. 如何将文本分析模型和信息可视化技术无缝结合,如何更好地处理海量、时变、具备多重语义的文本信息是极大的研究挑战 2.1.1. Token 2.1.2. 是由一个或多个字符组成的词元,它是文本信息的最小单元 2.1.3. 语义单元通常通过基于规则分割文本的*分词技术(Tokenization)*提取 2.1.4. 最常用的方法是*正则表达式定义的有限状态机 2.2.2. 指从一连串的文本文字中提取的语义单元信息 2.2.3. 词汇级可提取的信息包括文本涉及的字、词、短语,以及它们在文章内的分布统计、词根词位等相关信息 2.2.4. 常见的文本关键字即属于词汇级别 2.3.2. 指基于文本的语言结构对词汇级的语义单元进一步分析和解释而提取的信息 2.3.3. 语义单元的语法属性属于语法级信息 2.3.4. 语法级信息的提取过程被称作*命名实体识别方法(Named Entity Recognition) 2.4.2. 是研究文本整体所表达的语义内容信息和语义关系,是*文本的最高层信息 2.4.3. 包括深入分析词汇级和语法级所提取的知识在文本中的含义 2.4.4. 包括作者通过文本所传达的信息 3.1. 人类理解文本信息的需求是文本可视化的研究动机 3.2.1. 以文本文档的类别作为归纳标准的文本可视化 3.2.2. 以文本文档的内容作为归纳标准 3.3.1. 对文本的内容、特征进行总结(包括对词汇、句法的分析),分析文本中讨论的主题,研究文本中蕴含的情感,挖掘文本中描述的事件,关联分析多源文档数据的内容、特征等 4.1. 文本可视化是基于任务需求的,因而挖掘信息的计算模型受到文本可视分析任务的引导 4.2. 可视和交互的设计必须在理解所使用的信息提取模型的原理基础上进行 5.1.1. 分词(Tokenization)指将一段文字划分为多个词项,剔除停词,从文字中提取出有意义的词项 5.1.2. 词干提取(Stemming)指去除词缀得到词根,得到单词最一般写法的技术 5.1.3. 词干提取避免了同一个词的不同表现形式对文本分析带来的干扰 5.2.1. 向量空间模型(Vector Space Model)指利用向量符号对文本进行度量的代数模型,指代一系列向量空间的定义、生成、度量和应用的方法与技术,常用于自然语言处理、信息检索等领域 5.2.2. 词袋模型 5.2.3. 文本相似性度量 5.2.4. TF-IDF 5.2.5. N元语法 5.3.1. 语法分析树(或分析树,Parse Tree)是一种用于反映文本语句及其语法关系的有序树结构 5.3.2. 自顶向下算法 5.3.3. 自底向上算法
1. 文本可视化释义
2. 文本信息的层级
2.1. 语义单元
2.2. 词汇级
2.2.1. Lexical Level
2.3. 语法级
2.3.1. Syntactic Level
2.4. 语义级
2.4.1. Semantic Level
3. 文本可视化的研究内容与任务
3.2. 研究内容
3.3. 分析任务
4. 文本可视化流程
4.3. 文本信息挖掘
4.3.1. 文本数据的预处理
4.3.2. 文本特征的抽取
4.3.3. 文本特征的度量
4.4. 视图绘制
4.4.1. 图元布局算法则要求有效而不失美感地布局图元,使得可视表达符合人类的感知
4.5. 人机交互
4.5.1. 人机交互是关于用户如何生成视图和满足分析需求而操作视图的技术
5. 文本信息分析基础
5.1. 分词技术和词干提取
5.2. 词汇级模型
5.3. 语法级模型
5.4. 语言义模型
5.4.1. 主题抽取
5.4.1.3.1. 在非概率性方法中,词项-文档矩阵被投影到K维空间中,其中,每个维度代表一个主题
5.4.1.4.1. 在概率性的主题模型算法中,主题被看成多个词项的概率分布,文档理解为多个主题的组合而产生
5.4.2. 词嵌入模型
5.4.2.3.1. 是一种用来实现词嵌入的工具,它依赖Skip-grams或连续词袋(Continous Bag of Words,CBOW)模型来建立神经网络
请在微信客户端打开