ARTICLE · 1002184
AI 测试,始于十年前
本文自动整理自 Test Tribe 多伦多线下 Meetup 主题分享。
01 · 开场
晚上好,各位。感谢 Test Tribe 主办这次线下活动,让我们有机会坐在一起,聊聊 AI 与测试这两个我们都绕不开的话题。
02 · 关于我
03 · 现在与过去
04 · 2026 年,AI 测试的三大焦虑
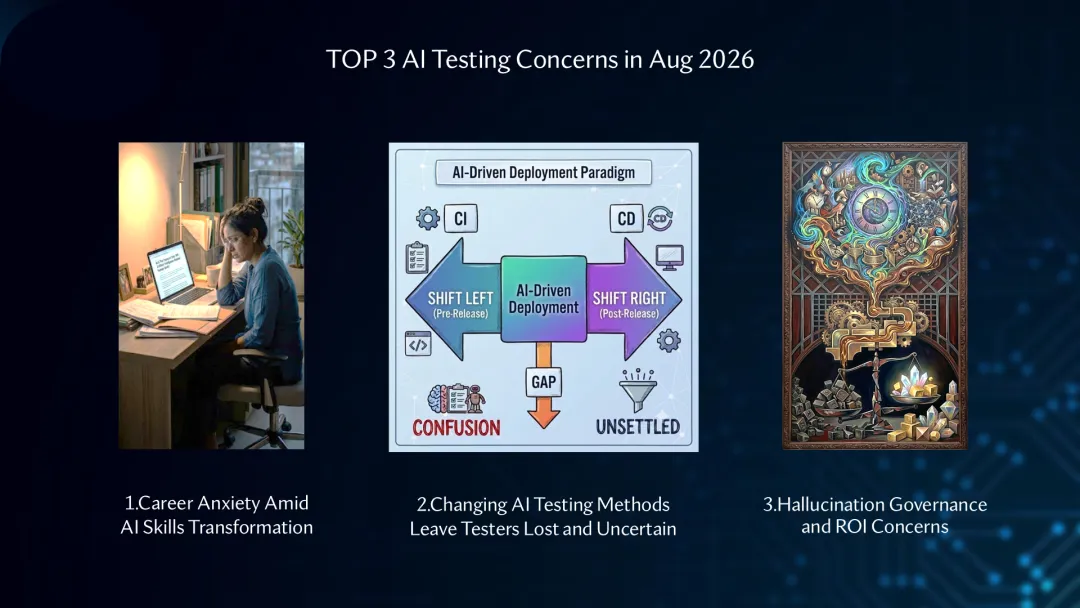
先来看看当下人们对 AI 测试的普遍担忧:
- 职业焦虑——AI 会不会取代测试工程师?这种不安逼迫我们不断努力,才能让自己安心;
- 方法论之变——AI 测试的方法一直在变,面对基于 AI 的系统、面对 Agent 的测试工作,很多人感到迷茫和无所适从;
- 幻觉与 ROI——AI 会产生幻觉(Hallucination),我们必须思考如何控制 AI 生成正确的输出;同时,引入 AI 的成本收益(ROI)也是绕不开的顾虑。
在给出「解决方案」之前,我想先带大家回到十年前。
05 · 2016 年,AI 测试长什么样
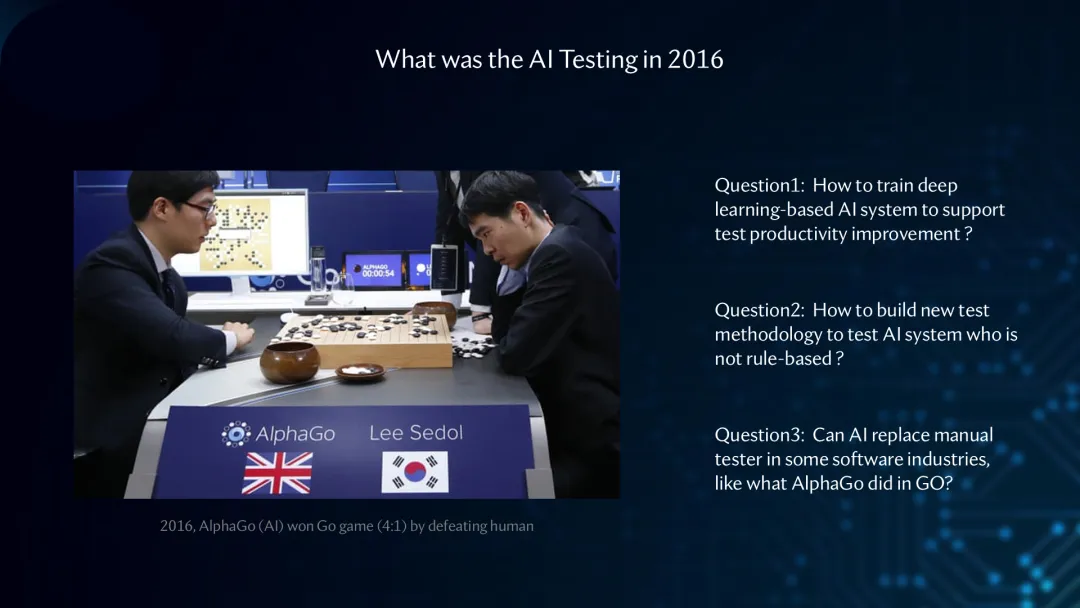
还记得 2016 年 IT 圈最重要的一条新闻吗?——AlphaGo。它凭借 DeepMind 带来的深度学习技术,在围棋上以 4:1 击败人类,成为当时全世界最强大的 AI。
为什么我们要提 AlphaGo?因为在 AI 爆发之后的那一年、乃至之后好几年,我们面对的问题和今天一模一样:
怎么训练模型来提升测试自动化的效率? 怎么测试「不是基于规则」的 AI 系统? AI 会不会像 AlphaGo 在围棋上打败人类那样,取代测试工程师?
十年过去了,大家有没有发现——我们在 AI 驱动测试上焦虑的事情,其实和十年前并无二致。
06 · 四个故事与启示
接下来,我想分享我的团队过去 12 年在 AI 驱动测试上的实践,以及我从这些成功与失败的故事中的所学。
07 · 故事一 · 2014 年:第一代「AI 测试机器人」
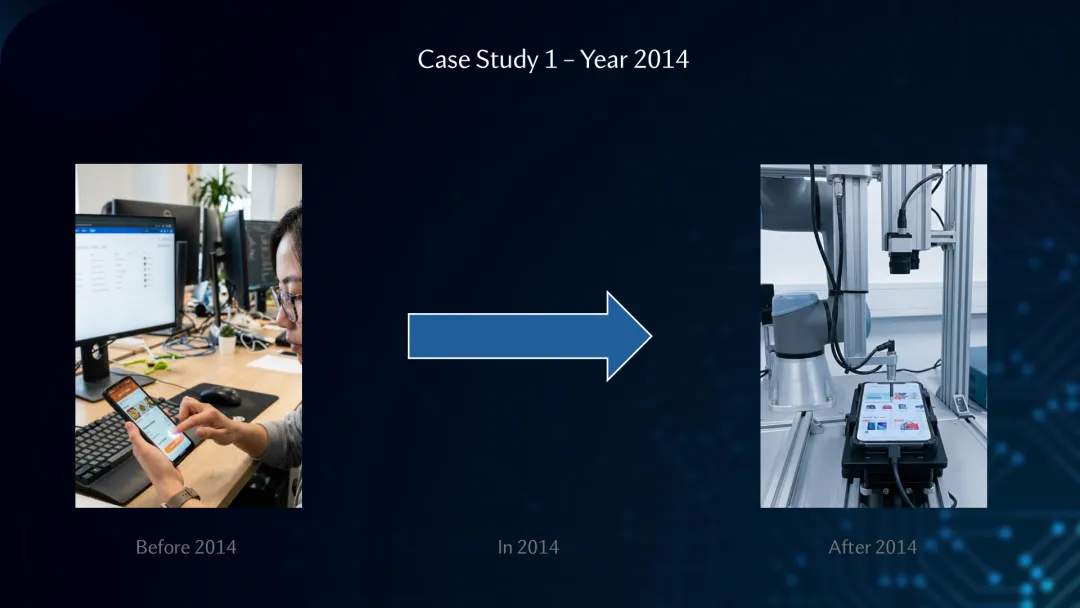
那些年我在做移动系统与应用测试。2014 年之前,团队主要靠人工执行测试,工作量巨大,而且测试不可复现——很多随机问题出现又消失,工程效率非常低。
2014 年,我们开始评估自动化方案。一个是 Android 的 UIAutomator,纯 UI 控件驱动,但它只能覆盖约 70% 的应用和界面;另一个是 Sikuli——有人听说过吗?纯图像识别方案,但我们发现它只能跑在 PC 桌面端,不支持 Android。
看来,我们需要找到第三条路。于是 2014 年之后,我们开始设计自己的「机械臂 + 图像识别」方案。经过一年多的开发,我们成功设计并部署了 20 多台设备——这在当时算是小小的里程碑,也可以说是第一代「基于 AI 的测试自动化系统」。
但新挑战接踵而至:UI 只要稍有变化,大部分脚本就要重写;光线等环境因素也会让测试变得不稳定。最终,两年之后我们不得不停掉了这个创新项目。
08 · 故事一 · 对今天的启示
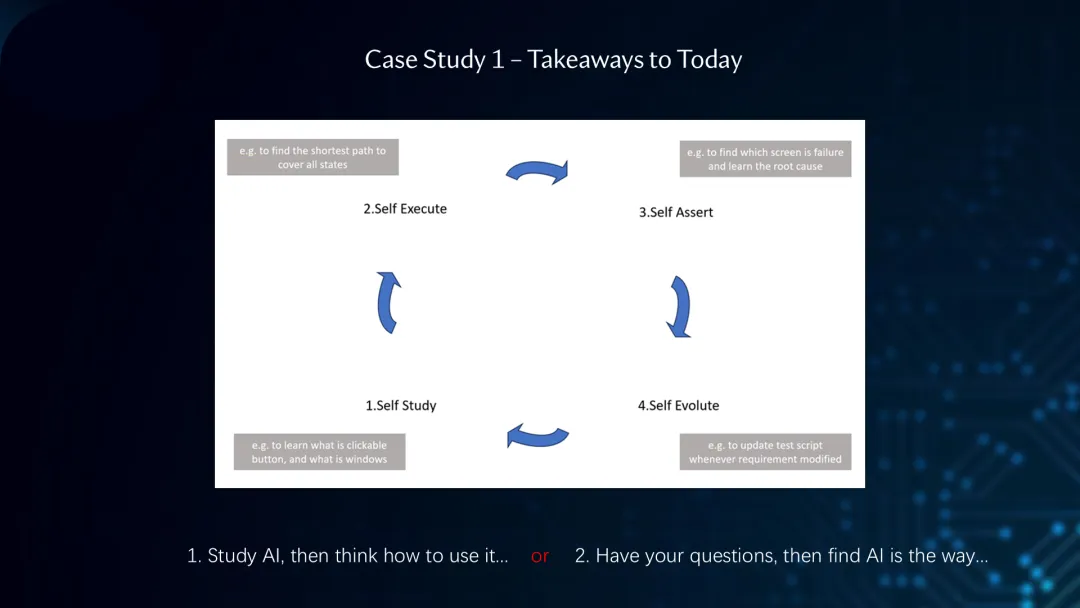
但即便是一个失败的故事,我仍然得到了新的启发。这张图是我十年前画的,也是那年我做的梦:
我希望测试框架能自己研读需求、自动编写测试脚本;运行时根据 UI 智能执行;通过学习失败模式来判定 PASS/FAIL;并根据新的变化自动升级测试。
今天再回头看这张图,我发现它其实就是今天所说的「AI 驱动测试」。
所以,学习 AI 通常有两条路径:一条是「先学 AI,再想怎么用」;另一条是「先有真实问题,再发现 AI 只是实现想法的工具」——后者,正是我十年前走的路。
09 · 故事二 · 2018 年:让测试脚本自己「玩游戏」
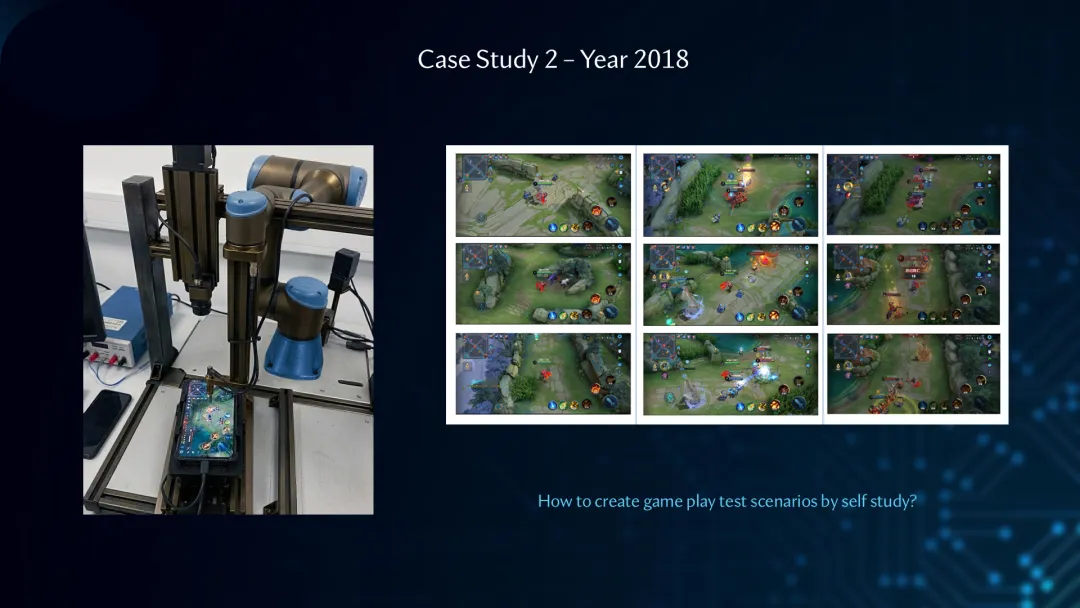
2018 年,我开始带领游戏 QA 团队做手游测试。新的挑战来了:如何让测试脚本自己生成?我们有海量的游戏画面,一直在琢磨,能不能用机器学习教会测试自动化「玩」游戏。
10 · 故事二 · 强化学习构建游戏 Agent
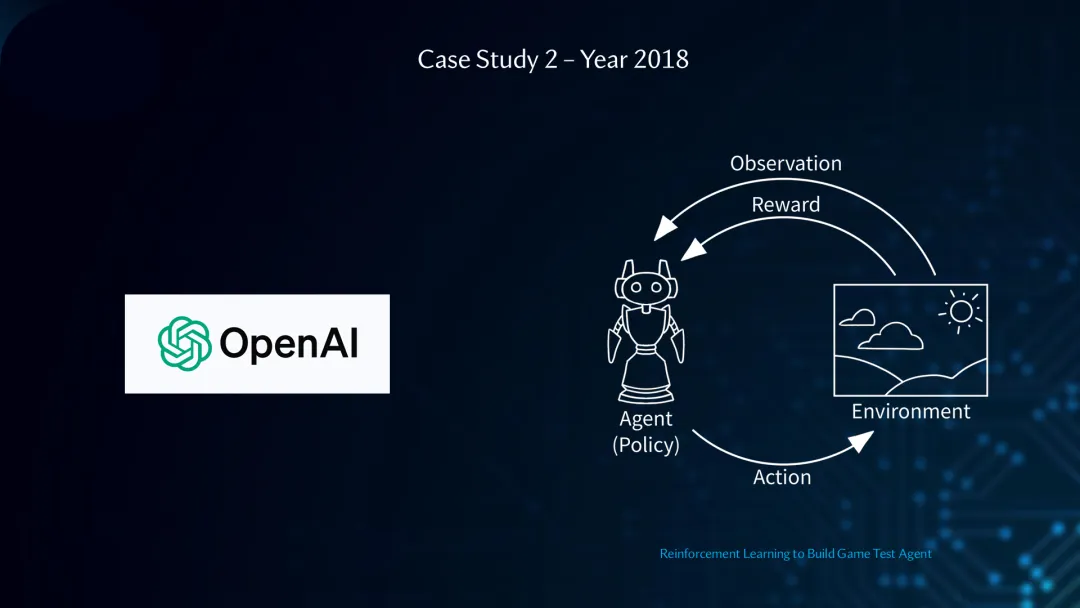
在座各位应该都知道 OpenAI。2018 年,OpenAI 发布了 GPT 1.0,但那一年它的主线其实是强化学习——这正是构建游戏 Agent、教它学会玩游戏的关键技术之一。右侧的图就是核心原理:Agent 如何通过「行动 + 从奖励中学习」不断积累经验。
我们也尝试打造自己的游戏 Agent,坚持了将近半年,最终还是失败了。最大的瓶颈是 GPU 硬件性能——我们拿不到预算支持。
11 · 故事二 · 对今天的启示:自愈的本质是「奖励」
虽然失败了,我又学到一课。举个大家都能理解的例子:
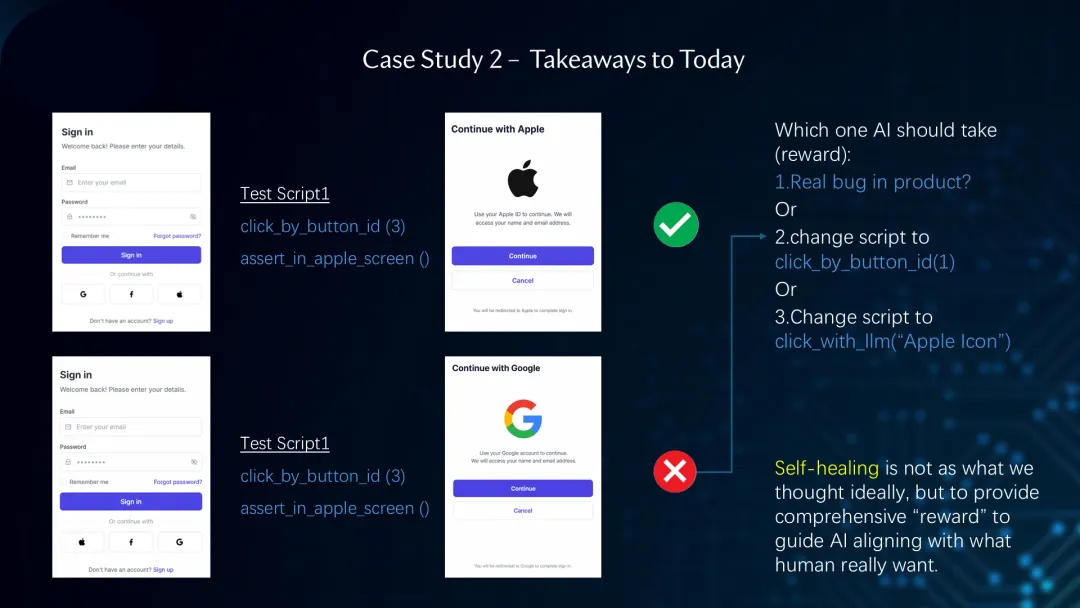
假设我们要测一个登录界面,测试脚本有两个步骤——先按按钮 id 点击,再断言是否进入了 Apple 界面。脚本刚写好时,测试是通过的。但某天开发改了 UI,把 Apple 和 Google 的图标换了位置,再跑测试就失败了。
那么问题来了:遇到这种失败,AI 有能力「自愈」吗?恐怕不能——如果你没有提供更多信息,AI 其实有三个选项:
发现产品里的真 bug? 把脚本改成点击第 1 个按钮? 用 LLM 把脚本改成「点击 Apple 图标」?
应该选择哪个作为「奖励」,取决于你真正想要什么。回想之前讲的强化学习:AI 需要人类的输入,才能学会你真正想要的是什么。
这正是自主测试与自愈测试的关键,也是 AI 测试的真相——自愈并非我们想象中那么理想,它的本质,是提供全面的「奖励」信号,来引导 AI 与人类真正想要的目标对齐。
12 · 故事三 · 2019 年:怎么测一个「AI 应用」?
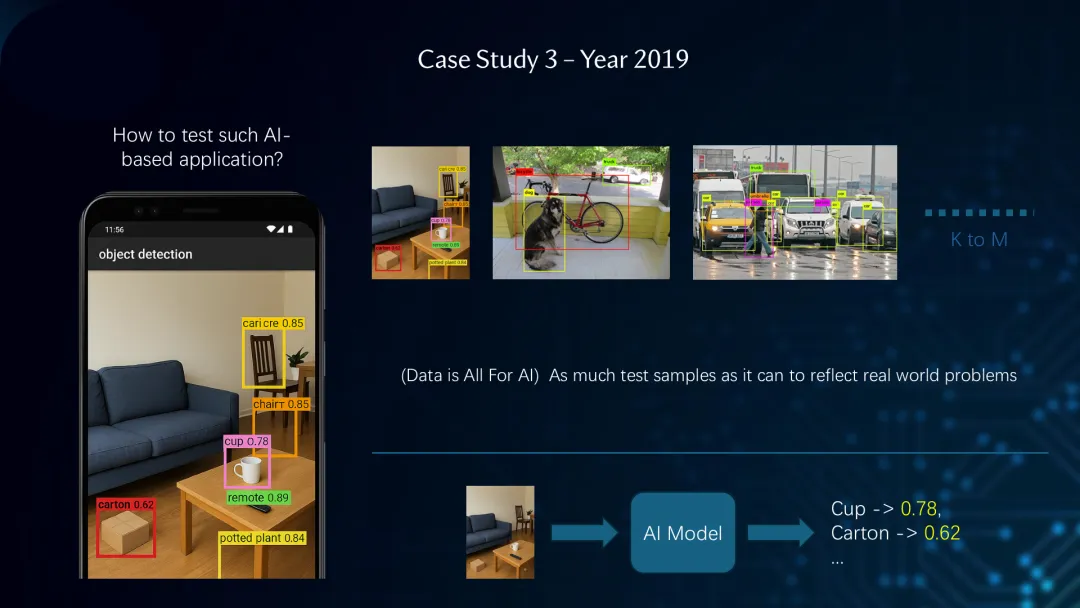
时间来到 2019 年,我们开始做基于 AI 的应用测试。这是一个物体识别工具:用手机拍一张照片,它会把图里的所有物体标注出来,比如「杯子 0.78、纸箱 0.62……」
这个时候我才真正理解「AI 模型」是什么:输入可以是任意格式的数据(比如二维数组),输出是另一个数组,但最关键的是——输出是带概率的。
所以,要验证这个 AI 模型是否按预期工作,我们必须准备海量带标签的数据。当时我们确信一个原则:「数据就是 AI 的一切」——只有拥有足够多的样本,才能反映真实世界的问题。
13 · 故事三 · 对今天的启示:可靠性比准确率更重要
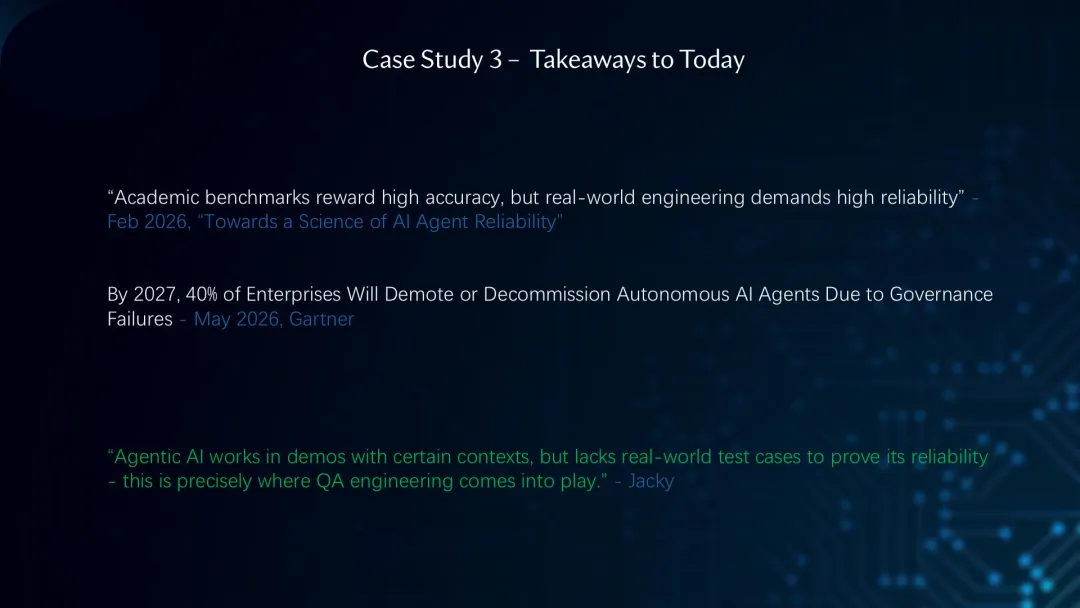
回到今天:如果我们想评估 AI Agent 或模型的性能与可靠性,唯一的办法就是从真实世界造数据。基准(Benchmark)分数只反映部分上下文,只能说它能映射你所在的那部分场景。
我引用了公开文章和评论里的两句话,它们都指向基准分数之外的现实问题:
「学术基准奖励高准确率,但真实世界的工程要求高可靠性。」——2026 年 2 月《迈向 AI Agent 可靠性的科学》 Gartner 2026 年 5 月预测:「到 2027 年,40% 的企业将因治理失败而降级或停用自主 AI Agent。」
所以,我对当下 AI 驱动测试工程师角色的判断是:
「Agentic AI 在特定上下文里演示得很好,但缺乏真实世界的测试用例来证明其可靠性——这正是 QA 工程大展身手的地方。」
14 · 故事四 · 2026 年:一句话驱动 Agent 自动测试
今年年初,我带领自动化专项小组,打造了自有的、基于 Agent 的自动化测试软件。
有了它,我们只需要给 Agent 发一条 prompt,它就会自动规划测试、执行测试、判定结果,最后把报告交给测试人员审阅。
接下来,请看现场演示……
15 · 故事四 · 对今天的启示:权衡的艺术
整个 Agent 软件花了 3 个月开发,用 Cursor 辅助(设计 + 代码生成约占 5% 的投入),其余 95% 的时间都在「尝试、调试、再尝试」。
这真的是一个工程活,因为你必须在不同因素之间做权衡:模型准确率、可靠性、token 成本、执行时长,还有合规、上下文、人在环路(Human in Loop)、ROI……
我们还要结合测试上下文不断调整 Agent:和团队负责人讨论 ROI,符合政策合规,一旦出现异常就给测试人员介入的机会。这中间积累了大量的「调试与平衡」经验。
我还记得一个例子:我们让它跑一个「拨打紧急联系人」的测试,结果 Agent 真的拨通了 911。
16 · 故事四 · 更多经验:选模型与 Harness 工程
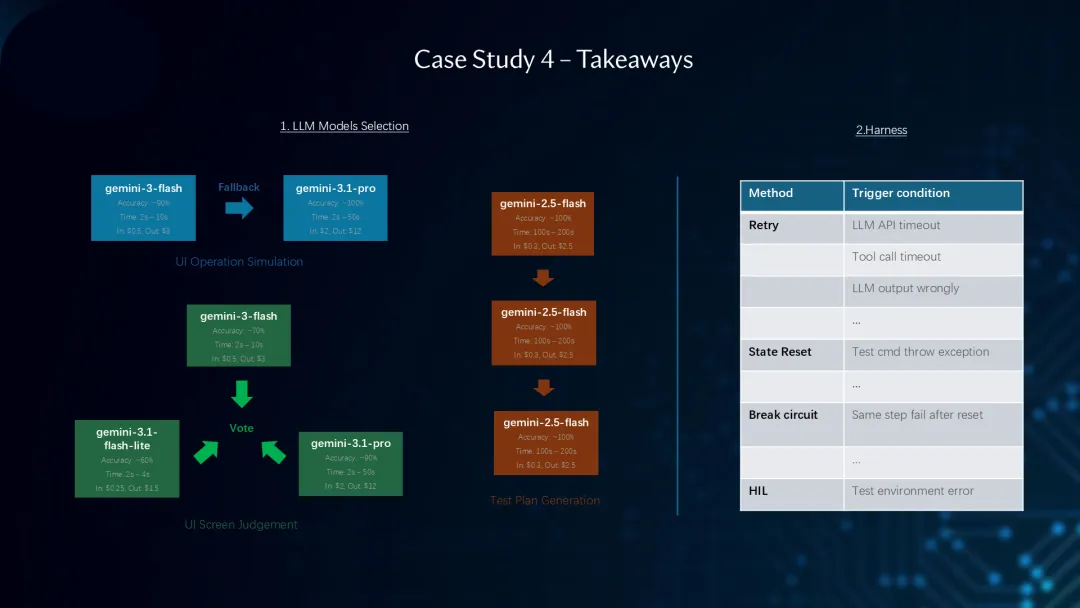
这个开发过程还有两点额外心得:
第一,模型越强大,准确率越高,但价格也越高;而且因为默认开启推理(reasoning),测试耗时也更长。所以我们必须选择合适的模型,在准确率、成本、时长之间取得平衡——比如在「测试计划生成、UI 操作模拟、界面判断、兜底」等不同任务上投票选择合适的模型。
第二,用「Harness 工程」(测试台/约束工程)的方法论来控制 LLM 的行为,提升 Agent 整体可靠性。这里列出了一些采用的方法:
- Retry 重试:LLM API 超时、工具调用超时、LLM 输出异常……
- State Reset 状态重置:测试命令抛异常……
- Break Circuit 熔断:重置后同一步骤仍失败……
- HIL 人在环路:测试环境出错时人工介入……
经过长时间优化,它已经能稳定运行:一小时大约执行 200 个 UI 测试步骤,总成本约 3.5 美元。
17 · 从过去到未来
好,我们把过去 12 年的几个故事都过了一遍。现在,让我把它们再总结一遍。
18 · 过去:从「提问」到「落地」
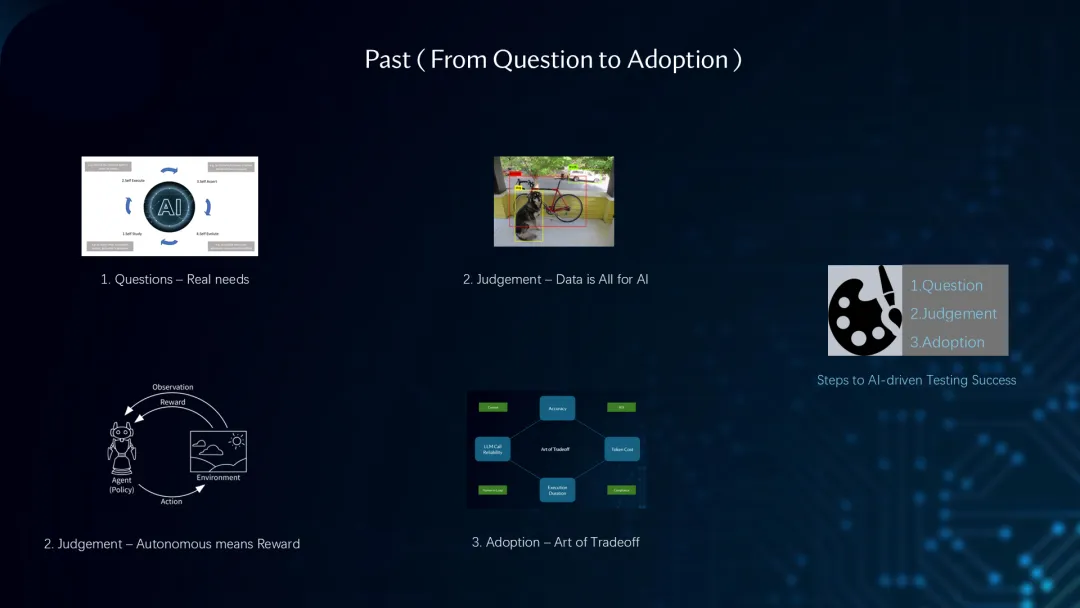
这就是到目前为止的四个启示。深入思考之后,我为自己找到了一条清晰的「测试匠艺」之路:
- 提问(Question)——从真实需求出发;
- 判断(Judgement)——实践出真知,例如:自主系统意味着要定义「奖励」;以及「数据就是 AI 的一切」;
- 落地(Adoption)——在工程实践中掌握「权衡的艺术」。
这,就是通往 AI 驱动测试成功的三步。
19 · 现在:层出不穷的 AI 新词
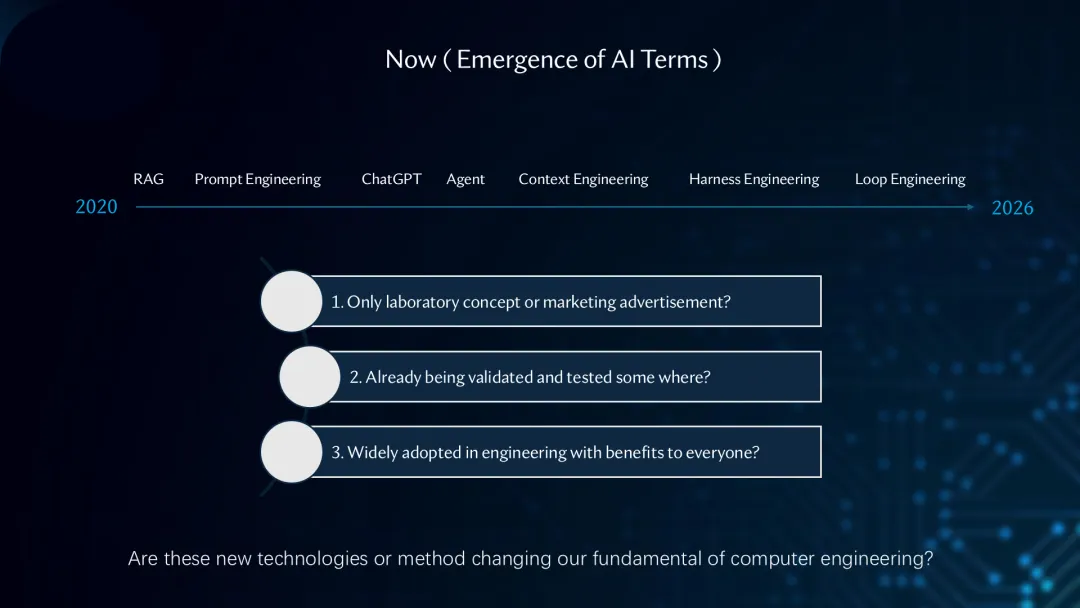
你可能会问:那怎么持续更新我们的 AI 知识?你可能会焦虑,因为 AI 发展得太快了。
从 2020 年到现在,涌现了一大批新术语:ChatGPT、RAG、Prompt Engineering、Agent、Context Engineering、Harness Engineering、Loop Engineering……
我们怎么安排时间去学习和体验它们?给你两个小建议:
第一,去判断一项新技术处在哪个阶段:是只出现在论文里?还是已经有人在特定场景验证过?还是已被广泛应用并产生了预期收益?这些是完全不同的里程碑,可能持续 2 年、5 年甚至更久。保持阅读,并思考这些术语现在处于哪个阶段。
第二,再问自己一个问题——这些新技术是否改变、又在多大程度上改变了计算机工程的根本?当你想清楚这些,焦虑可能就没那么重了。
20 · 现在:一个启发式探索框架
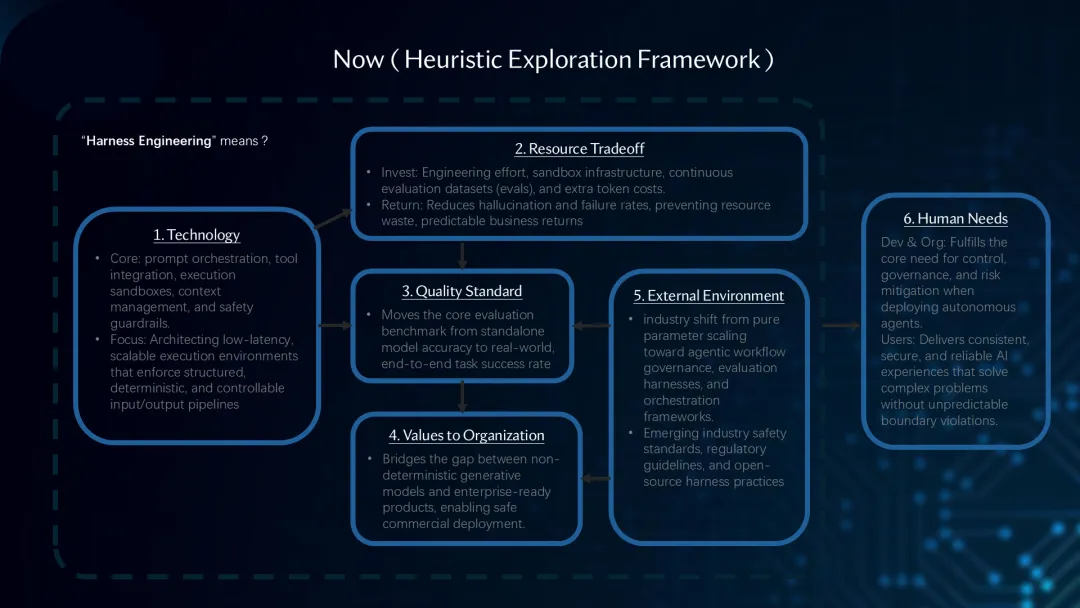
除了判断阶段,我们还可以建立一个更深的框架,持续追问新概念,帮助你形成完整的图景。以「Harness Engineering」为例,它到底意味着什么?
- 技术(Technology):核心是 prompt 编排、工具集成、执行沙箱、上下文管理和安全护栏;聚焦于构建低延迟、可扩展、输入输出可控的执行环境。
- 资源权衡(Resource Tradeoff):投入的是工程人力、沙箱基础设施、持续评估数据集(evals)和额外的 token 成本;回报是降低幻觉与失败率、避免资源浪费、可预期的业务回报。
- 质量标准(Quality Standard):核心评估基准从「模型准确率」转向「真实世界端到端任务的成功率」。
- 组织价值(Values to Organization):在「非确定性的生成模型」与「企业级产品」之间架起桥梁,让安全商用成为可能。
- 外部环境(External Environment):行业正从纯参数规模扩展,转向 Agentic 工作流的治理、评估 harness 与编排框架;安全标准、监管指南和开源 harness 实践也在兴起。
- 人的需求(Human Needs):对开发者与组织,它满足部署自主 Agent 时对控制、治理与风险缓解的核心需求;对用户,它提供一致、安全、可靠的 AI 体验。
这就是我设计的启发式探索框架——如果你想完整地理解一项新技术。
21 · 未来:我们不是先知,但我们可以梦想明天
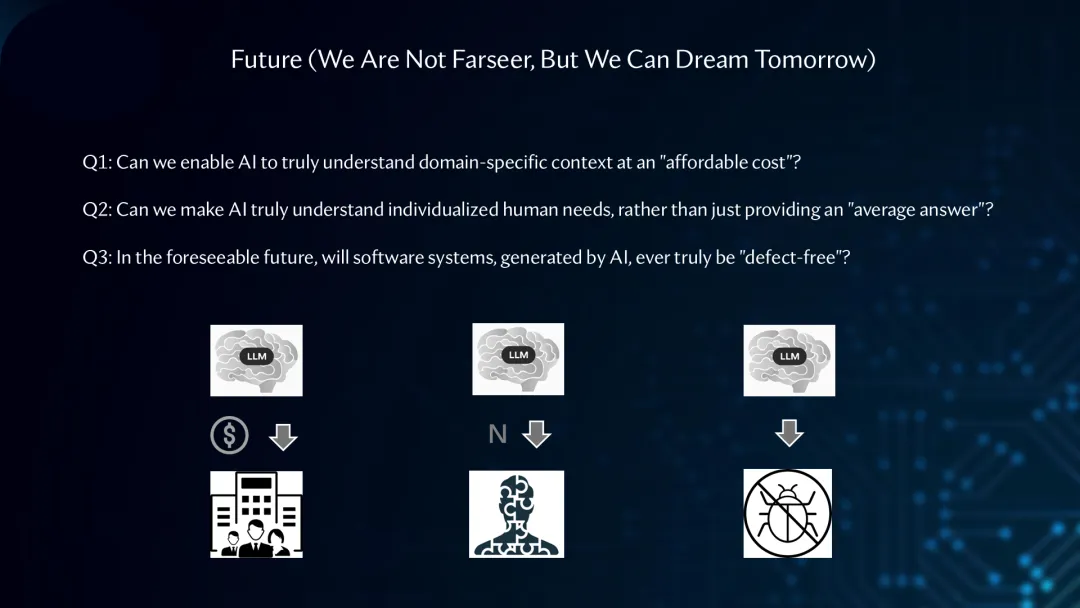
有些问题,我们现在还没有答案,但我们可以畅想未来。于我而言,我思考并写下了关于 AI(或者说 AGI)的三个问题,并一直用它们来指引自己:
- Q1:我们能否以「可负担的成本」,让 AI 真正理解领域特定的上下文?
- Q2:我们能否让 AI 真正理解个性化的用户需求,而不是只给出一个「平均答案」?
- Q3:在可预见的未来,由 AI 生成的软件系统,真的能做到「零缺陷」吗?
22 · 什么是「测试匠艺」?
我们今天的主题是「测试匠艺」(Testing Craftsmanship)。你可能会问:什么是测试匠艺?
23 · AI 时代,我对测试匠艺的定义
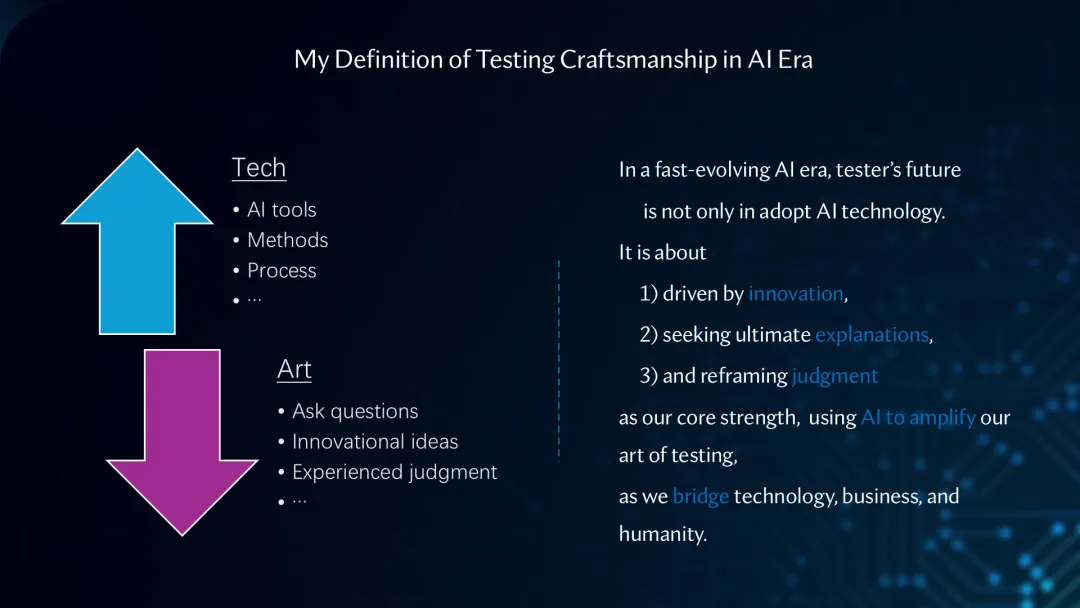
这是我给出的定义。匠艺包含两个侧面——「技术」与「艺术」:
在快速演进的 AI 时代,测试工程师的未来不只在于采用 AI 技术,更在于: 1)以创新为驱动; 2)追寻终极的解释; 3)重新定义「判断力」—— 把它们作为我们的核心力量,用 AI 放大我们的测试艺术,在技术、商业与人性之间架起桥梁。
24 · 轮到你了
好了,现在轮到你了:
如果公司明天宣布「我们要上线一个 AI 测试平台」,你最大的担忧是什么?技术?数据?ROI?还是你自己? 在你当前的工作流里,有没有一个最枯燥的测试任务,你愿意第一个交给 AI? 你理想中的「测试匠艺」,你会用一句话怎么描述?
25 · 收尾:AI 是画笔,你是艺术家
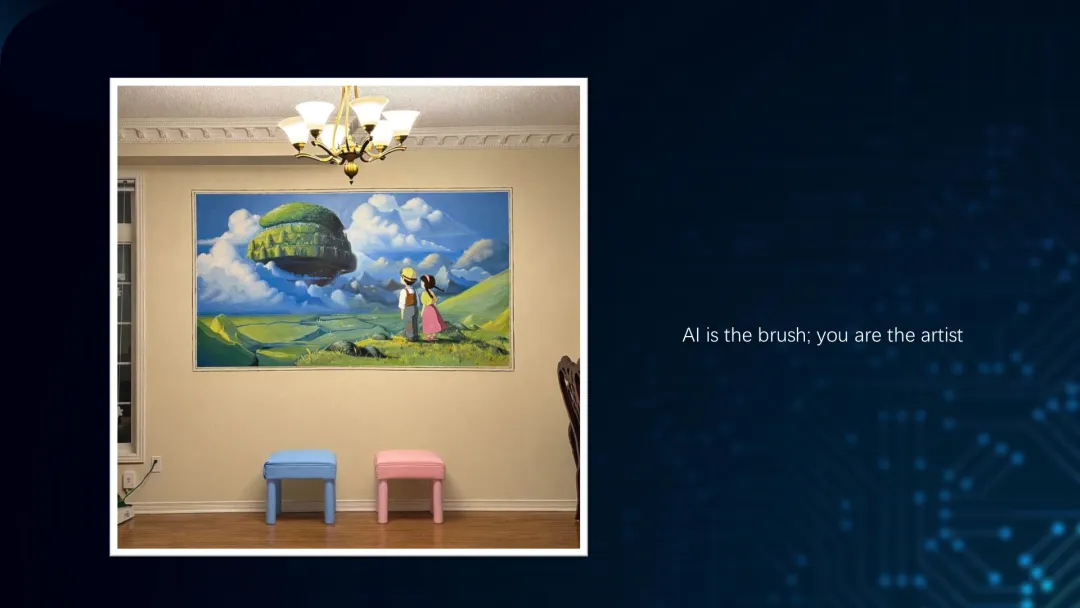
这是我的一幅画,今年年初我画在自己家的墙上。我想用它来为今天的分享收尾。
我希望今天的分享,能让大家继续思考:AI 对我们测试到底意味着什么?
感谢大家的到来。