ARTICLE · 1002884
给 AI 编程助手装一套免费联网:wigolo 把搜索成本砍到 0 美元的本地方案
你有没有算过,你的 AI 编程助手每个月在网上搜东西要花多少钱?
现在的 Claude Code、Cursor 这些 Agent,写代码时经常要查文档、搜资料、抓网页。这一整套"联网"能力,过去基本都靠云端的搜索 API 按次收费——查一次几毛钱,看着不起眼,但 Agent 干活是"突发式"的,一个任务可能连发几十次查询。一个月下来,这笔隐形的联网账单,往往比模型本身的 API 费用还吓人。
有个新项目想把这个成本直接砍到零,而且是彻底砍到零。
一个把"联网"搬回本地的 MCP 服务
wigolo 是一个本地优先的 AI Agent Web 层。它用 MCP(Model Context Protocol)协议,接在 Claude Code、Cursor、Codex、Gemini CLI 这些 Agent 旁边,给它们一套完整的联网工具:搜索、抓取、爬站、抽取、缓存、相似内容、深度研究、自主采集,一共十个工具。
它的卖点一句话能说清:不要 API key、不连云端、每查询 $0。搜索、抓取、爬站、抽取、缓存这些核心功能,开箱即用,不配任何 key。
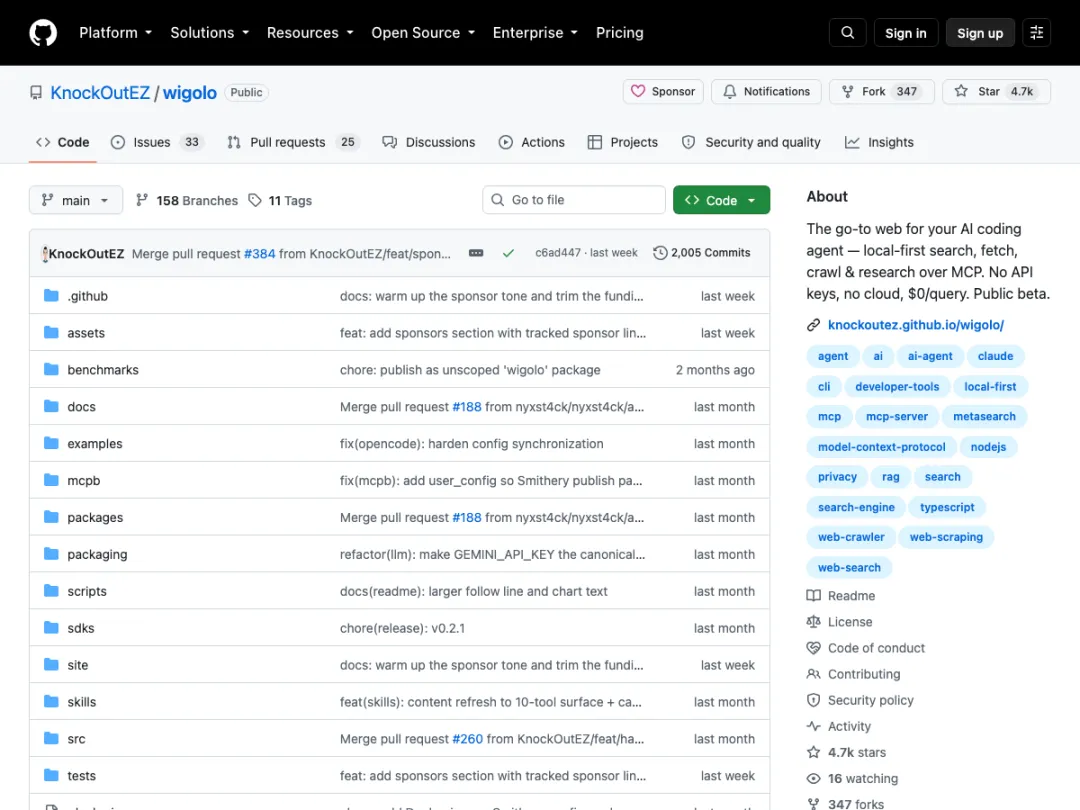 wigolo GitHub 首页
GitHub 地址: github.com/KnockOutEZ/wigolo项目 2026 年 4 月才创建,到现在已经 4.7k+ stars,还在公开测试阶段。用 TypeScript 写的,纯本地跑,要求 Node ≥ 20。
它凭什么能做到 $0/query
这是 wigolo 最值得琢磨的地方。云端的搜索 API 之所以按次收费,是因为搜索、重排序、嵌入这些重活都在服务商自己的服务器上跑,每个查询都要消耗他们的算力,所以必须计费。
wigolo 的思路正好反过来:把最贵的部分全部搬到你的机器上。
它本地装了一套"重脑"——一个完整的浏览器引擎,加上重排序模型和嵌入模型。这些正是云端服务在它们那边跑、然后向你收钱的东西。一旦装到你磁盘上,每次查询都用它,边际成本直接归零。
第一次初始化要占约 1.5GB 磁盘空间,装的就是这套本地大脑。装完之后,每一次搜索、抓取、重排、嵌入,都跑在你自己硬件上,不产生任何可计费的开销。
 计费经济模型对比
这张图把逻辑讲得很直白:云端 API 的成本随查询量线性上涨(斜率是重点),而 wigolo 是平的一条线。因为重排和嵌入在你硬件上跑,没有需要回收的每查询成本,也就没有装计费器的理由。
不是"免费的替代品",而是"诚实的结果"
很多人会想:免费的能好用吗?wigolo 的定位不是付费工具的廉价平替,而是"针对 Agent 场景重做的 Web 层"。它最特别的地方,是输出结果的可解释性和诚实度。
传统搜索 API 丢给你一堆结果就完了。wigolo 返回的每个结果,都带着完整"解剖报告":
一段逐字摘录,精确到在源网页的字节位置( source_span标注起止偏移)一个可解释的评分,拆成语义匹配、词法匹配、域名质量、多引擎共识几个维度 一个引用编号,Agent 可以直接引用出处 - 如实标注降级情况——哪个引擎超时了、哪个结果被判为垃圾、缓存是不是旧的,全部写进返回结果里
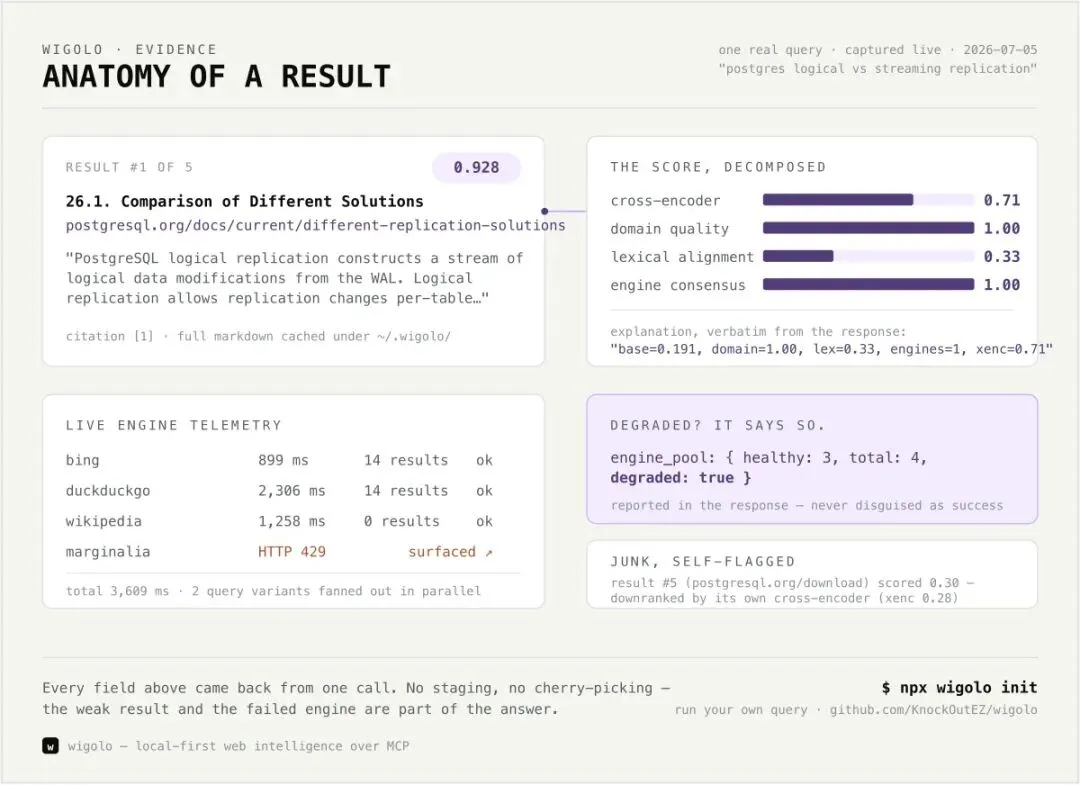 结果解剖图
这张"结果解剖图"很能说明问题:一个 0.928 分的搜索结果,下面清清楚楚拆出了 cross-encoder 0.71、域名质量 1.00、词法匹配 0.33、引擎共识 1.00 这几个子分,还附上模型原话的解释。右边甚至如实显示有一个引擎(Marginalia)返回了 HTTP 429 限流——系统没有把这个失败藏起来,而是作为答案的一部分呈现。
对 Agent 来说,这种诚实很重要。它知道自己站在什么证据上,遇到降级能判断要不要换条路,而不是被一个包装好的错误结果带偏。
18 个引擎融合,单个挂了也不慌
wigolo 的搜索不是简单代理某个搜索 API。它背后接了 18 个公开搜索引擎的直接适配器,然后用 rank fusion(排名融合)把多路结果合并,再用本地的 ML 模型做重排序。
这么设计的好处很实在:单个引擎被限流、被封、或抽风,对整体结果几乎没影响。README 里专门提到,公开引擎"会坏、会被封"是常态,wigolo 就是冲着这个设计的——18 路融合 + 本地缓存兜底,哪怕所有在线引擎都挂了,之前缓存过的东西照样能查。
 Claude Code 通过 wigolo 演示
抓取也是同理。它不是拿个简单 HTTP 请求硬拉网页,而是有一套分层升级的路由器:先走普通 HTTP,遇到反爬挑战或 SPA 动态页面,就自动升级到无头浏览器引擎。而且这个升级是"看信号"决定的——根据页面是不是 SPA、有没有挑战代码、内容够不够厚来判断,不是靠猜域名,还会按域名学习、记住哪些站需要浏览器。
和 Firecrawl、Exa、Tavily 比,差在哪
wigolo 在自己的基准测试里,把四种 Web 工具放一起跑了同一查询:内置 WebSearch、wigolo、Tavily、Exa,四个都收敛到同一个答案。区别在证据和成本上。
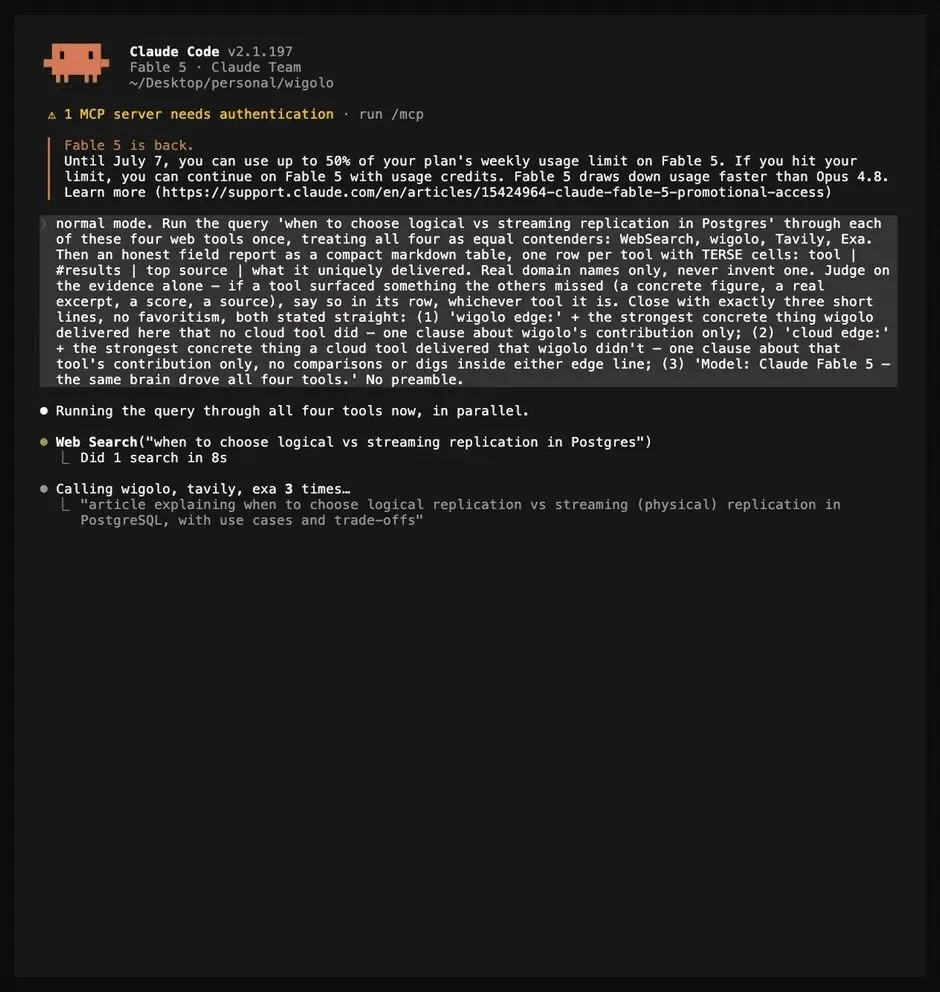 四路对比基准
对比几个关键维度:
- 多引擎搜索:四家都有
- 整站爬取:wigolo、Firecrawl、Tavily 有,Exa 没有
- 逐字摘录 + 字节级出处:只有 wigolo 有
- 可解释评分分解:只有 wigolo 有
- 本地持久缓存(重复查询秒回、可离线):只有 wigolo 有
- 数据留在本机:只有 wigolo 有
- API key / 账号:wigolo 不要,其余三家都要
- 每查询成本:wigolo 是 $0,其余按次计费
一句话:功能和云端工具对齐,但多了“证据可审计”和“本地免费”两个独家能力,代价是要在本地装那套 1.5GB 的重脑。
上手很简单
安装就一条命令:
bash npx wigolo init --agents=claude-code,cursor
这会在你机器上装好本地引擎(浏览器 + 模型),并顺手把 Claude Code、Cursor 这些你常用的 Agent 接上。想验证健康状态,跑 npx wigolo doctor。
核心搜索、抓取、爬站、抽取、缓存都不需要 key。只有 research、agent 这两个深度研究工具,以及搜索的"直接给答案"模式,需要调 LLM 来写合成答案——这时你可以选配一个免费的 Gemini key,或者用本地的 Ollama,保持完全无 key。
除了接 MCP,它还能以 REST API 起服务(wigolo serve,curl 直接调)、用 TypeScript/Python SDK 内嵌、甚至通过 Docker 起成远程服务给自托管的 Agent 用。
值得留意的代价
把话说透,wigolo 也不是没有取舍。
1.5GB 本地重脑——这是最大的门槛。装一次占 1.5GB 磁盘,对大多数人没问题,但如果你只是想偶尔搜一下,这个初始化成本可能偏重。它是冲着"长期重度使用"设计的。
研究类工具要 LLM——搜索、抓取这些核心工具无 key,但写合成答案的 research/agent 需要 LLM。想完全无云,得再配个本地 Ollama,又多一层折腾。
公开引擎会被封——wigolo 靠 18 路融合 + 本地缓存兜底,但极端情况下(比如数据中心 IP 被集体拉黑),在线搜索质量会下降。它对自托管用户有个提醒:某些反爬严格的网站会看 IP 信誉,机房的 IP 不一定能过家用宽带的墙。
AGPL-3.0 协议——本地当工具用零义务;但如果你修改了它并作为网络服务对外运行,必须把修改后的源码按同样协议开源。这个协议设计得很聪明:既保住了开源,又堵死了"有人 fork 一个闭源托管版来收费"的路。
我的判断
wigolo 最打动我的,不是"免费"这个标签,而是它把 Agent 联网这件事的经济模型和信任模型一起改了。
经济上,它用"重活本地化"破解了按查询计费的死结——Agent 越爱问、越值得用,因为成本是平的。信任上,它把每个结果的可解释评分和字节级出处摆在台面上,失败和降级不藏,这是很多商业 API 都不愿意给的透明。
它适合谁?适合重度使用 AI 编程助手、天天让 Agent 联网查资料的技术人——只要你的查询量上来了,本地这套几乎必然比云端按次付费划算。也适合对数据隐私敏感、不想让查询内容过云的人。
不适合谁?偶尔才用 Agent、查不了几次的轻度用户,1.5GB 初始化成本可能不值;以及必须要云端聚合器兜底、担心公开引擎不够稳的企业级场景——不过说实话,对大多数个人开发者来说,wigolo 已经提供了一个相当完整的本地联网方案。
在 AI Agent 越来越"联网化"的今天,把联网能力从云端搬到本地,这个方向本身就是值得关注的事。