ARTICLE · 1003640
退回手敲 Excel,不是自动化失败
前几天刷到一位研究二战德国空军损失记录的研究者,分享的一段经历。
因为手里的史料版式五花八门,有扫描件,有旧表,他就想试试用 AI 做 OCR(一种把图片、扫描件、PDF 或照片里的文字,自动转换成电脑能直接读取、编辑和搜索的文本文字的识别技术) 和抽取,把这些资料整理成结构化数据。
表格确实做出来了。
行列整齐,每个字段都有内容,看起来相当漂亮。
可等他对照原始资料逐条检查的时候,错行、错字段多到没法接受。
最后他忍无可忍,直接放弃 AI 这条路,回到手工 Excel,一条一条敲。
这件事只看表面,很容易被当成 AI 又翻车了的例子,或者反过来,被解读成他不会用工具。
我觉得两种读法都错了。
他做的其实是一件很专业的事,在一套流程还没有资格对结果负责的时候,把它停下来。
PART 01
跑通了,才是最容易放松警惕的时候
这种项目最容易让人放松警惕的时刻,往往不是 AI 识别不出来,而是它识别出来了。
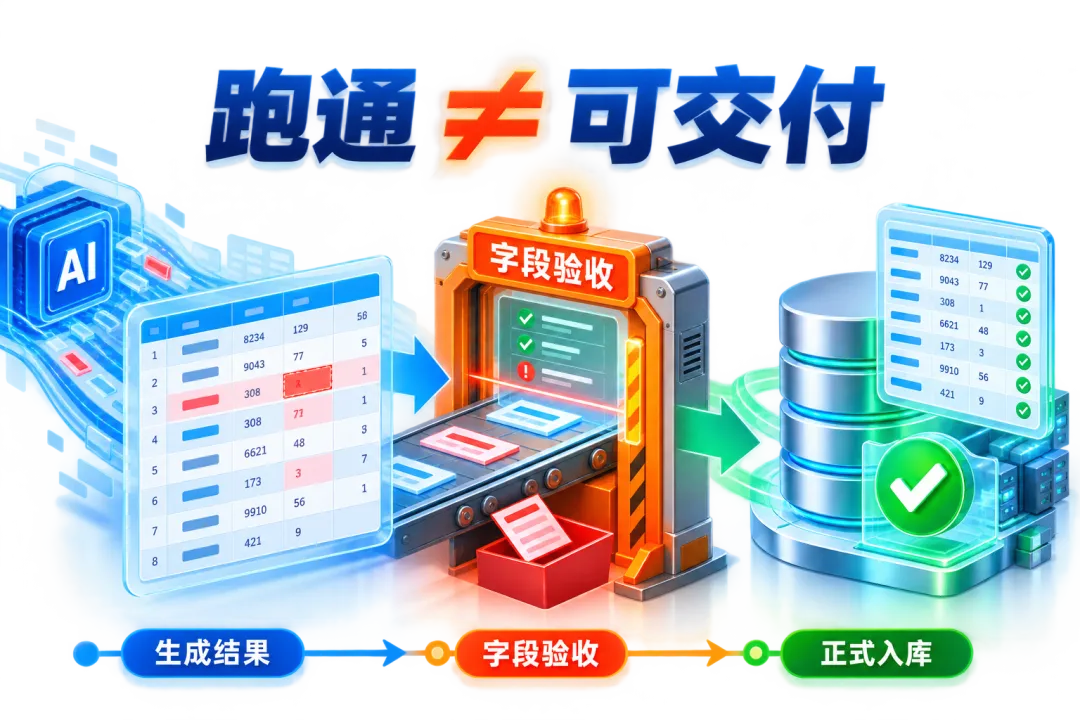
文件上传成功,文字提取出来,行列整理好了,Agent 报告任务完成。
你打开 Excel,看到每个单元格都有东西,格式整齐漂亮,貌似可以入库了。
问题要等领域专家开始对照原件才会浮出水面。
某个日期落到了下一行,某个人名和另一条记录拼在了一起,某个编号格式完全正确,却对应到了错误的对象。这些错误不集中,不重复,也不会主动报错。它们随机散落在行列之间,穿着整齐格式的外衣,和正确的数据长得一模一样。
一个明确的报错其实是好事,它能告诉你出了问题。
真正麻烦的是无声无息的错误,你不知道它在哪,只知道它肯定在。
PART 02
当自动化从手段变成了目标
接下来的问题更有意思。
明知结果不能用,却很少有人立刻退回手工,更常见的动作是换一个模型,改一遍提示词,调整输出格式,再跑一批样本,发现又冒出另一种错误,然后继续,相信再优化一次应该行。
做这个选择不奇怪。
流程已经完成了大部分可见的动作,放弃它不像停止一个无效方案,更像亲手推翻一个只差最后一点的项目。
背后还有一层更隐蔽的机制。
这个项目真正的目标本来很清楚,得到一份字段正确、来源可追溯、能进正式数据库的资料。但这个目标需要专家核对才能确认,反馈慢,也很难用一次演示证明。
相比之下,OCR 读了多少页,Agent 有没有跑完,Excel 有没有自动生成,自动化提升了几个效率点,这些进展看得见,说得出,有成就感。于是评价标准悄悄发生了替换,从数据能不能可信交付,变成了自动化能不能继续跑。
一旦手段替代了目标,继续换模型加规则都会被理解成推进项目,而停下来回到人工验收,反而被看成倒退。
这就解释了一个看起来矛盾的现象,明明自动化产出的结果不能用,人还是觉得退回手工是一种失败。失败的从来不是交付目标,而是那个后来被偷换进去的自动化目标。
你不是从 AI 退回手工,而是从展示进度退回交付责任。
PART 03
真正该比较的是完整交付成本
旧的比较方式很简单,AI 抽取一次生成整张表,快,人工一条一条录,慢,所以 AI 先进。但这只比了前半段。
可靠交付比的是完整成本,提取成本,加验收成本,加纠错成本,加返工成本,再加错误进入下游之后的污染成本。
如果 AI 的结果仍然要由领域专家逐条对照,AI 省掉的只是敲键盘的动作,没有省掉最贵的那部分,专业判断。如果还要排查随机错位,完整成本甚至可能高于直接录入。
在这里,要说一下边界,手工录入并不天然正确,它同样会错。但在字段规则清楚、有人复核、原始资料可以逐条追溯的前提下,手工的错误通常停留在局部,知道是谁录的,能回到哪一页原件,可以在哪一道关口修正。
AI 抽取的错误是另一种性质,格式完整,内容看似合理,随机散落在行列字段之间。只要这些没验证过的数据进了正式库,它就会继续参与筛选、统计、关联,被后面的人和 Agent 当成事实引用。
一个字段错位,被当成正式数据保存,进入统计,形成结论,结论又被引用。
到那时要修的已经不是一个单元格,而是所有建立在它之上的判断。
今天省掉的一次核对,会变成未来越来越难追溯的一笔债务,我把它叫做数据债务。
举个例子。一份资料有 1000 行,AI 整体准确率 95%,听起来不错,但仍然有 50 处错误。如果这些错误随机分布,没有置信度提示,其中又包含日期、编号、分类这类关键字段,那为了把它们找出来,人可能要对全部记录核对一遍。
平均准确率回答不了能不能交付这个问题。
真正要问的是,错误落在哪些字段,能不能被自动标记,抽检能不能代表整体,漏掉一处后果多大,验证全部结果要花多少专业时间。
所以我更愿意换一个指标。
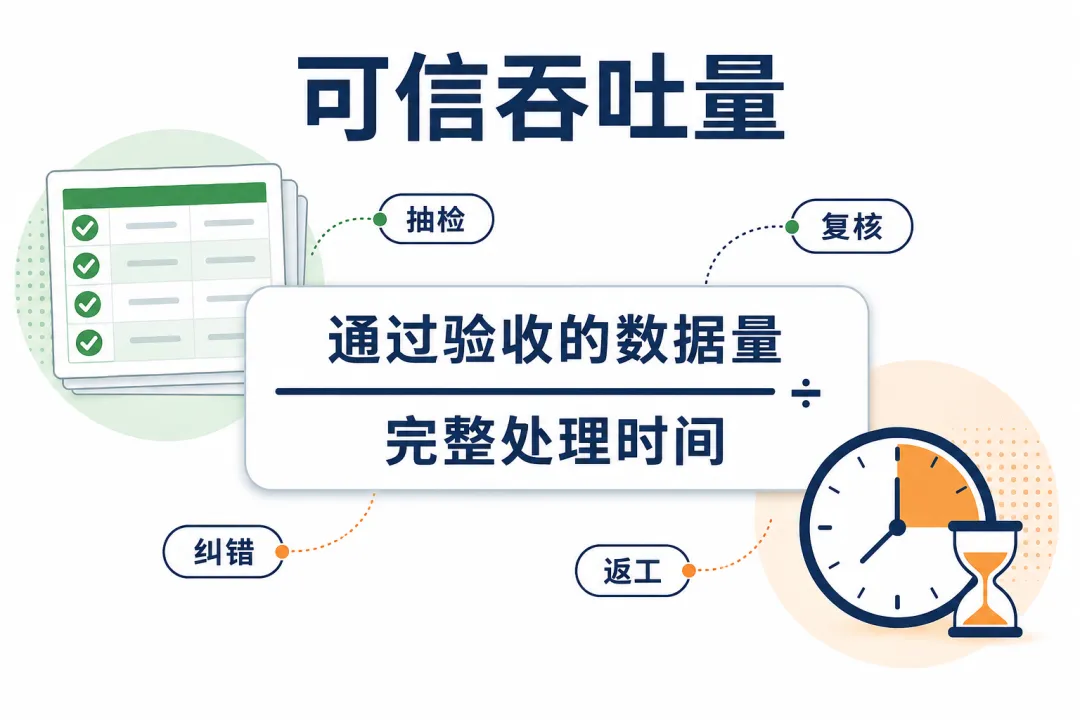
与其看一小时生成了多少行,不如看一小时最终得到多少条通过验收、来源可追溯、可以进入正式系统的数据,暂且叫它可信吞吐量。
分子是能用的数据,分母是包含抽检、复核、纠错、返工在内的完整时间。用这个指标一算,很多所谓跑通了的流程,可信吞吐量可能接近零。
PART 04
退回手工,是重新设计验收的起点
那退回手工就完了吗?也不是。
退回手工不是终点,而是重新设计验收的起点。
第一步,先定义哪些字段不能错。不要先问 OCR 准不准,先把字段分成三类。
关键字段,错一处就可能改变记录身份或统计结果,必须逐项验证。
一般字段,允许少量错误,抽样检查就行。
辅助字段,只用于检索和阅读提示,错了不进核心判断。
连哪些字段不能错都没定义,就谈不上验收标准,也就没法判断模型可不可用。
第二步,建一个隔离区。
原始资料先进 AI 预填区,经过异常标记和字段核对,进入验收通过区,最后才是正式数据库。
没验证过的数据只能停在预填区,后续的分析和 Agent 不能把它当正式事实调用。
这一步的意义在于,让错误留在还能被发现的地方。
第三步,用小样本看错误的结构,而不只看平均数。
跑一小批有代表性的复杂资料,记录哪些字段最容易错,错误是集中在某种版式还是随机出现,有没有可以写成规则的异常特征,验证一条记录要多久。这一步的目的不是继续证明 AI 有多强,而是判断错误是否可控。
然后设停用和恢复条件。关键字段随机出错且没法靠规则提前发现,没有可靠的异常标记,必须逐条对照才知道对不对,修正成本接近甚至超过直接录入,这些都是停止 AI 主路径的信号。
停下之后,关键字段改由人工录入,AI 只负责预填、转录、格式整理和辅助检索,每条正式记录保留到原件的追溯关系,人负责异常判断和最终入库。
而当版式被拆成若干稳定类型,关键字段可以交叉验证,AI 能稳定标记低置信度记录,人只需核对少量异常,小样本验收连续达标,自动化就可以逐步恢复。
下一次想再换一个模型之前,先回答三个问题。
错误能不能定位到具体字段?没验证的数据能不能和正式库隔离?完成可靠验收的成本,是不是真的低于直接录入?三个都回答不了,就先停一下,而不是换一个 OCR 继续碰运气。
PART 05
成熟的自动化,必须知道什么时候停
初级自动化追求的是机器能不能把动作做完,成熟的自动化追求的是系统能不能稳定交付,并在不确定的时候主动停下来。
一套真正专业的流程,不只写正常执行的路径,还写明了哪些结果必须验收,什么异常必须拦截,什么时候降级,什么时候把责任交还给人,满足什么条件才重新放开。没有停止条件的流程,本身就还没设计完。
退回人工也不等于人要永远手敲。人回到的是当前最关键的位置,定义字段,判断错误代价,设定验收标准,处理异常,对最终入库负责。
执行可以逐步交给 AI,但定义、验收和责任不能一起交出去。当这些标准能够被表达、被记录、被机器检查,自动化才有条件重新扩大。
模型生成结构化结果只会越来越容易。
真正拉开差距的,是谁能定义结果标准,谁能发现无声的错误,谁能建立可追溯的验收链路,谁敢在流程不成立时停下来。这条规律不只适用于史料抽取,写作、代码、研究整理和业务自动化里都一样。
所以那位研究者退回手敲 Excel,不是自动化失败,而是项目重新开始对结果负责。
以上,既然看到这里了,如果觉得不错,随手点个赞、转发一下吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。