ARTICLE · 1004215
(文档)第135讲:DB4AI-搭建PG向量数据库AI机器人
RAG概述
RAG(Retrieval Augmented Generation)顾名思义,通过检索的方法来增强生成模型的能力,它是一个为大模型提供外部知识源的概念,这使它们能够生成准确且符合上下文的答案,同时能够减少模型幻觉。它的特点如下所示。
检索(Retrieval ): 根据用户请求从外部知识源检索相关上下文。
增强(Augment): 用户查询和检索到的附加上下文被填充到提示模板中。
生成(Generate): 检索增强提示被馈送到 LLM。
大模型局限性缺陷
l可靠性问题
事实性错误:大模型经常犯事实性错误,这是因为它们的训练数据中可能包含错误信息或者模型在生成文本时出现“幻觉”现象。
过时信息:由于大模型的训练数据是固定的,它们无法实时更新知识,因此可能会提供过时的信息。
l逻辑推理挑战
数学和逻辑能力:尽管大模型在自然语言处理方面表现出色,但在复杂逻辑和分析能力的测试中表现并不理想。
深度推理问题:在进行多步骤的逻辑推理时,大模型的准确性迅速下降,因为它们每一步的预测准确率虽然高,但累积误差会逐渐增加。
l语义理解局限
形式语义理解:大模型在语义理解上仍有待提升,尤其是对于语言背后的意义和形式的完全理解。
领域特异性知识:大模型在特定领域(如医学或法律)的知识掌握上存在缺陷,需要结合领域专家系统进行改进。
l可解释性和可调试性弱点
黑盒模型问题:大模型通常被视为黑盒,其内部工作原理不透明,这导致其可解释性和可调试性较弱。
错误难以定位:由于大模型结构复杂,当其输出出现错误时,很难准确找到问题所在并进行修复。
l技术和应用挑战
计算资源需求:大模型需要大量的计算资源和存储空间,这限制了其在资源有限的环境中的使用。
部署和运行挑战:随着模型规模的增大,训练时间和运行成本急剧增加,给实际部署带来困难。
l伦理和社会影响
隐私和安全问题:大模型在处理个人数据时可能存在隐私泄露的风险,需要严格管理和保护用户数据。
偏见和公平性:如果训练数据中存在偏见,大模型可能会继承并放大这些偏见,影响其输出的公平性和客观性。
RAG解决什么问题
l知识更新滞后
传统大语言模型( LLM )依赖离线训练数据,无法获取训练后的实时信息。RAG通过连接动态更新的外部知识库,使模型能够接触并利用最新数据,避免知识截止日期限制。
l幻觉现象
LLM在面对未训练过的问题时,比如私有的领域/业务知识,可能生成不准确或虚构的内容。RAG通过检索外部知识库,减少模型“编答案”的概率,使回答更具依据。
l缺乏可解释性
RAG将检索结果与用户问题结合构建上下文,使模型基于“所给材料”生成答案,增强回答的可解释性。
使用RAG的优点
l提高准确性: 通过检索相关的信息,RAG可以提高生成文本的准确性。
l减少训练成本:与需要大量数据来训练的大型生成模型微调相比,RAG可以通过检索机制来减少所需的训练数据量,从而降低训练成本。
l适应性强:RAG模型可以适应新的或不断变化的数据。由于它们能够检索最新的信息,因此在新数据和事件出现时,它们能够快速适应并生成相关的文本。
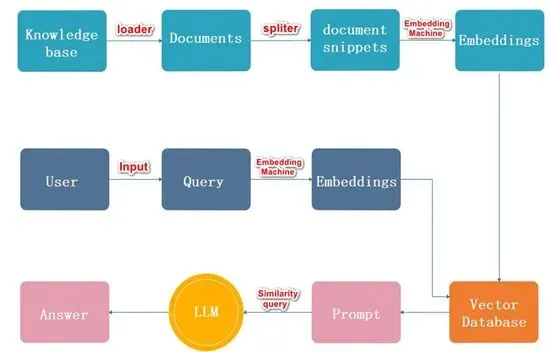
RAG系统工作流程图解
流程描述:
1.加载,读取文档
2.文档分割
3.文档向量化
4.用户输入内容
5.内容向量化
6.文本向量中匹配出与问句向量相似的top_k个
7.匹配出的文本作为上下文和问题一起添加到prompt中
8.提交给LLM生成答案
总结
数据库对象权限概述
数据库中现有表权限授权
数据库中未来表权限授权
public模式权限授权难言之隐
你到底让我怎么做你才高兴
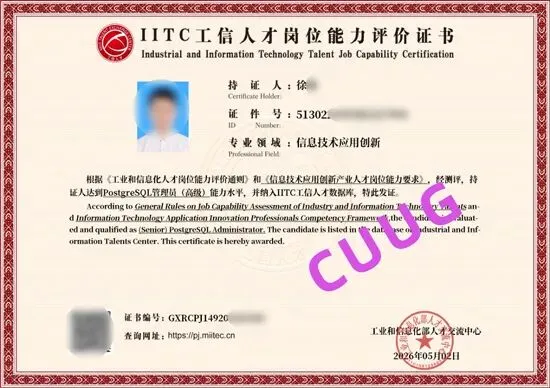
PostgreSQL中文社区认证
与工信部人才交流中心合作,推出PostgreSQL初/中/高级证书,证书中明确指定适用于信息技术应用创新人才岗位能力评定要求。
PostgreSQL从入门到精通,
系列课程始于23年初,
在周日19:30与大家分享PG技术,
从基础的PG介绍与安装,
到后续的调优、流复制等企业应用,
涉及90多个知识点的介绍与演示,
截至25年8月9日,
系列课程已讲100期,
欢迎继续关注PostgreSQL技术大讲堂,
如果你也有意学习PostgreSQL,
可以联系客服,领取相关资料。