ARTICLE · 1005976
AI日报:工信部出手,2030年关键软件全面智能化
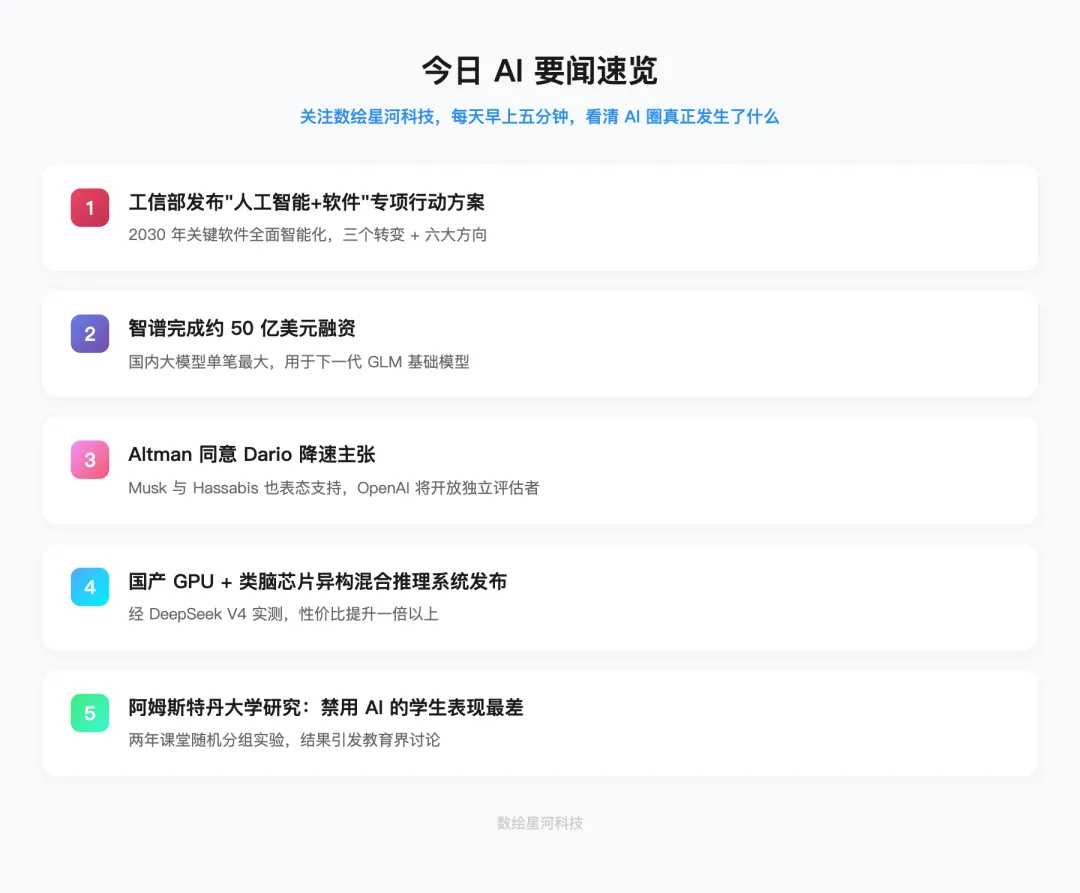
1. 工信部发布《"人工智能+软件"专项行动方案》:2030 年关键软件全面智能化
9月11日,工业和信息化部对外发布《"人工智能+软件"专项行动实施方案》,提出分两步走:到 2028 年,推广应用覆盖 2 万家规模以上软件企业,打造 100 个智能体软件标杆应用;
到 2030 年,关键软件全面实现智能化升级。
方案部署了六大方向:推进软件生产变革、加快软件产品智能化升级、培育智能体软件新业态、拓展智能软件服务、夯实发展基础、优化产业环境。
核心是三个转变:软件开发从"人工编写"向"人机协同"转变、软件产品从"被动响应"向"主动执行"转变、软件服务从"产品交付"向"价值交付"转变。
方案还专门提到工业软件的两条升级路径:AI 辅助(在既有架构上叠加智能功能,见效快)和 AI 原生(由模型承担软件核心能力,重塑研发与运行逻辑)。
这两条路径同时鼓励,意味着政策制定者清楚:改良解决眼前问题,重构才有长期竞争力。
安全方面也有明确部署:开发环节突出"以智促安、防治结合",产品环节突出"行为可控、全程可溯"。智能体软件不是想怎么做就怎么做——做不到审计追踪,连准入都可能有问题。
这是国内第一次从政策层面系统回答"AI 时代软件业怎么办"。 之前的政策关注点是芯片和模型,这一份关注的是软件怎么用 AI 重做、智能体怎么变成产品、企业怎么真正受益。
政策叙事的变化,就是行业阶段的变化。方案里的 2028 年目标只有两年多,2 万家企业不会自己完成。
如果你在做软件产品,该问的不是"要不要用 AI",而是"我的产品里,哪一部分能被智能体替代"。
2. 智谱完成约 50 亿美元融资,用于下一代 GLM 基础模型
智谱宣布完成约 50 亿美元(约 336.54 亿元人民币)融资,包括约 20 亿美元股份配售及约 30 亿美元可转债发行,资金将用于下一代 GLM 基础模型及完全自训练的研发。
50 亿美元是什么概念?折合人民币超过 330 亿,超过国内大多数 AI 创业公司累计融资总额。而且这不是估值炒作——其中 30 亿是可转债,意味着投资方真金白银地押注智谱的技术路线。
智谱是国内最早做大模型的团队之一,GLM 系列从对话到代码到多模态已经迭代了多代。这次融资的用途很明确:下一代 GLM 基础模型 + 完全自训练。
"完全自训练"指的是不依赖外部开源模型做起点,从零开始训练——这条路成本更高,但对底层能力的掌控更深。
这是国内大模型公司单笔最大融资。 在 DeepSeek 用极低成本证明"小团队也能做前沿"之后,智谱押注的是另一条路:资金密度加全栈自训。
两条路线的竞争结果,会直接影响国产模型的走向——拼成本效率还是拼资源投入,2027 年见分晓。
3. Altman 同意 Dario 降速主张,Musk 与 Hassabis 也表态支持
OpenAI CEO Sam Altman 回应 Dario Amodei 的《We Must Pace the Frontier》,同意需要为前沿 AI 发展设定节奏,称 OpenAI 将同样开放独立评估者访问。
这件事重要的原因有两个。
第一,OpenAI 和 Anthropic 是最直接的竞争对手,两家公司的 CEO 此前在几乎所有议题上都有分歧。
Altman 同意 Dario 的核心主张——能力发展太快、安全研究跟不上、需要行业协调——意味着"该不该慢"在头部公司层面已经不是争论问题。
第二,Elon Musk 和前 DeepMind CEO Demis Hassabis 也分别表态部分支持。四家最大 AI 公司的掌门人站在了同一立场上。
三大 AI 巨头的 CEO 在 48 小时内先后表态,这在 AI 行业还是第一次。
但共识归共识,第二步(行业协调)和第三步(全球协调)需要政府介入和反垄断豁免——能不能落地,取决于各国政府的意愿,不是 CEO 们说了算。
4. 国内首个国产 GPU + 类脑芯片大模型异构混合推理系统发布
移动云联合中国电子科技南湖研究院、灵汐科技、天数智芯、清华、北大发布国内首个国产 GPU + 类脑芯片大模型异构混合推理系统。
先解释"异构混合":把两种完全不同类型的芯片放在同一个系统里协同工作。GPU 擅长并行计算,处理大模型的矩阵运算;类脑芯片擅长低功耗事件驱动,处理推理中的稀疏计算。
两种芯片各干各自擅长的事,整体效率比单用一种高。
经 DeepSeek V4 实测,这套系统的性价比较同类国产 GPU 算力集群提升一倍以上。
这条的关键词是"绕开"。 在先进制程受限的背景下,单点芯片性能追赶难度很大。但架构创新不需要最先进的制程——让不同的芯片各干擅长的事,整体效率就能翻倍。
如果能规模化部署,国产算力的路就多了一条。
5. 阿姆斯特丹大学两年研究:禁用 AI 的学生表现最差
阿姆斯特丹自由大学法学教授 Thibault Schrepel 做了一项持续两年的实验:在《Law of AI》课程中,将学生随机分为三组——完全禁用 ChatGPT、允许有限使用、无限制使用。
结果发现,完全禁用 AI 的学生表现最差。
这个结果反直觉但合理。禁用 AI 的学生失去了练习"怎么跟 AI 协作"的机会,而允许使用的学生在反复实践中学会了判断 AI 输出的质量——知道什么时候该信、什么时候该查。
这条给"要不要让学生用 AI"的争论提供了一个有数据的答案。 但更重要的是实验设计:随机分组、两年周期、真实课堂——比大多数仅凭直觉站队的文章有说服力得多。
对企业管理者也是同一个逻辑:与其纠结"该不该让员工用 AI",不如先建好使用规范和验收标准。
总结分析
把这五条放到一起看,有一条线索贯穿始终:AI 正在从"能不能用"走进"怎么管、怎么算账"。
前两条是国内的动作。工信部的方案,把"AI 时代软件怎么重做"写成了有时间表和资金配套的执行文件——2 万家企业、100 个标杆应用,说明政策不再只谈芯片和模型,开始落到软件产品和应用。
智谱的 50 亿是资金层面的回应,押注下一代会话模型和完全自训练,跟 DeepSeek 的低成本路线摆开了两条相反的路。
中间两条是全球的博弈。Altman 同意 Dario 降速,加上 Musk、Hassabis 的表态,说明"该不该慢"在头部公司已经不是问题,难的是怎么建行业协调和国际机制。
国产 GPU 加类脑芯片的异构推理,则是绕开先进制程、靠架构创新补算力缺口的一种尝试。
最后一条和前面看起来无关,但结论最朴素:禁用 AI 的学生表现最差。它提醒我们,不管讨论里怎么争,工具已经在改变每个人的做事方式。
关注数绘星河科技
每天一篇 AI 办公干货,我们教你把这些工具真正用到业务里,把 AI 变成生产力。