ARTICLE · 1006976
【OpenClaw具身硬件】ZeroClaw 源码阅读笔记(3)--- RAG
【OpenClaw具身硬件】ZeroClaw 源码阅读笔记(3)--- RAG
0x00 概要 0x01 两套RAG 1.1 关键差异 1.2 工程取舍 0x02 HardwarRag 基础 2.1 基本功能 2.2 使用原因 2.3 具体应用场景 0x03 HardwarRag 实现 3.1 流水线概览 3.2 实现类 3.3 详细流程 0xFF 参考
0x00 概要
本文是 ZeroClaw 的学习笔记。
ZeroClaw 是一个零开销、零妥协、100% Rust实现的AI助手框架,具有以下核心特点:
数字-物理桥梁:AI不仅处理数字信息,还能控制物理世界 环境感知:通过传感器获取真实环境数据 主动交互:能够主动改变物理环境状态 极致性能:优化编译配置(opt-level="z",lto="fat")生成最小二进制文件 多平台支持:支持CLI、WebGateway、桌面应用、硬件集成 模块化设计:高度可扩展的插件式架构 安全优先:内置多层安全机制和紧急停止功能
ZeroClaw 的总体如下图所示。
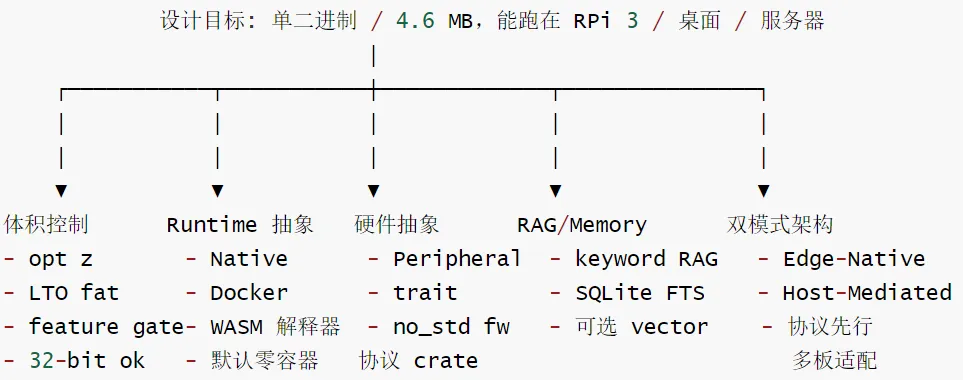
ZeroClaw项目采用RAG技术是为了解决硬件控制领域特有的精确性、安全性和易用性挑战。通过将权威的硬件数据手册与强大的LLM能力相结合,RAG实现了:
精确控制:确保每个硬件操作都基于准确的规格信息
安全保障:防止因知识错误导致的硬件损坏
用户体验:让用户能够用自然语言控制复杂的硬件系统
灵活扩展:支持无限的硬件类型和用户自定义配置
这种设计完美体现了ZeroClaw"零开销、零妥协“的核心理念,既保持了AI助手的强大能力,又确保了硬件操作的专业性和可靠性。
0x01 两套RAG
ZeroClaw项目里其实是两套独立的RAG。这两套互不调用:HardwareRag是给LLM注入硬件文档的简单流水线,Memory是ZeroClaw的“大脑"。
1.1 关键差异
1.2 工程取舍
几个值得注意的工程取舍如下:
HardwareRag 不上 embedding — 数据手册量小(几十到几百 chunk),关键词 + board 加分够用;省去启动时跑 embedding 的开销,端上启动更快 Memory 默认 Noop embedding — 让最小部署完全不依赖外部 API;用户开启 OpenAI 兼容 embedding 后才进 vector 阶段 三阶段顺序设计 — cache 命中 0 ms / FTS 命中 ms 级 / vector 才几十 ----- 几百 ms,先便宜后贵 FTS 早停门槛 当 BM25 已经很高时,跳过向量阶段省 latency 与 embedding API 调用 chunker 共用 — src/memory/chunker.rs 的 chunk_markdown 同时被 HardwareRag 和 Memory 用,512 token / 标题分段 / 段落兜底 SQLite bundled — 端上零依赖,单二进制即可分发
0x02 HardwarRag 基础
HardwareRag是一个轻量的本地RAG索引,HardwareRag是适用于外设场景的实用离线RAG层,用于把硬件datasheet(.md/.txt,带可选PDF支持)切片、解析pin别名,并基于关键字把相关片段与别名注入到agent/LLM的上下文中,能显著提高L LM在硬件控制与解释上的可靠性。
2.1 基本功能
因为大家会比较熟悉”Memory 检索管线“,因此我们本篇主要来看看 HardwarRag,其主要功能如下。
索引: 数据手册、参考手册、寄存器映射(PDF → 分块、嵌入向量)。 检索: 用户查询("打开 LED")时,获取相关片段(例如目标开发板的 GPIO 部分)。 注入: 添加到 LLM 系统提示或上下文。 结果: LLM 生成准确的、开发板特定的代码。
其特色如下:
没有向量、没有embedding、没有重排一纯关键词
文件注释显式写:"Keyword retrieval(default)or semantic search via embeddings(optional)"—但当前代码里embedding路径未实现,就是keyword 触发条件:peripherals启用 + 配置了datasheet_dir 完全本地、单进程、零网络(PDF提取除外)
2.2 使用原因
ZeroClaw项目使用RAG的核心原因是硬件知识的精确性和实时性需求。
硬件文档的复杂性
引脚映射复杂:不同开发板的GPI0引I脚功能各不相同,需要精确的引脚别名映射 寄存器配置繁琐:STM32等MCU的寄存器配置需要准确的地址和位域信息 协议规范严格:I2C、SPI等通信协议需要精确的时序和数据格式
LLM知识的局限性
训练数据滞后:LLM的训练数据可能不包含最新的硬件型号和规格 细节精度不足:通用LLM难以记住所有开发板的具体引脚定义和内存映射 版本差异问题:同一芯片系列的不同版本可能存在细微但关键的差异
硬编码方案的问题
维护困难:每新增一种硬件都需要修改代码
扩展性差:无法支持用户自定义的硬件配置
灵活性低:难以适应不同版本和变种的硬件
RAG的解决方案
实时文档检索:从本地数据手册中检索最新、最准确的硬件信息 上下文增强:将精确的硬件规格注入到LLM的上下文中 动态知识更新:用户可以随时添加新的数据手册,系统立即生效 安全可靠:基于权威数据手册确保操作的正确性
2.3 具体应用场景
常见使用场景举例
会话回答:接收到用户问题→memory_recall/content_search拉相关上下文→将top-k摘要拼入prompt→调用.llm_task生成回答。 代码辅助:检索项目相关片段/记忆→将检索到的代码片段注入到claude_code或llm_task的prompt→生成补丁或实现。 文档问答与知识图谱:FTS/bm25用于高置信关键字匹配,向量用于语义匹配;知识库(knowledge_ graph)提供结构化回溯。
比如,Arduino开发场景如下
场景描述:用户连接Arduino Uno,想要控制内置LED RAG作用:从arduino-uno.md中获取引脚13对应内置LED的信息 用户体验:用户只需说“打开LED 13 引脚",系统自动处理引脚映射
具体数据流如下:
用户输入:"打开LED 13 引脚" 别名检索:从arduino-uno.md中检索"red_1ed"对应的引脚13 上下文注入:将引脚信息注入到LLM的系统提示中 代码生成:LLM生成针对引脚13的GPI0控制代码 安全验证:验证引脚13确实是输出引脚且安全可用
0x03 HardwarRag 实现
HardwarRag 实际功能是文档检索:RAG(检索增强生成)流水线,将数据手册片段、寄存器映射和引脚定义输入到 LLM 上下文。
3.1 流水线概览
RAG数据流如下:数据手册→别名解析→索引构建→用户输入 →上下文注入→LLM增强→精确控制。
即,把该外设的datasheet放入配置的datasheet目录→agent加载形成HardwareRag→ 用户/流程询问“如何接线/控制X外设”时,agent用RAG拉取相关片段并构造prompt→调用代码生工具→产生代码补丁/脚本→(可选)通过写入/执行工具应用并运行。
数据流向概览如下:
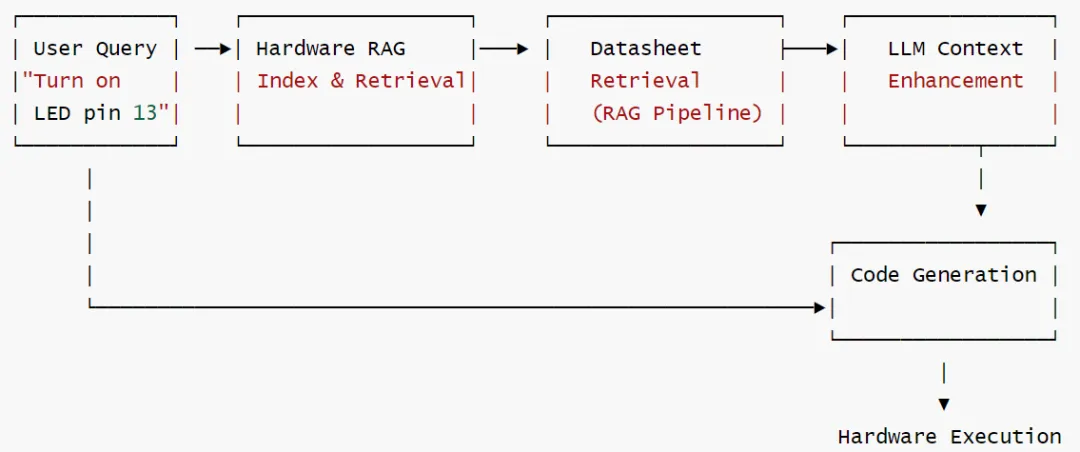
我们再进一步可以展开为两阶段:入库 和 检索。
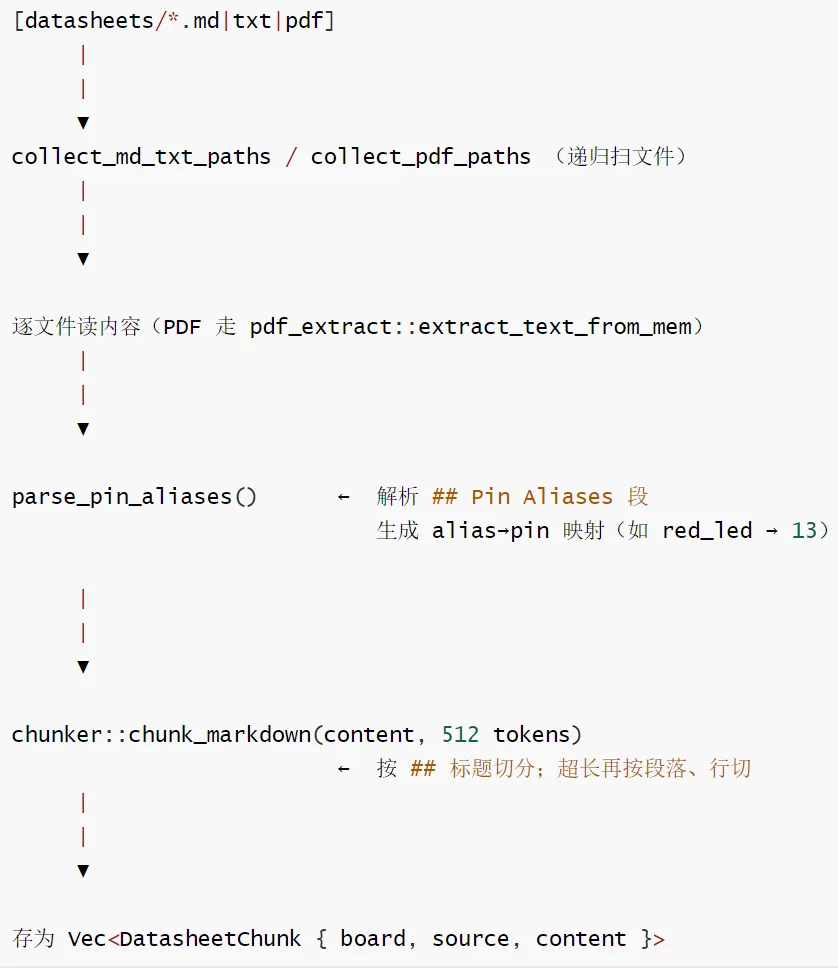
3.1.1 入库流程
入库流程(启动时一次完成,全在内存)
3.1.2 检索流程
检索流程(每次用户消息一次)的总体流程如下,此处涵盖了上下文注入阶段。
用户消息 + 配置的 boards 列表 + chunk_limit||▼引脚别名注入rag.pin_alias_context(query, boards)→ 词法匹配 "red led" → "red_led: 13"||▼关键词检索rag.retrieve(query, boards, limit)- 把 query 拆成 token(去掉 ≤2 字符)- 对每个 chunk:每命中一个 token +1 分;chunk.board ∈ boards 再 +2 分- 排序 → 截断 limit||▼拼接 prompt 上下文"[Pin aliases for query]\n...""+ "[Hardware documentation]\n--- src (board) ---\n""||▼注入到下一次 LLM 调用的 system/user prompt
3.1.3 新增外设流程
在前两个阶段基础上,我们推断出,如果新接了一个外设之后,ZeroClaw会把PDF/MD型datasheet转为可检索片段(HardwareRag),并把这些片段注入LLM上下文;再由生成工具(例如claude_code/llm_task/codex_cli)根据上下文生成驱动/控制代码,最终写入或执行需要额外的写入/执行流程与安全批准。
关键实现点如下:
读取与索引:HardwareRag::load会扫描datasheet目录并切片/解析(支持PDF需开启rag-pdf)。 上下文注入:agent在生成调用前通过build_hardware_context把pin-alias与检索到的片段入prompt。 生成与执行链:生成代码由工具负责(示例:claude_code/claude_code_runner/llm_task odex_cli),生成后可通过file_write/file_edit写入并用shell执行(或在tmux runner中交互)。
3.2 实现类
HardwareRag 是具体实现类。
/// Hardware RAG index — loads and retrieves datasheet chunks.pub struct HardwareRag {chunks: Vec<DatasheetChunk>,/// Per-board pin aliases (board -> alias -> pin).pin_aliases: HashMap<String, PinAliases>,}
公开接口(主要方法/结构):
DatasheetChunk: 包含 board:Option ,source: String,content:String。 HardwareRag::load(workspace_dir,datasheet_dir):扫描dir,读取文件(可选PDF),解析别名,ch unk文档并建立索引。 HardwareRag::pin_aliases_for_board(board):返回某板的别名映射。 HardwareRag::pin_alias_context(query,boards):当查询匹配别名时,生成类似 [Pin aliases for q uery]\nboard:alias=pin"的上下文文本片段。 HardwareRag::retrieve(query,boards,limit):按关键字检索并返回最相关的 DatasheetChunk引用。 len()/is_empty():索引元信息。
关键组件与流程
文档切分与摄取:chunker.rs与各类memory后端的写入路径(memory::sqlite、memory::qdrant、memory::postgres、memory::markdown)负责把文本/文件分片并入库(支持PDF文本提取,见file_r ead.rs的PDF支持) 向量化(Embeddings):embeddings.rs定义EmbeddingProvider,支持openai/openrouter/ custom;配置可通过[memory]与embedding_routes路由覆盖(见memory::resolve_embedding_config 存储层(Vectors+FTS):可选后端包括SqliteMemory(FTS5+向量融合)、QdrantMemory(外部向量DB)、以及Postgres(pgvector)(见qdrant.rs、sqlite.rs、knowledge_graph_pg.rs) 多阶段检索管道:retrieval.rs实现RetrievalPipeline(默认stages:cache>fts→vector>),支持hot cache、FTS 早返回值(fts_early_return_score)与hybrid(tuning via vector_weigh t/keyword_weight). 检索接口/工具:memory_recall.rs、content_search.rs、knowledge_tool.rs等工具暴露检索能力给agent/LLM;工具返回带score的条目并可应用时间/limit/namespace过滤。 生成与注入:检索结果被注入到LLM提示或llm_task/claude_code的上下文中,形成RAG:检索 (符号/语义)>拼接提示>模型生成响应或代码。
数据摄取与解析细节:
文件收集:递归收集.md/.txt(与rag-pdf feature下的.pdf) 1.3.2切片:使用chunker::chunk_markdown(. ,max_tokens=512)将长文切成可注入片段。 Pin别名解析:parse_pin_aliases 支持两种格式—alias:pin/ alias=pin 和 Markdown 表格行(alias丨pin);结果规范化为小写并以 板卡识别:infer_board_from_path 以文件 stem作为 board,并处理generic命名约定。
检索算法(实现与评分):
关键字检索:把查询拆词(丢弃短词len<=2),对每个chunk的小写内容做字符串contains> 检测,score=匹配词数。 板卡偏好加权:若chunk 的 board在请求的boards列表中,额外+2分。 排序与截断:按分降序排序、截断到1imit并返回chunk引l用(不返回显式score元数据)
在agent中的使用点:
build_hardware_context会调用pin_alias_context 与 retrieve,把pin-alias+datasheet片段拼成一个额外上下文注入到LLM提示中,用于把自然语言映射为硬件命令/解释> 配置/加载:agent启动时可从配置指定datasheet目录并调用HardwareRag::load;onboard向> 导提示与datasheet配置相关选项。
配置点(在哪里控制RAG行为)
[memory]: backend, retrieval_stages, embedding_provider, embedding_model, vector_weight/keyword_weight,embedding_dimensions,fts_early_return_score 等。 embedding_routes:按hint路由到不同embedding 提供商与模型(见memory::resolve_embeddi ng_config) 后端专有设置:[memory.qdrant](URL、collection、API key)、[memory.postgres](pgvector)等。
3.3 详细流程
详细逻辑流程如下。
3.3.1 添加数据手册(RAG)
数据来源
配置项datasheet_dir(如datasheets/) -文件类型:.md、.txt、可选.pdf(feature rag-pdf,靠pdf-extract) -文件名=board tag(nucleo-f401re.md →board nucleo-f401re) generic/子目录或generic.md→不绑定board
因此,如果要添加数据,我们可以将 .md 或 .txt 文件放入 docs/datasheets/(或你的 datasheet_dir)。按开发板命名文件:nucleo-f401re.md、arduino-uno.md。
引脚别名(推荐)
添加 ## Pin Aliases 部分,以便代理可以将"红色 LED"映射到引脚 13:
# 我的开发板## 引脚别名| 别名 | 引脚 ||-------------|-----|| red_led | 13 || builtin_led | 13 || user_led | 5 |
或使用键值格式:
## 引脚别名red_led: 13builtin_led: 13
PDF 数据手册
使用 rag-pdf 特性时,ZeroClaw 可以索引 PDF 文件:
cargo build --features hardware,rag-pdf将 PDF 放入数据手册目录。它们会被提取和分块用于 RAG(检索增强生成)。
3.3.2 初始化阶段 (Indexing Phase)
数据源加载
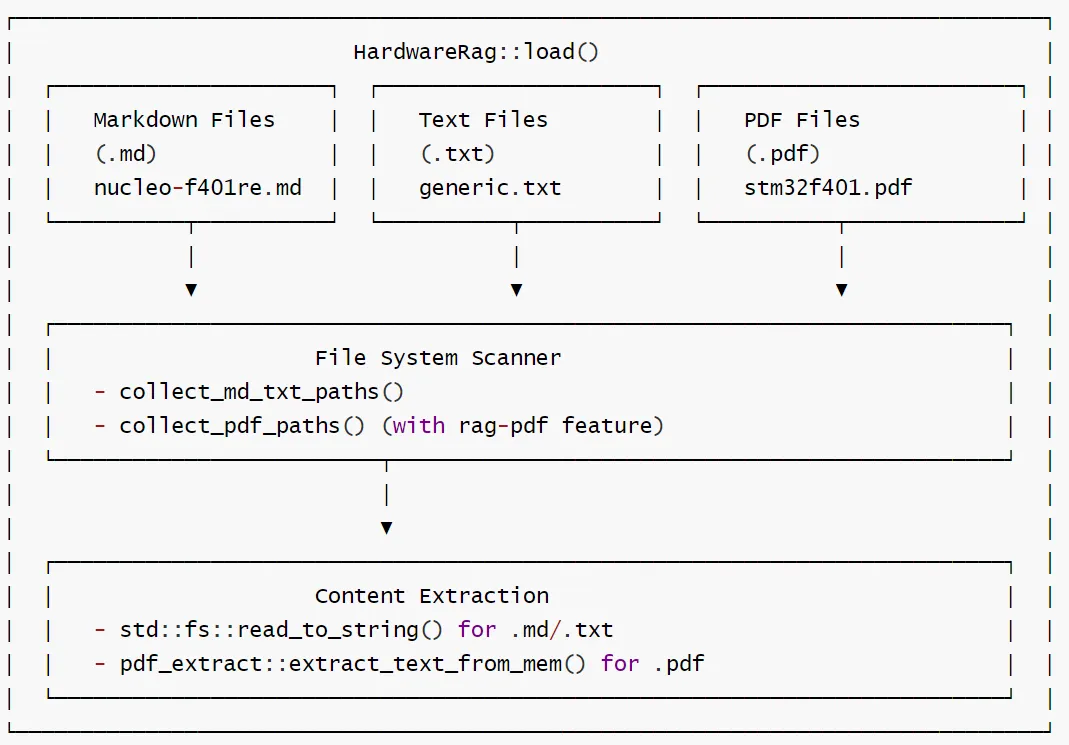
数据流向概览
数据源类型
| Markdown Files | ||
| Text Files | ||
| PDF Files |
File System Scanner 方法
collect_md_txt_paths() | |
collect_pdf_paths() |
Content Extraction 方法
std::fs::read_to_string() | |
pdf_extract::extract_text_from_mem() |
引脚别名解析
parse_pin_aliases() 函数完成了引脚别名解析。
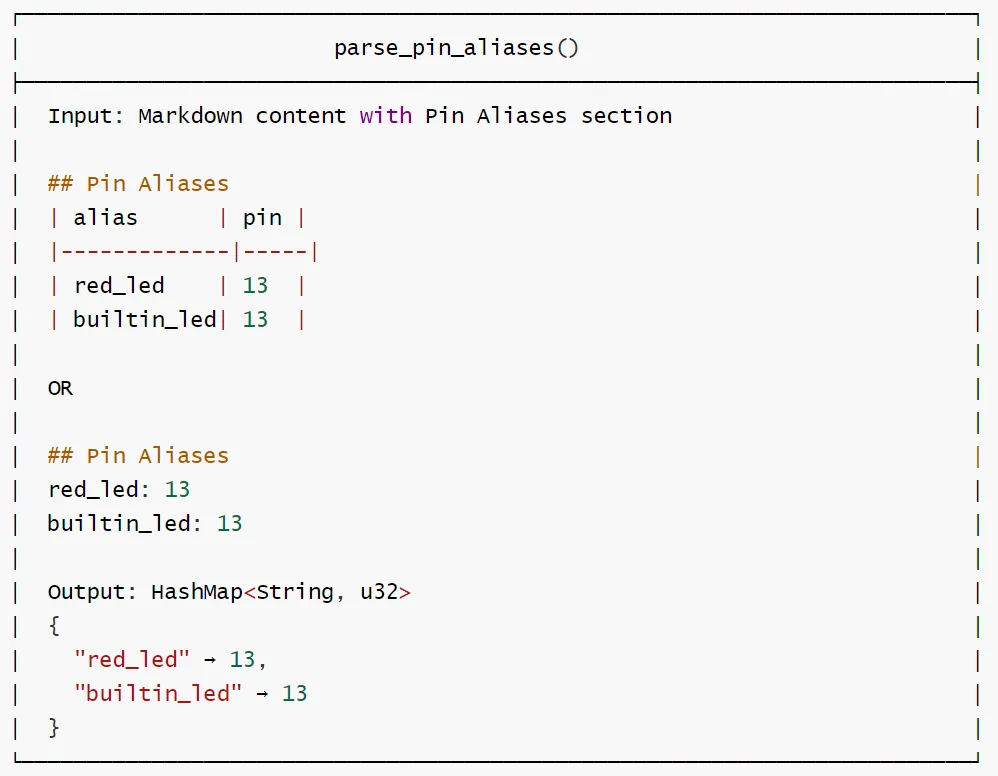
输入格式
| Markdown Table | | red_led \| 13 \| | |
| Key-Value | red_led: 13 |
输出格式
| HashMap | "red_led" → 13 |
"builtin_led" → 13 |
引脚别名映射
功能说明
parse_pin_aliases() 函数用于解析 Markdown 文档中的 Pin Aliases 部分,支持两种格式:
Markdown 表格格式 - 标准的管道符表格 键值对格式 - alias: pin的简单文本格式
输出为一个 HashMap,将别名字符串映射到引脚编号(u32 类型)。
文档分块处理
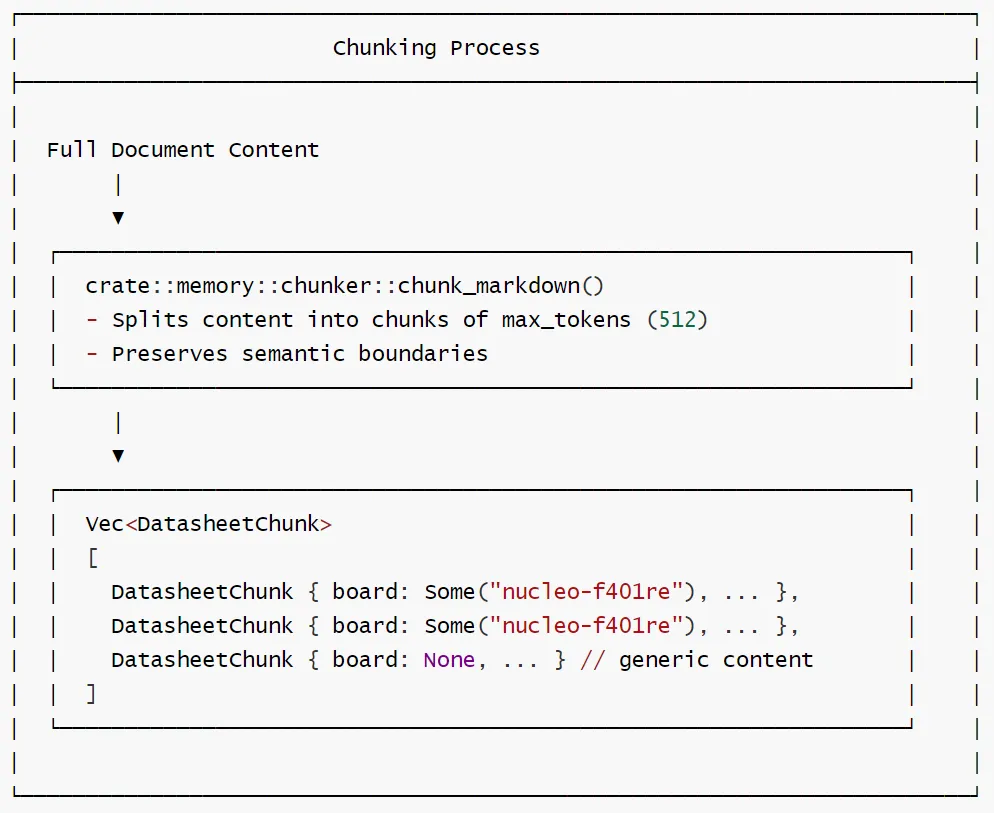
分块流程
chunk_markdown() | ||
Vec |
DatasheetChunk 结构
board: Some("nucleo-f401re") | |
board: None |
分块特点
| max_tokens | |
| 语义边界保留 | |
| 板卡关联 |
3.3.3 查询处理阶段
引脚别名上下文生成
pin_alias_context() 函数
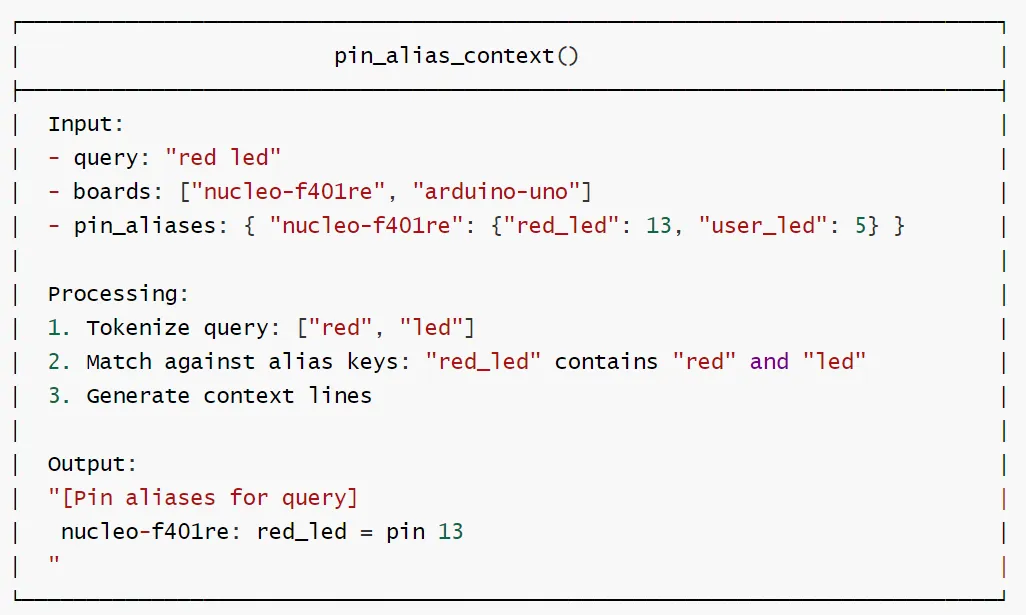
输入参数
| query | ||
| boards | ||
| pin_aliases |
处理流程
输出格式
[Pin aliases for query]nucleo-f401re: red_led = pin 13
匹配逻辑
文档片段检索
retrieve() 函数
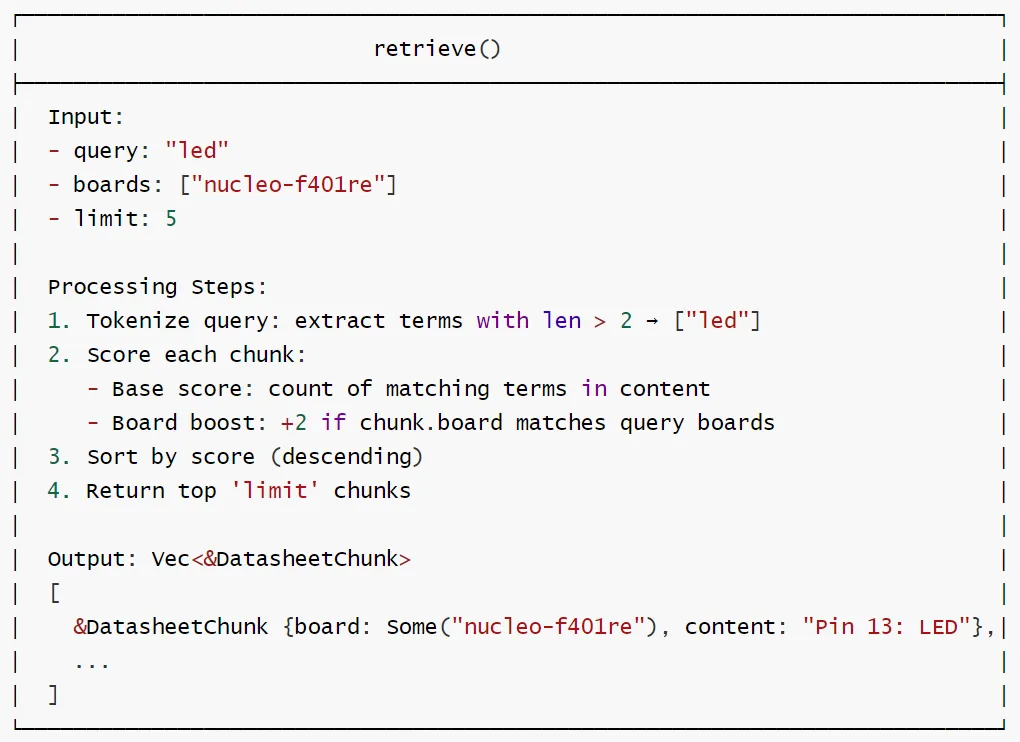
输入参数
| query | ||
| boards | ||
| limit |
处理步骤
输出格式
| Vec<&DatasheetChunk> | |
board: Some("nucleo-f401re") | |
content: "Pin 13: LED" |
评分机制
| Base score | |
| Board boost |
示例匹配
3.3.4 上下文注入阶段
系统提示构建
Agent Loop Integration 中,会调用load_hardware_context_prompt()来插入硬件信息。
完整流程
hardware::boot() ──→ load_hardware_context_prompt() ──→ Final System Prompt│ │ │▼ ▼ ▼Loads HardwareRag Reads HARDWARE.md [Pin aliases]Retrieves aliases Reads devices/<alias>.md [Hardware docs]Reads skills/*.md
展开如下:
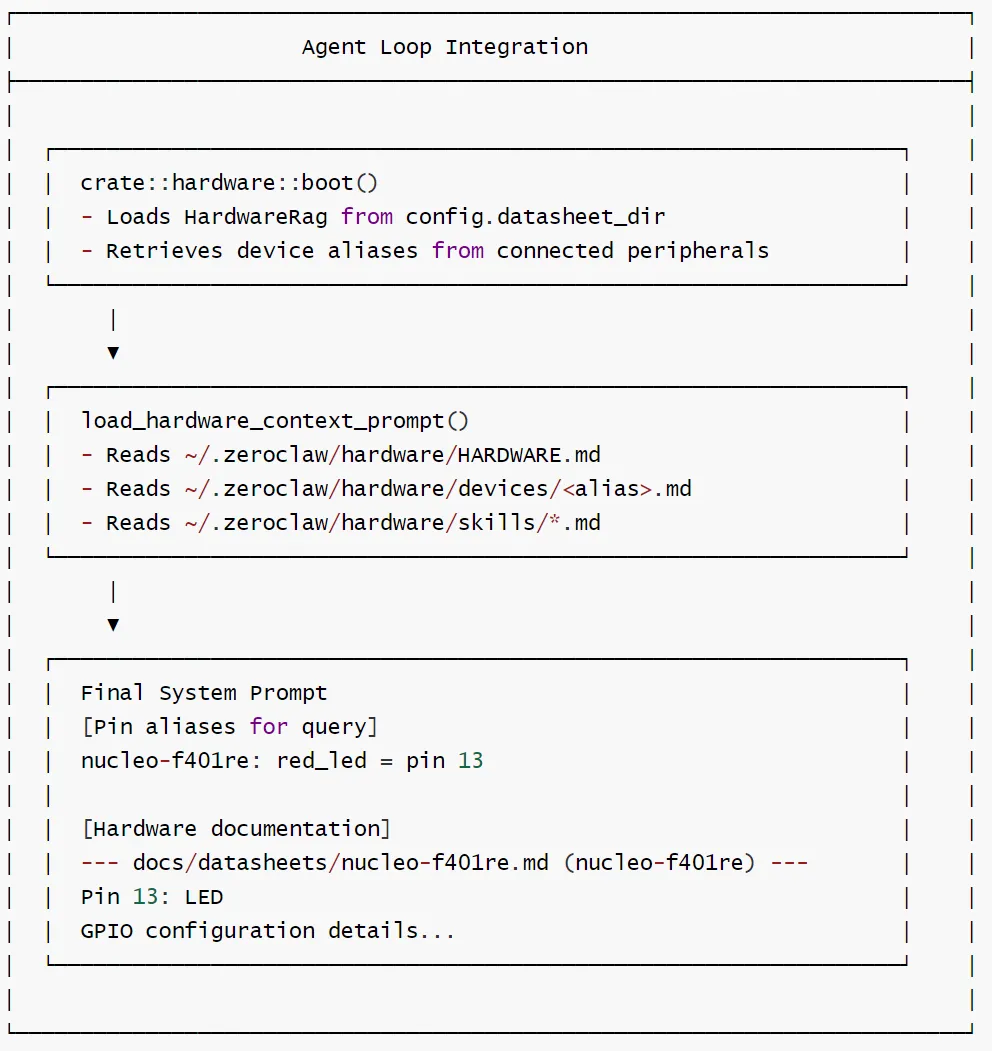
启动流程
crate::hardware::boot() | ||
load_hardware_context_prompt() | ||
加载的文件
~/.zeroclaw/hardware/HARDWARE.md | |
~/.zeroclaw/hardware/devices/.md | |
~/.zeroclaw/hardware/skills/*.md |
Final System Prompt 结构
| [Pin aliases for query] | nucleo-f401re: red_led = pin 13 |
| [Hardware documentation] | docs/datasheets/nucleo-f401re.md |
Pin 13: LED | |
GPIO configuration details... |
动态上下文更新
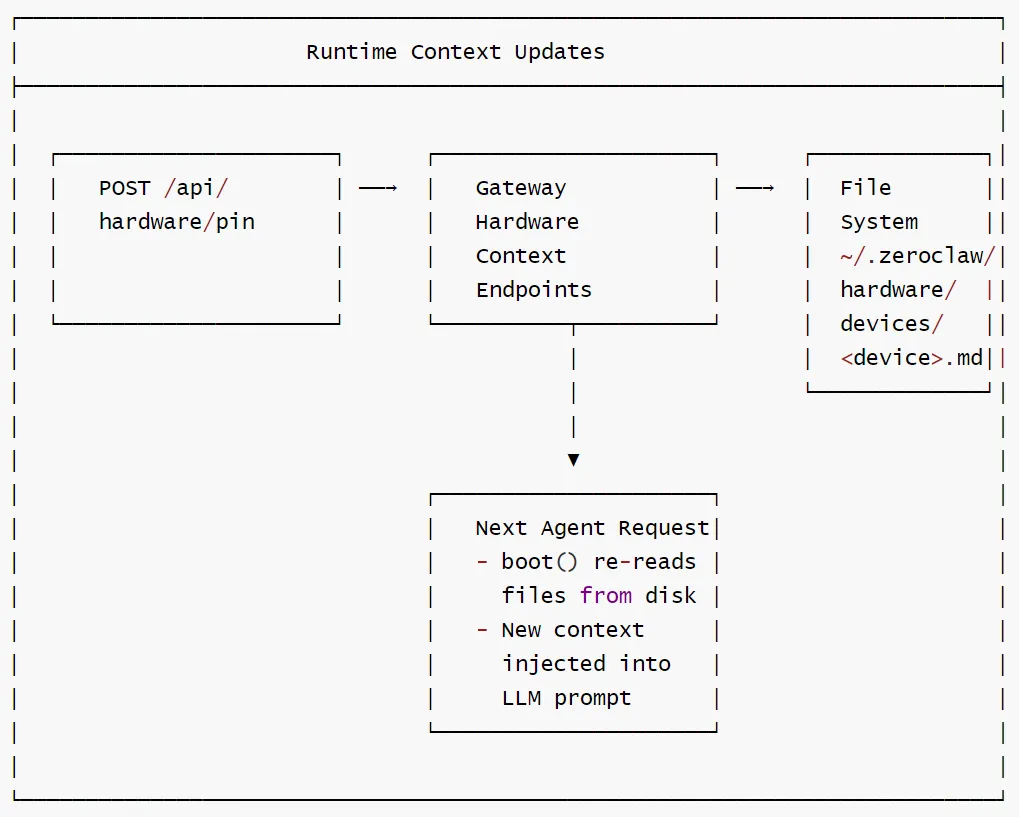
运行时上下文更新流程
~/.zeroclaw/hardware/devices/.md | ||
数据流向
POST /api/hardware/pin ──→ Gateway Hardware Context Endpoints ──→ File System│▼Next Agent Request(boot() re-reads + context injection)
关键操作
| API 调用 | |
| 文件更新 | |
| 上下文刷新 | |
| 提示注入 |
完整端到端的用户交互流程
完整数据流如下
User Query ──→ Agent (识别硬件) ──→ HardwareRag (处理)│▼Context Injection ──→ LLM (生成代码) ──→ Tool Execution ──→ Response
展开如下:
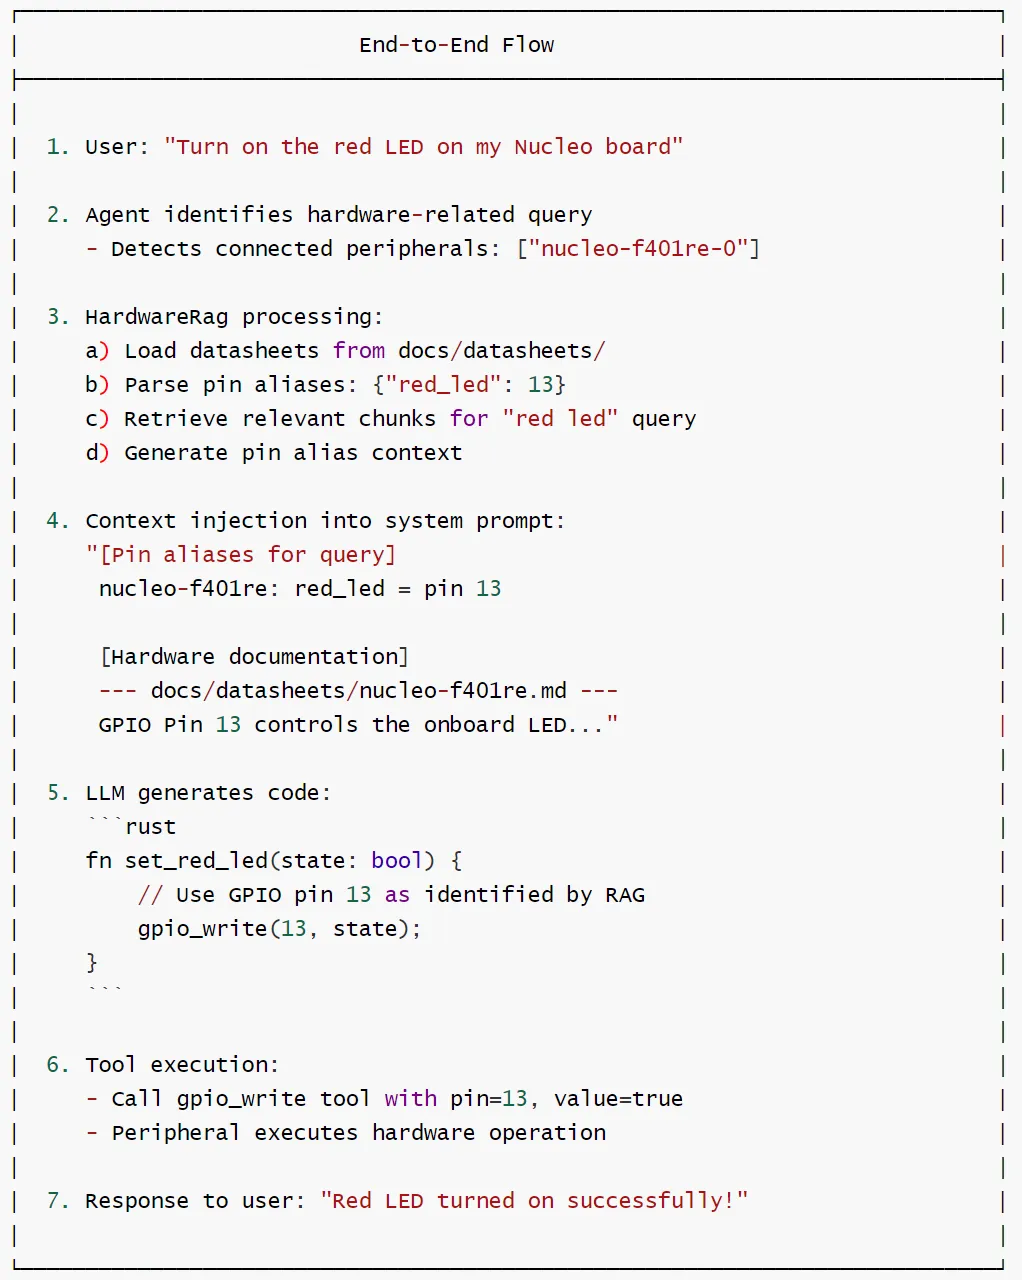
端到端流程步骤
| 1 | ||
| 2 | ||
| 3 | ||
| 4 | ||
| 5 | gpio_write(13, state) 代码 | |
| 6 | ||
| 7 |
关键数据
set_red_led(state: bool) | |
gpio_write(13, true) |