ARTICLE · 1006996
几十 GB 数据 Excel 打不开?这个开源工具秒开
REVIEW · DATA TOOL
OPEN SOURCE
几十 GB 数据 Excel 打不开?这个开源工具秒开
📖 阅读 5 分钟
🏷 分类 开源工具
🛠 工具 Dataset Viewer
// INTRO
双击 CSV 转圈半小时、内存直接爆炸——你缺的不是更大的电脑,是一个只看不分析的工具。
本文导航
100GB 秒开的三个机制
ZIP 直读 + 毫秒搜索
AI 自己写的项目彩蛋
01
为看一眼数据,值得写一坨 Python 吗
THE PROBLEM
先还原一个场景。你拿到一个几十 GB 的 CSV 或者 Parquet,第一反应是双击打开看看里面长什么样——然后 Excel 开始转圈,半小时后弹出未响应,运气差一点直接闪退。
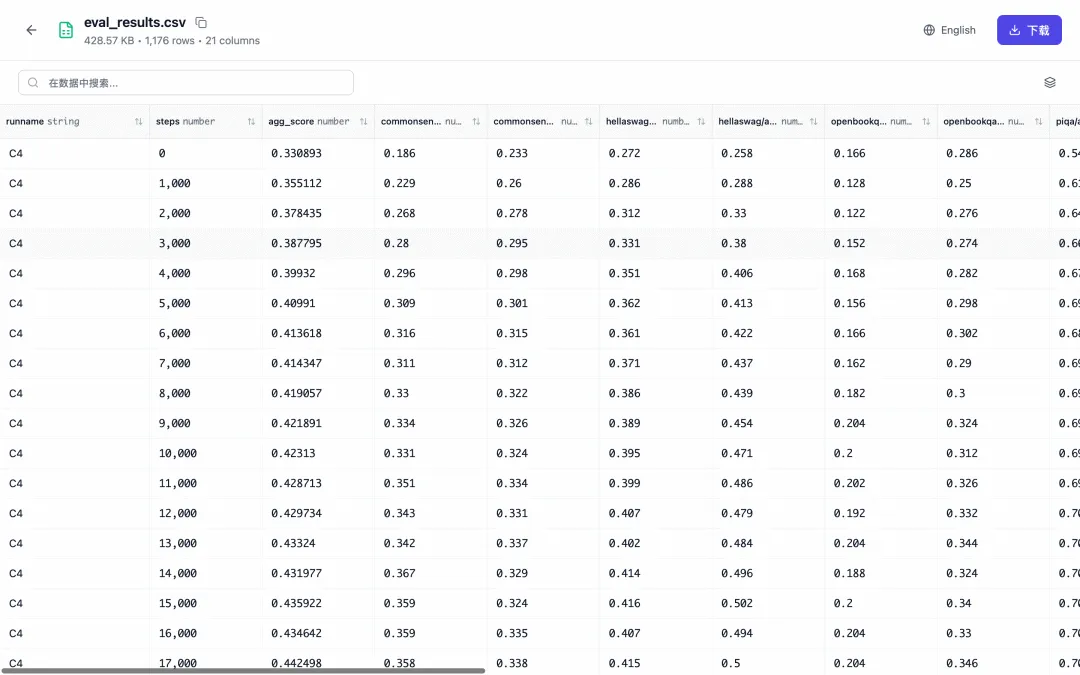
Excel 不是不给力,是它天生有边界:单表 104 万行封顶,再往上就是那个灰色按钮。几 GB 的文件它尚且吃力,几十 GB 更是想都别想。
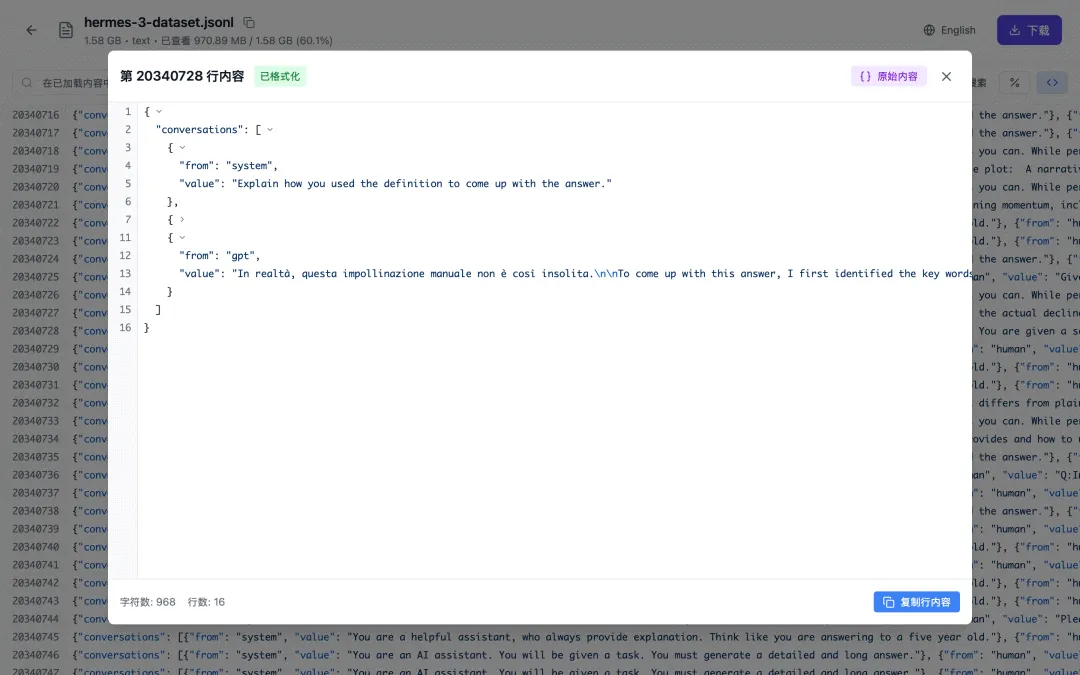
换 Python?读文件要写代码,大文件还得掂量内存够不够,pandas 读个几 GB 就敢给你 OOM。可你只是想看一眼数据长什么样,看看有哪些列、多少行、大概什么量级。
这种杀鸡用牛刀的憋屈,干数据的都懂。
最近 GitHub 上有个开源项目火起来,就是专门治这个的:Dataset Viewer。一句话概括——把看一眼大文件这件事,做到秒级。
NOTE
Excel 有 104 万行的天花板,数据没有。
02
它的定位很刁:只做"看"
POSITION
Dataset Viewer 没有把自己做成 pandas 的替代品,不做复杂聚合,不做画图。它只干一件事:让你极快地浏览和检索超大文件。
这个定位我觉得很聪明。处理数据的完整链条里,先搞清楚数据长什么样是最高频、也最不该耗时的环节。过去这步要么被 Excel 卡死,要么被 Python 脚本拖慢。
它把这一步单独拎出来优化,做成了跨平台桌面应用,Windows、macOS、Linux 通吃,安装包不到 20MB。
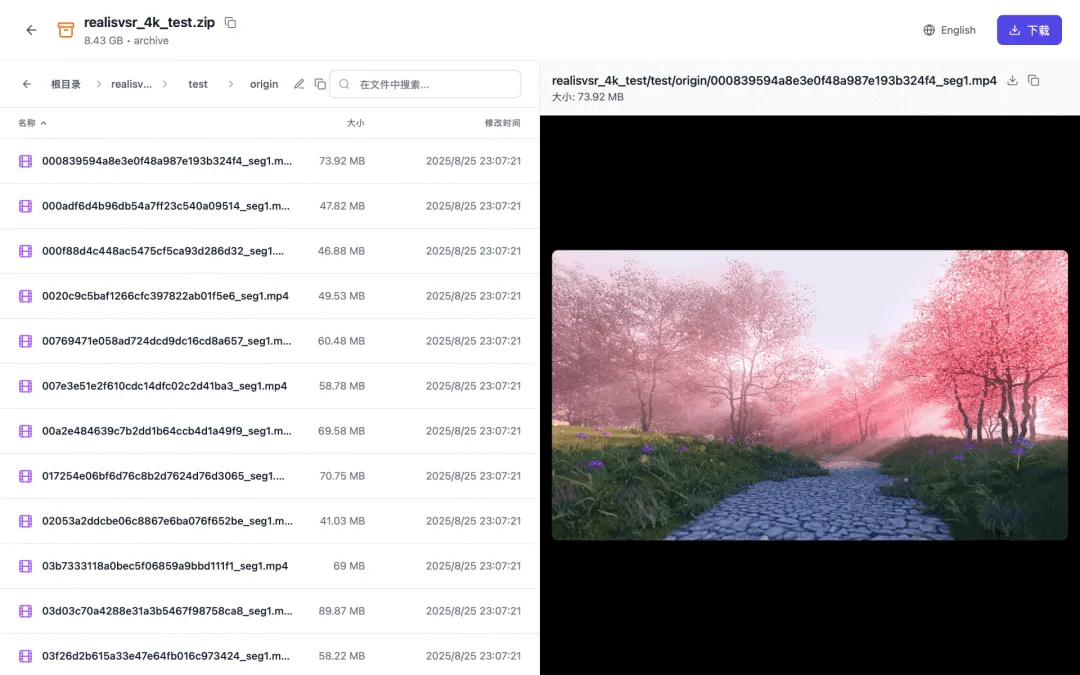
往大里说,这也是个正在出现的新品类。数据文件越来越大,Parquet 成了主流存储格式,HuggingFace 上的数据集动辄几十 GB——过去编辑器顺手打开的路径全断了,专门干看的轻量工具自然有了市场。Dataset Viewer 算是踩在这个点上。
底层是 Tauri(Rust)+ React,MIT 协议开源。GitHub 直接下 Release 装完就能用。
03
100GB 秒开,靠的是"只画看得见的"
HOW IT WORKS
很多人会怀疑:100GB 的文件,怎么可能秒开?
答案是它压根没把整个文件读进内存。三个关键机制:
· 虚拟化渲染:表格只渲染你屏幕上看得见的几十行,滚到哪算到哪,百万行滑动和看小文件一样跟手。这技术你其实见过——浏览器里的无限滚动列表就是同一招
· 分块加载:按需从磁盘读数据块,不一次性加载全部
· 流式处理:大文件分段传输,内存占用被压在很低水平
这就是为什么它敢写 Handle 100GB+ files。传统工具是全量读入再显示,它是边看边读,架构上就不是一个思路。
它不是分析器,是把"看一眼"做到极致的查看器。
04
ZIP 不解压直读,搜索毫秒级定位
FEATURES
两个使用体验上很惊艳的点。
第一是压缩包直读。ZIP、TAR 扔进去,直接在应用里流式浏览,不用解压、不占临时空间。下载了几十 GB 的数据包只想确认里面是什么,以前得先解压等半天,现在点开即看。
第二是毫秒级搜索。大文件里搜关键词,实时定位、结果高亮,百万行里找一条记录,比在聊天记录里翻还快。翻日志再也不用 grep 半天再拖进编辑器了。
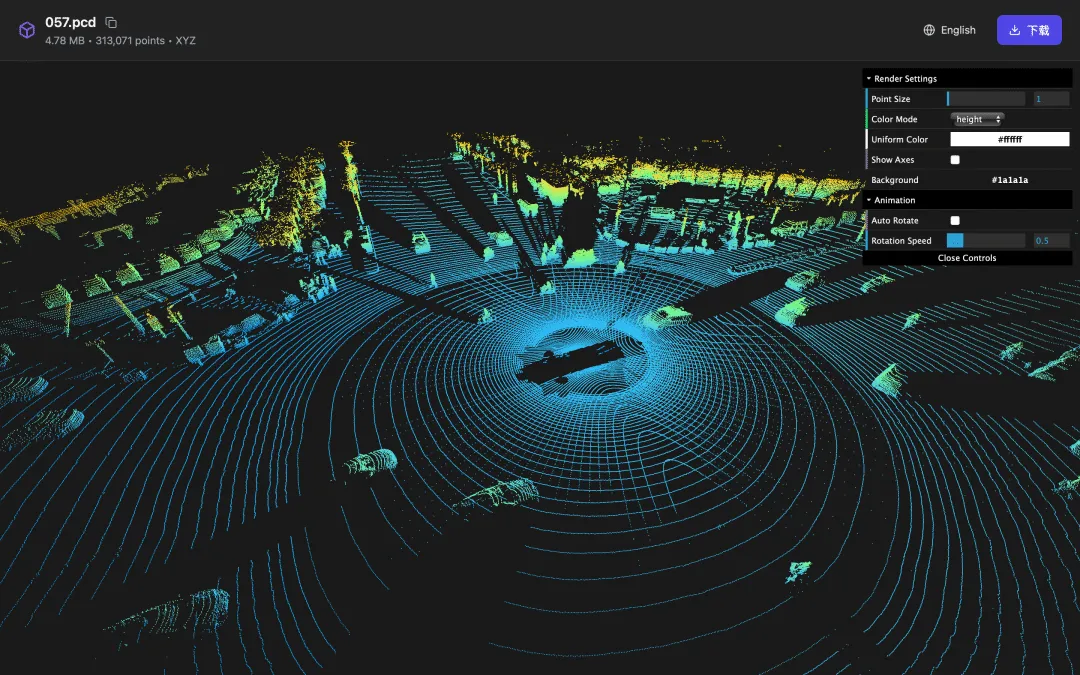
格式支持也全:Parquet 做了专门优化,Excel、CSV、ODS 能虚拟滚动,JSON/YAML 结构化展示、代码文件语法高亮,Markdown、Word、PPT、PDF 都能预览,连图片视频音频也能直接看。
甚至还有 3D 点云查看器这种偏门功能。
说实话,命令行党到这里可能会说:qsv、VisiData也能干这些。确实能,而且很强大。
但 Dataset Viewer 的价值是零学习成本——不用记命令、不用配环境,双击打开就能操作。给团队里不熟命令行的同事用,尤其省心。
05
除了本地,还能接 HuggingFace 和云
DATA SOURCES
它不只能开本机文件,还支持连多种数据源:
· WebDAV、SSH/SFTP、SMB/CIFS 服务器
· S3、OSS 这类云存储
· HuggingFace Hub 数据集
也就是说,远程服务器上的大文件、HuggingFace 上那些动不动几十 GB 的数据集,也能流式浏览,不用先下载到本地。这对经常捣鼓开源数据集的人来说是刚需。
NOTE
数据不一定要下载才能看,能流式看就不占本地。
06
一个彩蛋:这项目是 AI 自己写的
FUN FACT
最后说个有意思的细节。
项目 README 里白纸黑字写着:整个代码库由 AI 辅助生成(100% AI-Generated)。TypeScript 约占七成、Rust 约占三成,一个 AI Agent 从零搭出了这个性能导向的桌面应用。
这事本身挺有信号意义:AI 生成的不只是聊天回复和营销文案,已经开始产出能扛 100GB 文件的工程级工具了。
当然,AI 写代码不代表没有坑——遇到异常行为别太惊讶,复杂场景建议先小范围验证。
∞
说点老实话,谁适合装
WHO NEEDS IT
工具很好,但也要看人。
· 强烈建议装:天天被大 CSV 折磨的数据分析师;要翻超大日志但不想写脚本的运维;经常下载几十 GB 数据集、却只想先看一眼内容的研究者
· 不建议装:如果你要的是透视、统计、画图这类深度分析,它给不了——它是查看器,不是分析器。真要做分析,数据量小用 Excel,数据量大用 DuckDB 或者正经写 pandas,各有各的场子
另外提一句,这类秒开大文件的体验上限,最终还是看磁盘速度。机械硬盘上的 100GB 文件,任何工具都救不了,SSD 才是前提。
你手上有没有那种打开就转圈的大文件?评论区说说你平时都怎么处理。
• • •
✓ KEY TAKEAWAYS
要点一:虚拟化渲染 + 分块加载 + 流式,100GB 文件也能秒开。
要点二:ZIP/TAR 不解压直读,搜索毫秒级定位,支持多数据源。
要点三:它是查看器不是分析器;AI 生成的代码库,坑要自己验证。
如果这篇文章对你有帮助
欢迎点赞、在看、转发分享
聊点源码