ARTICLE · 1007305
两个00后,让30万名专家给AI打工,18个月估值200亿
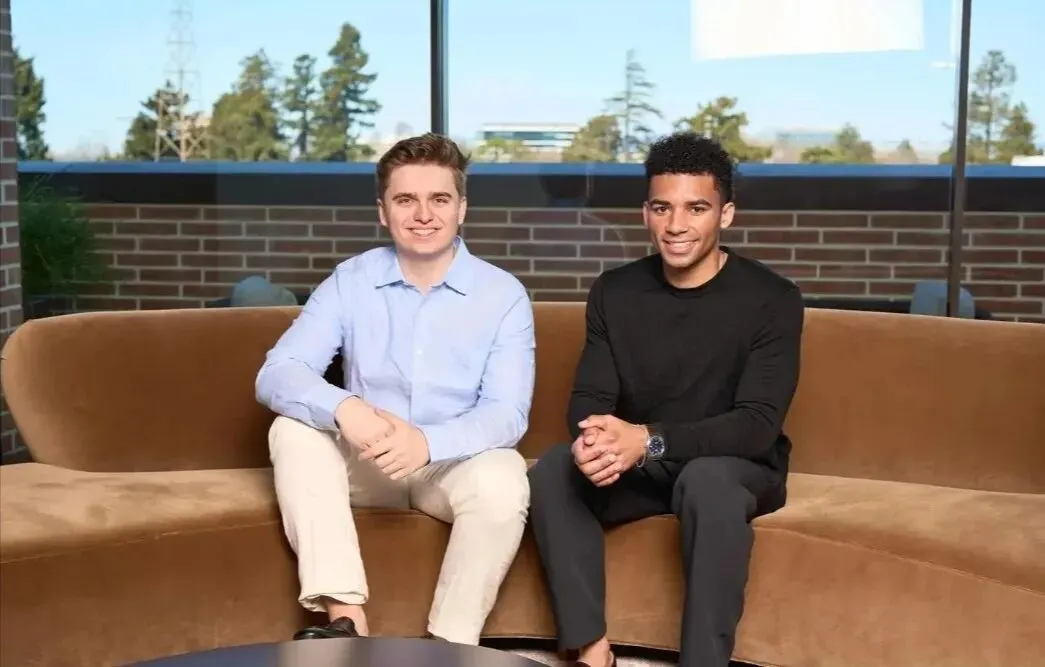
2024年11月,Y Combinator 2025年冬季批次申请即将截止。Carlos Georgescu和Spencer Mateega用48小时赶出了一份申请。没有产品,甚至没想清楚要做什么。唯一确定的是去旧金山,赶上正在爆发的AI创业潮。
如今,他们创办的AfterQuery估值已经达到32亿美元(约215亿元人民币),较五个月前的3亿美元增长超过10倍。从成立到成为独角兽,仅用了18个月,创下YC纪录;公司经常性收入已达到数亿美元规模,并与多家顶尖AI实验室和科技公司开展合作,公开合作方包括英伟达、Legora以及韩国AI实验室Motif Technologies等。
而两位创始人,如今一个22岁,一个23岁。
怎么做到的?
▼
01
纯数字世界的Agent做不下去了
Mateega和Georgescu高中时相识于Google举办的计算机科学夏令营。Mateega后来进入宾夕法尼亚大学,学习金融与计算机,做过Morgan Stanley科技投行和Silver Lake科技方向的私募股权。Georgescu就读于加拿大不列颠哥伦比亚大学(UBC)计算机专业,曾两度在美国头部做市公司Citadel Securities实习。两人也都在Meta做过软件工程实习。
2025年YC冬季项目申请截止前,两人花48小时赶出申请。没有产品,也没有明确方向。他们只有一个判断:AI机会正在旧金山爆发,先过去,再决定做什么。YC真把他们录取了。
2025年2月, AfterQuery正式成立。进入YC后,他们首先选择最熟悉的金融领域,想做一个能替代部分白领工作的AI智能体。很快发现做不下去。
大模型会回答金融考试题,但不会像一个分析师那样真正工作。分析师建一个估值模型,过程是:找数据,判断哪些数据可信,整理表格,选择假设,建模,检查公式,发现异常,修改,输出结论。很多步骤没有标准答案,模型缺的恰恰是这些经验。
两人由此得出一个关键判断:AI应用层的瓶颈,不在模型架构,在模型根本没有见过足够多"优秀专业人士真正工作的过程"。
02
30万名专家,给AI"上班"
AfterQuery到底在做什么?简单来讲,就是把人类专家的工作过程,变成AI可以学习的数据。
过去几年,大模型快速进步主要靠三样东西:更多算力、更大的模型和更多数据。数据主要来自书籍、网站、论文、代码库和社交媒体。这些公开内容让模型掌握了大量知识,但高质量公开数据正在见底。
与此同时,AI的目标在变。用户不再满足于让AI写文章、答问题,模型开始进入编程、法律、金融、办公软件等真实工作环境,任务从“给出一个答案”变成“完成一件事情”。这对训练数据提出了更高的要求。
一个顶级并购律师为什么看到合同后第一眼就注意到某个条款?一个资深工程师为什么还没跑程序就判断这种架构扩展到一定规模会出问题?一个PE投资人为什么在几十页Excel里只重点检查那几个数字?一个医生为什么看到某种影像之后,会优先排除某一种疾病?
这些能力来自经验。AfterQuery称之为"隐性知识",它们存在于敲击键盘之间、诊断之前的停顿和开发者关于架构的直觉里。要让AI在专业工作上继续进步,就得把这些判断方式、决策过程和操作步骤转化成机器可以学习的形式。
为此,AfterQuery建立了一张庞大的专家网络。其官网显示目前平台连接了超过30万名经过验证的专业人士,而五个月前Series A公告时,这个数字还是近10万。
专家覆盖医疗、法律、金融和工程等领域,多以远程合同制或按项目方式合作。从公开招聘看,普通数据标注岗位时薪约25至60美元,法律专家和部分机器学习专家可达每小时200美元。
03
交付给客户的是验证过的数据
如果仅仅是找大量专家接任务,Mercor也能做。Mateega在接受Forbes采访时说,AfterQuery与Mercor的区别之一,是后者更多依赖大规模合同工和AI筛选面试,而AfterQuery的核心是自己开发定制软件系统,对人工生成的训练数据进行验证。
具体来说,有两个关键步骤。
AfterQuery会把任务控制在模型能力的边界附近。太简单,模型已经会了,训练价值有限;太难,模型完全做不了,也很难形成有效的学习信号。最有价值的数据落在两者之间:模型目前做不好,但经过训练能够提高。这和过去"数据越多越好"的逻辑不同,以前比谁有更多数据,现在比哪一条数据能带来最大的能力提升。
在此基础上,AfterQuery的研究团队还会建立后训练流程,用针对性数据继续训练模型,包括法律合同、金融建模、编程任务等,然后测试基准评测有没有提升,以此证明数据质量。
不把数据交给客户后才让客户自己验证,交付前自己先跑出结果。这解决了AI实验室买数据时最现实的一个问题:一批数据值多少钱,靠人工检查很难判断,最有说服力的指标是训练之后模型能力提升了多少。
英伟达提供了一个公开案例。在训练Nemotron 3 Ultra时,英伟达使用了AfterQuery的办公智能体训练数据集。这些任务包含文件分析、多步骤推理和专业成果制作,与OpenAI发布的GDPval评测(衡量AI完成真实办公场景中多步骤专业任务的能力)结构相近。
英伟达公开的消融实验显示,加入这批数据进行预热训练后,GDPval成绩从35.3提高到46.7,提升11.4分。AfterQuery也是Nemotron 3 Ultra技术报告中唯一点名的数据供应商。
04
从训练AI,到直接进入企业
模型能力提高之后,还有最后一道门槛:企业怎么真正用起来。
AfterQuery已经把业务延伸到前线部署工程(FDE)。工程师直接进入客户的业务一线,把AI接入企业自己的数据和工作流程。
它与TMT精品投行Raine Group合作, Raine长期积累了大量交易材料,但分散在历史PPT、财务模型、备忘录和各种内部文件里,员工找类似交易案例时需要在不同资料中反复翻找。
AfterQuery先花数周与Raine的银行家交流,梳理他们寻找和使用历史交易材料的流程。随后,前线部署团队进入Raine位于纽约中城的办公室,和银行家并肩工作了三天,搭建出Raine Search,将历史交易材料解析、分类并建立语义索引。银行家可以用自然语言查找过去的交易案例,系统按照Raine自己定义的标准,比如交易类型、行业、资产类别、交易阶段等组织检索结果。
这套方法背后有一条原则:先数据,后智能体。
AfterQuery认为,企业AI落地首先要理解一家公司的数据、模板、历史案例和实际工作流程,再决定AI应该完成什么任务。内部知识散落在不同系统里的时候,模型再强也很难稳定完成工作。
先帮模型学会专业人士怎么工作,再帮企业把这种能力接进日常业务。AfterQuery正在从AI实验室的数据供应商,成为企业AI的基础设施。
05
如何与Scale AI、Mercor、
Surge AI竞争?
AfterQuery目前面临的风险同样清晰。
训练数据的采购方主要是少数几家头部AI实验室。任何一家削减预算或转向自建数据团队,都可能对营收产生显著冲击。
与此同时,当前实验室大量采购人类专家数据,很大程度上是因为模型仍处于能力爬坡期。一旦合成数据技术成熟到能替代部分人工标注,或者模型能力增长放缓导致实验室收缩数据投入,市场空间可能收窄。
竞争也在加剧。Scale AI已推出专门的强化学习环境产品线;Mercor估值在2025年达到100亿美元,目前正按约200亿美元估值洽谈融资;Surge AI在高端人工反馈领域有品牌优势,长期向Google、Meta、微软等公司提供人类反馈数据,并参与Gemini、Claude等模型训练。AfterQuery目前凭验证机制和基准测试证明能力形成了差异化,但这道壁垒够不够深,还需要时间检验。
06
把稀缺的专家,
变成可以复制的能力
AfterQuery把自己的终局愿景称为"经济奇点":一个顶级律师能服务的客户有限,一个优秀医生一天能看的病人有限。
专业能力之所以昂贵,一个重要原因就在于它无法大规模复制。一个人的经验,被锁在他的时间和职业生涯里。
AfterQuery想把这层限制拆掉。公司曾描绘过这样的未来:每一家初创公司都能获得合伙人级别的法律服务,每一个患者都能以极低成本,在手机上获得梅奥诊所级别的诊断。
律师怎样判断,医生怎样诊断,工程师怎样排查问题,投资人怎样从一堆数字里发现异常。这些东西过去只能靠一个人花十年、二十年慢慢学会。未来这些经验可以被提取、训练,然后复制。
互联网上能找到的知识终会越来越便宜,真正稀缺的是那些从来没有被写下来的经验。谁能更快地把它们从人的脑子里取出来,变成机器能够学习和验证的东西,谁就有可能拿下AI训练中最贵的一层供给。
推荐阅读: