ARTICLE · 1008533
AI 改代码总顺手改别的?光写规则没用,得把反例摆出来
AI SKILL 拆解 · 第 05 期
multica-ai/andrej-karpathy-skills · MIT(文档声明)· 21.3 万 stars · 零代码,纯文本
你让它修一个空邮箱报错,它顺手把单引号改成双引号、补上类型注解、重排了缩进,还加了一条你没要的用户名校验。这不一定是你提示词写得太软,更可能是规则本身没有判据。这期拆一个 21.3 万星的规则文件:正文只有 522 token,却配了 6.3 倍体积的反面例子。下面给出实测注入成本、三条可复用的写法,以及什么时候该把它关掉。
一、它不是不听话,是不知道边界在哪
这个仓库的起点是一段公开观察:模型会替你做出错误假设然后闷头执行,喜欢把 100 行能做完的事写成 1000 行,还会顺手改动自己并没有理解的相邻代码和注释。
大多数人的第一反应是回去补一句「请简洁一点」「不要改无关代码」。这几乎不会有效。原因很朴素:「简洁」没有阈值,「无关」没有边界。一条无法判定「遵守了还是违反」的指令,对模型来说只是氛围,不是约束。
这个项目做的事情,本质上就是给每一条氛围式指令补上判据——而且绝大部分判据不在规则文件里。
二、一张图看懂它怎么运转
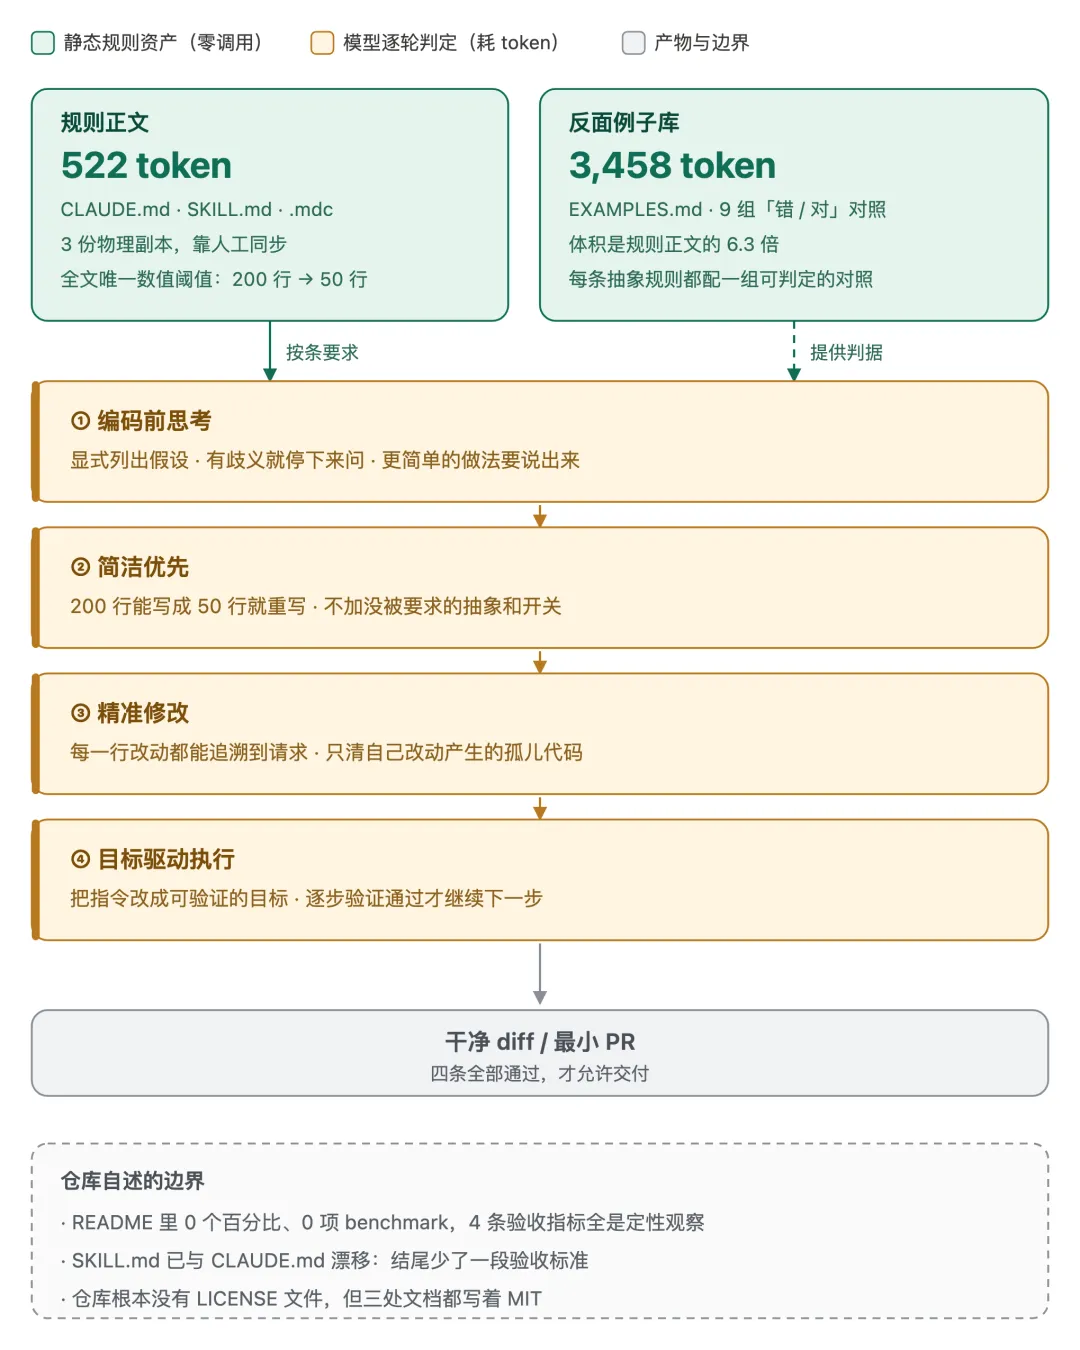
三、三条设计决策,为什么是对的
决策一:规则正文只写「做什么」,把「长什么样算错」全部外包
仓库里最重要的比例是 2,357 : 14,838。规则正文 CLAUDE.md 只有 2,357 字节(约 522 token),而它的配套文件 EXAMPLES.md 有 14,838 字节(约 3,458 token),是前者的 6.3 倍。
这不是文档没写完,是刻意的分工。翻遍规则正文,你能找到的硬阈值只有一个:「200 行能写成 50 行就重写」。剩下的检验标准都是启发式的——「资深工程师会不会觉得这过度设计」。这种话你自己也能写,它对模型的约束力接近零。
反例库补上了缺的那一半:9 组「错误示范 / 正确做法」成对出现,覆盖全部四条原则。比如「给一个折扣计算引入策略模式 + 配置类,30 行初始化只为了算一次百分比」对「一个三行函数」。这里最值得学的是 EXAMPLES.md 结尾的一句自我说明——那些过度设计的例子并不是写得烂的代码,它们符合设计模式的最佳实践,问题出在时机。
这句话解释了为什么规则写不好。你要教模型的不是「什么是坏代码」,而是「什么时候不该动用好代码」。前者是语法判断,后者是模式识别——而模式识别正好是给例子比给规则强的地方。
决策二:把「你可以不听」写在正文第一屏
打开 CLAUDE.md,第 5 行就是这句:这些指南偏向谨慎而非速度,琐碎任务请自行判断。
写规则的人通常只防一种失效:模型忘了。这个项目同时在防第二种失效:模型不分场合地照做。一次拼写错误的修复如果也要走完「列出假设 → 检查过度设计 → 逐行追溯 → 写测试验证」的全套流程,那这份规则就从资产变成了税。
而且注意它的位置——不是文末免责声明,是正文顶部,也就是必然会进入上下文的那一段。在规则文件里,位置就是优先级。这个权衡声明被放在了所有原则之前,等于告诉模型:先判断这件事值不值得走流程,再决定执不执行。
这正好接上第 04 期那个问题:规则文件是有按轮固定成本的。既然每一轮都在付,那么「什么时候不该付」的判断,必须让模型自己做得出来。
决策三:同一份规则复制 3 份,而不是生成——这是对的,但代价是真的
仓库里同一套原则有 3 个物理副本,服务 3 个载体:CLAUDE.md(Claude Code 项目级)、skills/karpathy-guidelines/SKILL.md(插件技能)、.cursor/rules/karpathy-guidelines.mdc(Cursor 项目规则)。
把它们放在一起比,三个载体的元数据语义完全不同:mdc 头部是 alwaysApply: true,意思是每一轮都注入;SKILL.md 头部是一段 description,它是按需触发的检索键;CLAUDE.md 干脆没有任何元数据。同一个内容,在 Claude Code 上是按需加载,在 Cursor 上是常驻——成本模型都不一样。
所以在这个场景里,手工复制比写生成器更划算:任何统一生成器都得先吸收 3 套平台各自的元数据方言,而它省下的只是几百字的重复维护。这是很小但正确的取舍。
代价也真实存在。作者在 CURSOR.md 里留了一句话,要求改原则时记得手动同步这几个文件——靠人记住,就会漂。我逐行比了一遍,结果写在下面。
四、实测数据
| 212,796 | gh api repos/… | |
CLAUDE.md | ||
SKILL.mdkarpathy-guidelines.mdc | ||
| 1,658 | ||
EXAMPLES.md | ||
| 2 / 3 份已不同 | ||
| 0 条 | ||
| 缺失 |
口径说明:token 数是用 tiktoken 的 o200k 分词器对原始文件做的估算,不是 Claude 官方分词器的结果,通常有 ±10% 内偏差;用法是横向比较,不是当预算表。副本漂移是我把三份文件去掉标题行后逐行归一化比对得出的,mdc 的 38 行正文与 CLAUDE.md 完全一致,SKILL.md 差 1 行——它把开头声明换成了带原文引用的版本,并去掉了结尾那段「怎样算生效」的验收标准。第 11 行的 100+ 是因为 GitHub 把仓库 issues 关了,PR 列表只返回了满页 100 条。
五、3 分钟上手
第 1 步那个旧账号名不用改——仓库迁到 multica-ai 组织后,GitHub 对旧路径保留了重定向,命令照跑不误。但你要知道自己在装哪个版本,所以后面几步我给的直链用的是当前仓库名。
六、适用边界
| 最适用 | ||
| 最适用 | ||
| 别用 | ||
| 别用 | ||
| 别用完整四原则 | ||
| 不成立 | ||
| 先确认授权 |
七、写在最后
这份规则文件真正可迁移的东西只有一条:当你想让模型改掉某个习惯,先问自己这条要求能不能被判成「遵守」或「违反」。判不了,就去写一组正反对照的例子,而不是再加一句形容词。
它另外两个选择同样值得抄:把可能的过度触发写在最前面,把超过自己体量的部分交给例子去承担。
至于那 21 万星——它更接近作者的信誉背书,而不是这份文件的读者收益。真正决定它对你有没有用的,是你手上有没有那种「模型总在同一类地方多动手」的重复性痛点。有的话,这 522 token 花得很值;没有的话,它只是另一段你不读、模型也不一定听的文字。
你有没有被 AI「顺手改进」坑过的经历?是引号风格、类型注解,还是那行你没删、它替你删了的注释?评论区说说,我挑几个典型场景,下一期接着拆。
第 06 期 · affaan-m/ECC
257,785 stars,MIT,JavaScript。如果说本期是「一个文件 + 零行代码」的极简路线,它就是完全相反的一端:一套把技能、本能、记忆、安全打包在一起的 agent harness 性能优化系统。
切入角度:承接本期留下的问题——光靠写规则约束不住模型行为,那一层「本能」和一层「记忆」是怎么在框架层把它兜住的?以及这层兜底自己带来了多少固定成本。
本期所有数字均来自仓库内公开文件(README.md、CLAUDE.md、CURSOR.md、EXAMPLES.md、skills/karpathy-guidelines/SKILL.md、.cursor/rules/karpathy-guidelines.mdc、.claude-plugin/plugin.json)与 GitHub API 元数据,未引用任何第三方转述。token 估算与副本漂移比对为本人复算,口径见表下说明。