ARTICLE · 1011309
AI自动化工具真实实测与工作流避坑
AI工具,自动化,开发者效率
AI自动化工具真实实测与工作流避坑
AI自动化工具真实实测与工作流避坑:能跑起来,离能交付还差几步
我最近重新跑了一遍 AI 自动化内容管线,最先暴露出来的不是模型能力,而是一个很容易被忽略的问题:命令返回成功,不等于结果已经可以交给别人。你有没有遇到过这种情况:任务页面显示完成,打开交付物却发现正文、图片或后台状态根本对不上?整条链路我只盯3个结果:正文是否真实落盘、图片是否真的能显示、草稿是否能在后台回查。
这次任务的目标很具体:围绕“AI效率工具、开发者自动化、开源工作流”做一轮公众号内容准备,完成选题、写作、配图、排版和草稿箱回查。看起来像是一条直线,实际跑下来却分成了好几层:趋势数据是否真的来自目标平台,文章是否真的落盘,图片是否真的能在微信里显示,草稿是否真的进入后台。任何一层只看日志,都可能得到一个过于乐观的结论。
我先把“选题很热”这件事拆开
这次公众号专属采集使用了搜狗微信搜索,查询词是“AI效率工具、开发者自动化、开源工作流”,实际返回10条同赛道内容。结果里反复出现几类方向:AI自动化工具清单、工作流平台、Agent接管重复工作、开发者效率提升,以及“一个命令让软件变成AI助手”这类强承诺标题。
这些结果足够说明赛道正在讨论什么,但还不足以证明哪篇文章是完整的爆款样本。因为搜索结果给我的主要是标题和摘要,缺少完整正文、配图结构、真实阅读数据和文章的完整排版。管线因此把这批样本标成“强公开搜索证据”,同时把完整爆款拆解标成 blocked。这一步很重要:搜索结果能支持方向判断,却不能被包装成已经完成的深度研究。
所以这次没有继续写“2026年最值得收藏的10个AI工具”。这种题目看着稳,实际上很容易变成工具名堆砌,也很难回答读者最关心的问题:到底怎么接进自己的工作流,失败时怎么定位,什么情况下根本不值得自动化。
最后留下的角度是:真实跑一遍 AI 自动化工作流,记录它从“看起来完成”到“可以交付”之间到底差什么。
第一关:不要把“创建任务”误认为“文章已经生成”
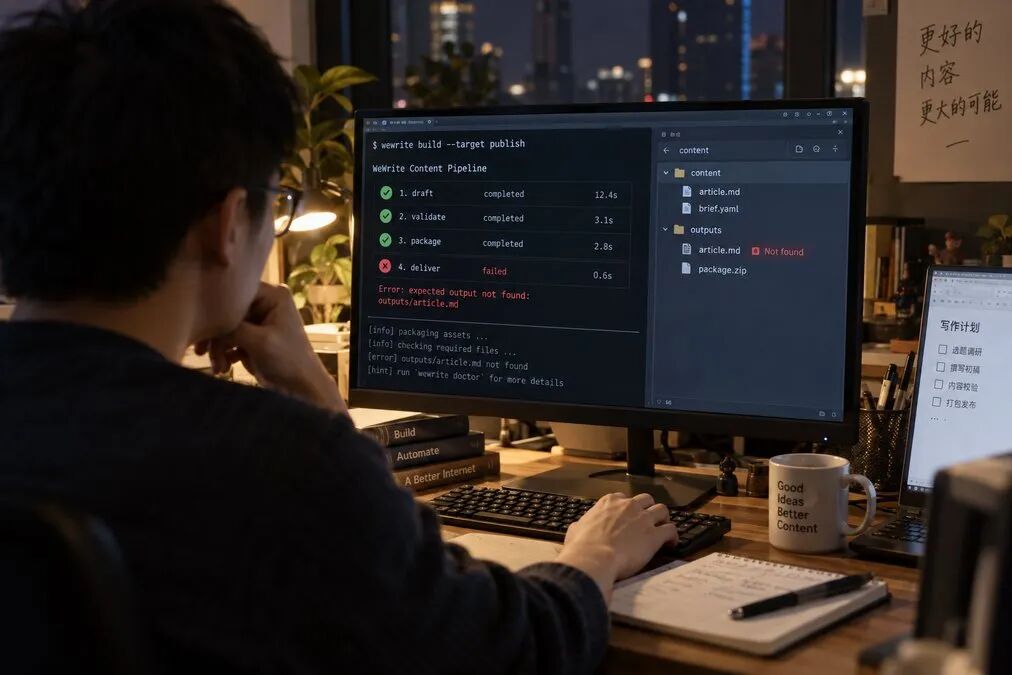
项目里有一层内容管线负责创建 WeWrite 运行。它会生成运行ID、状态文件和文章产物路径,例如本轮运行ID是 20260914-205338-b5cdd5,状态是 active,模式是 draft。
我第一次调用项目包装命令时,命令返回了 draft_created,还接受了一个输出路径。但回查文件系统后,那个指定路径并不存在。继续往下跑文章门禁,得到的只是 FileNotFoundError。这说明返回值只证明“任务记录创建了”,并没有证明“正文文件已经落盘”。
这类问题在自动化系统里非常典型。上层命令为了保持接口统一,可能返回一个状态;底层实际只做了初始化。两个动作如果没有明确区分,后续流程就会把空任务当成有内容的任务,接着生成图片、上传素材,最后甚至推一个空草稿。
我后来直接读取了 WeWrite 的运行状态文件。里面明确列出了 article.md、brief.yaml、claims.yaml、images.json 和预览文件等预期产物,但目录里实际只有 state.yaml 和 sources.yaml。这时正确的动作不是重跑十次,而是定位入口实现:包装器的 article 动作实际上只是调用 run start,并没有执行写作器。
我的检查原则很简单:
有运行ID,只能说明任务被登记; 有 draft_created,只能说明创建阶段返回成功;正文文件真实存在,才算进入文章门禁; 文章通过字数、图片、钩子和CTA检查,才算具备排版条件。
第二关:写作模型失败时,不要用旧稿冒充新稿
原本的写作器配置指向 DeepSeek。实际调用返回的是 HTTP 402 Payment Required。这个错误不是文章内容的问题,也不是网络超时,而是供应商侧计费状态不满足当前请求。
随后我检查到环境里还有 DashScope 的 Key,于是临时在子进程里尝试了 OpenAI 兼容端点。结果返回 HTTP 401 Unauthorized。这里也不能把“环境里存在一个 Key”理解成“这个 Key 一定属于当前端点”,更不能把一次失败后留下的旧文章复制过来充当本轮产物。
在内容工作流里,旧稿尤其危险。它可能有旧标题、旧图片URL、旧数据和旧选题,甚至已经在公众号发布过。最稳妥的处理方式是保留本轮趋势证据和 brief,确认写作模型失败后,改由当前编排模型直接生成正文,并把所有不可核验的数据改成明确的待补字段或可验证的操作步骤。
这也是我认为 AI 自动化最容易被低估的地方:真正可靠的系统不是“永远不失败”,而是失败后仍然知道自己停在哪一层,不会把上一轮的结果顺手拼进这一轮。
第三关:能跑不等于能交付,至少要看三份证据
第一份证据是输入证据。你要知道这次工作流到底接收了什么:查询词、目标平台、账号赛道、文章目标、事实来源和历史去重范围。如果输入只写成“生成一篇AI工具文章”,后面很难判断文章为什么会变成工具清单。
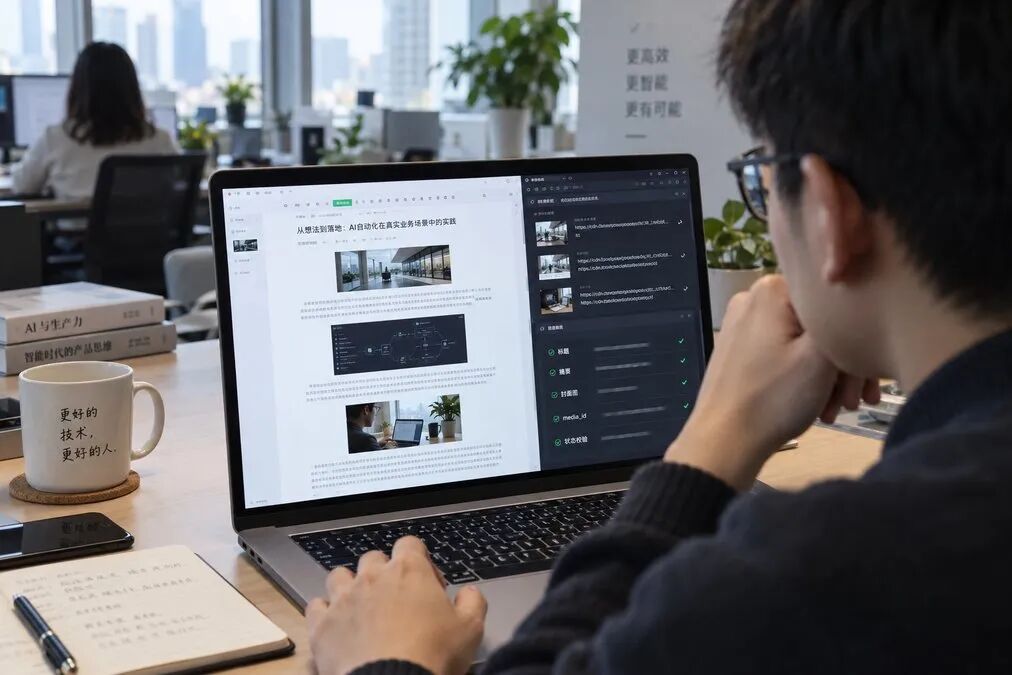
第二份证据是过程证据。它不需要把所有日志都保存下来,但至少要留下关键动作:哪个源返回了多少条结果,哪个步骤实际生成了哪个文件,图片生成是否成功,上传是否拿到了微信永久素材的 media_id,HTML 是否使用了内联 CSS。
第三份证据是结果证据。文章文件存在不算结果完成;还要检查中文字符数、正文图片数量、图片URL是否是微信 CDN、封面是否真实可用、标题是否重复,以及最终草稿箱里标题和摘要是否匹配。
公众号尤其不能只看 API 返回的 HTTP 200。草稿接口返回 media_id 后,还必须通过 draft/batchget 回查。回查至少核对标题、摘要、作者、正文图片数量和内容状态。没有回查,就只能标记为“提交请求已发出”,不能写成“草稿已确认”。
一套我现在会先跑的最小检查表
如果只是准备一篇公众号实测文,我会按下面的顺序走:
先确认账号赛道,不把其他平台的热词直接搬过来。 采集公众号自身可见的同赛道内容,记录查询词、时间和返回条数。 只把搜索摘要当作方向信号,不能把它写成完整爆款拆解。 检查近7日已发布或已定时的标题,避免工具和结构重复。 写入机器可读 brief,明确文章目标、事实边界、图片位置和风格限制。 生成正文后,先检查文件是否真实存在,再跑文章门禁。 每1到2个段落安排一张与内容对应的图,不把配图全部堆在文末。 图片必须重新上传微信永久素材,不能直接复用过期的旧URL。 HTML 必须使用内联样式,正文字号按公众号阅读场景控制在16px左右。 推送草稿后调用批量回查,确认平台侧真实落盘。
这份清单看起来不复杂,但它把“生成内容”“准备素材”“提交平台”“平台确认”四个状态拆开了。自动化系统最怕的不是步骤多,而是多个状态被一个模糊的“成功”覆盖。
哪些工作适合交给AI自动化
适合自动化的,通常是规则清楚、输入输出稳定、失败容易被检测的工作,比如抓取一批公开搜索结果、整理标题、统计字数、检查图片数量、生成 HTML、记录运行状态和做草稿箱回查。
不适合直接全自动放行的,是需要事实判断和语义判断的环节:这个话题今天是否真的有热度,某个工具是否真的适合目标读者,文章里的数字能不能证明,图片是否真的解释了相邻段落,以及一篇内容是否只是换了几个工具名的旧模板。
我的做法不是把人工完全删掉,而是把人工放在最值得判断的位置:选题决策、事实确认、最终视觉检查和公开发布确认。其余重复步骤交给脚本执行,并要求每一步留下可回查证据。
最后说结论
AI 自动化的价值,不在于让每个按钮都自动变绿,而在于让一条任务链更快发现“哪里还不能交付”。这次实测里,趋势采集是成功的,公众号专属证据也已经落盘;但完整爆款拆解被证据不足门禁阻断,固定写作模型又先后遇到 402 和 401。真正可靠的结果不是假装这些问题不存在,而是把它们准确记录下来,再选择能被验证的替代路径。
如果你也在搭自己的内容自动化工作流,我建议先别急着接更多平台。先把一个平台跑通:输入可追溯,正文真实落盘,图片和文章语义匹配,发布状态分层,平台结果能回查。等这五件事稳定后,再扩展到更多渠道,成本会低很多。
你在使用 AI 自动化时,最常遇到的是“生成不出来”,还是“看起来完成但实际不能交付”?欢迎在评论区说说你的具体场景。觉得这份检查表有用,可以关注后转发给同样在搭工作流的朋友。
📱 同主题视频已发布到视频号