ARTICLE · 1011818
做一款 AI 生成工具,哪些问题需要在产品里解决?
对于当前的内容生产来说,用 DeepSeek、豆包写文案,用 ChatGPT 生成图片,用 Seedance、MiniMax、可灵生成视频,再用 Suno 做配乐,已经是很常见的创作方式。文字、图片、视频、音乐,过去需要不同专业团队完成的内容,现在越来越多都可以在生成式 AI 工具里完成。
大平台之外,也有公司围绕某一种能力做得更深、更精:比如 LibTV、Tapnow 专注于视频创作,也把生成能力通过 API 提供给其他企业;一些产品用无限画布把图片、视频生成和编辑放进同一个创作空间;Tripo 则把文字和图片变成可以继续编辑、导入游戏制作流程的 3D 模型。
工具连着内容生产的前后两端,而做工具的人,也有自己的生意需要考虑。产品开放哪些功能,怎样让创作者留下来,生成的内容又能走到哪里。功能设计影响创作体验,也可能把不同人的利益带进同一个产品。
9 月 7 日,最高人民法院发布《关于依法审理涉人工智能纠纷案件的意见》(下称《意见》)。这份文件让我们有机会重新看一遍 AIGC 内容经过的各个环节。今天这一篇先把目光聚焦在工具:那些让创作更顺手的功能,是怎样改变内容生产的?
工具参与了哪些创作环节
生成一张图只是起点。想让同一个人物出现在不同画面里,创作者会上传参考图;生成以后还可以继续修改、延展,再把图片变成视频。工具提供的功能越来越多,也由此参与了更多创作环节。
无限画布就是一个直观的例子。素材上传、模型调用、图片和视频生成、后续编辑,都可以发生在同一个创作空间里。用户把素材放进画布,调用不同模型,再围绕已有结果继续修改和组合。
工具也因此从一个“生成按钮”,逐渐变成完整的创作环境。一份内容经过的环节更多了,后来真有争议,先得知道各人做了什么:素材是谁上传的,调用了什么模型,哪些内容来自用户,哪些由模型生成,中间又经过了哪些修改。
素材进入工具以后
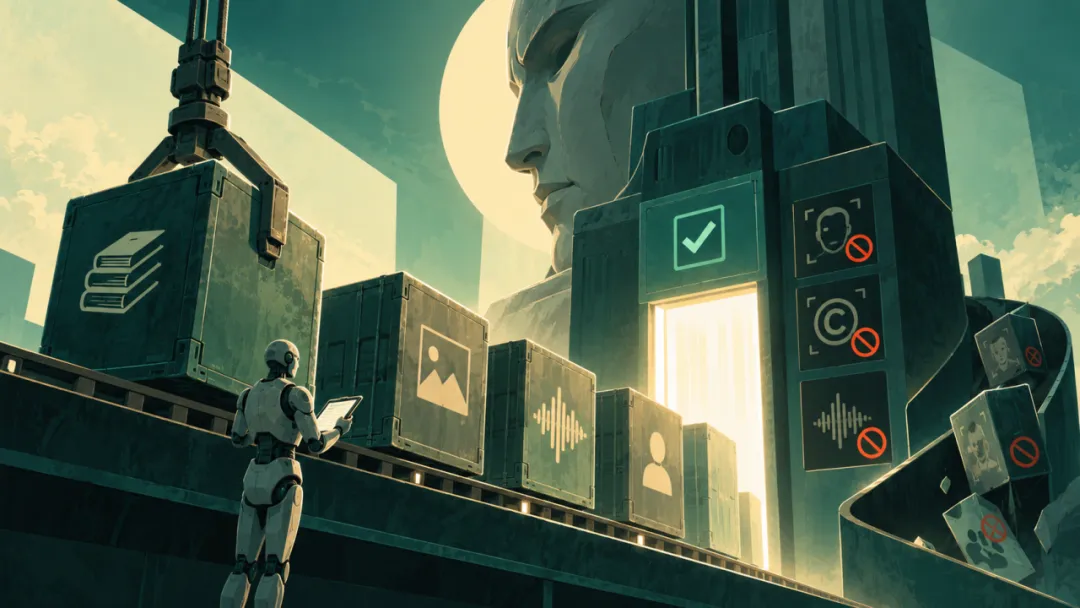
训练角色模型要上传图片,做配音工具要处理声音。对创作者来说,这是把素材交给工具;对做产品的人来说,图片里可能有别人的脸,录音里可能有别人的声音,还有人会上传受版权保护的作品。素材能否进入工具,不能只看它是否容易获取。
《意见》第 6 条讨论了其中一种情形:个人信息已经合法公开,在合理范围内处理,且本人没有明确拒绝的,一般不认定侵害个人信息权益;若对个人权益有重大影响,仍应依法取得同意。
作品的版权问题还没有同样明确的答案。《意见》没有直接规定未经授权用作品训练模型是否侵权,已有个案也不足以给所有训练活动一个结论。这里还得分清:公司训练基础模型,与用户在工具里上传图片、训练专属模型,虽然都叫“训练”,参与的人和过程却不同。
声音的边界更具体。配音演员殷某桢的录音经多方流转,进入一款文本转语音产品。北京互联网法院认定,拿到录音,不等于取得将她的声音 AI 化、供他人调用的授权。《意见》第 4 条也回应了未经同意用自然人声音训练、生成可识别合成人声的问题。语音工具能做出一种声音之前,还要弄明白:谁有权允许它这么做。
素材从哪里来,过后还能不能说清,同样重要。《意见》第 12 条要求,人工智能服务提供者面对生成内容侵害著作权的争议时,可以通过训练数据来源、过程记录和模型运行机制等材料证明自己采取了合理必要措施。平时藏在后台的记录,遇到争议时可能就是解释产品如何工作的材料。
结果生成以后
好的生成效果可以被反复使用,问题也可能跟着扩散。
杭州“奥特曼”案里,用户上传角色图片训练 LoRA 模型,其他人可以反复生成类似形象。法院区分用户上传与平台管理的环节,认为平台在输出端未采取必要措施,构成帮助侵权,判赔 3 万元。广州另一件“奥特曼”案涉及平台直接提供文生图服务,法院关注其缺少投诉、提示等措施,要求停止侵权并防止继续生成相关图片。
上海“美杜莎”案给出了一个对照:用户训练并发布动漫角色 LoRA 模型,平台设置了发布前审核、举报入口,并在收到通知后下架相关模型。二审法院最终没有判令平台承担连带赔偿责任。
几起案件的产品形态、风险和平台措施各不相同,不能简单总结成“有审核就免责”或者“能生成就担责”。真正值得产品团队注意的是:工具参与到了哪一步,又在自己能够控制的环节做了什么。
《意见》第 7 条讨论生成内容侵害名誉权、隐私权等人格权益;第 12 条讨论生成内容侵害著作权时,怎样结合服务类型、参与程度和已采取的措施判断责任。两类争议的规则不同,但落到产品上,都绕不开过滤、举报、下架,以及发现问题后能否阻止风险继续扩大。
工具接进别人的产品以后
许多独立工具还有另一门生意。seedance把视频生成能力通过 API 提供给企业和开发者;Tripo 提供接口与插件,让 3D 生成进入游戏和美术制作流程。最终用户可能只看见另一家公司的产品,于是谁开发模型、谁设计界面、谁允许上传素材、谁负责发布内容,就可能分属不同主体。
还有人从开源资源开始做产品。《意见》第 13 条谈的是涉人工智能开源软件相关方的责任,并以免费提供部分代码模块等情形说明可能的责任豁免。但“用了开源”并不是整款产品的免责卡。接入现成资源以后,应用方自己设计的上传、生成和发布功能,仍要看它实际做了什么。
还有一件容易被忽略的事:生成之后,产品能不能还原那次过程。
《意见》第 18 条规定,当 AI 生成内容被用作侵权证据,法院会考虑提示词、重复测试的一致性、模型训练及过滤机制等因素。它没有规定所有工具必须保存什么;但要处理投诉、复现问题,如果只留下最终图片,却不知道用户上传了什么、调用了哪个模型、输入过什么提示词,往往是不够的。
回到开头的问题:让创作更顺手的功能,也让工具更深地参与内容生产。素材怎样进来,调用了哪些模型,生成结果怎样分享,能力又怎样接进其他产品,出了问题能不能找到并处理,都与产品设计有关。
工具越像一个创作场所,做工具的人就越需要了解这个场所里发生了什么。
下一篇,我们再看使用工具的创作者:一份 AI 内容里,人的选择体现在哪里?
【END】
作者简介
北京星也律所高级顾问
于泽辉
法律行业的AI创业者
All in AI+legal,用法律帮助AI创业,用AI重塑法律服务
「新朋友招募计划」
我寄offer与明月
只待将才共和鸣