ARTICLE · 1012397
AI记住了你的工作内容,不等于学会了工作
法律AI公司Harvey的AI律师记得每位合伙人喜欢什么格式、什么风险措辞、什么司法管辖区的惯例。这些记忆在产品里有一个专门的功能页面,用户可以查看、修改和删除它们。但Harvey同时在做另一件事:构造法律任务环境,用专家评分标准训练模型调整执行策略。前者保存上下文,后者试图改进下一次执行。两者都重要,但不是同一种能力。
记忆保存上下文,学习改变下一次执行
a16z合伙人希玛·安布尔(Seema Amble)在《The Incumbents Are Coming》中将二者区分为:记忆可以让通用智能体(Agent)记住客户偏好或上周的决定,但它本身不能判断工作是否做得好、专家为何修改,也不能告诉系统下一次该改什么。
记忆,是AI系统保存用户决策、偏好和格式要求的能力。下次对话时它不需要你重复交代背景。Harvey的Memory功能就是这样:跨会话保存用户的写作格式、风险偏好和司法管辖区要求。Harvey明确声明,这些个人Memory不用于训练模型。
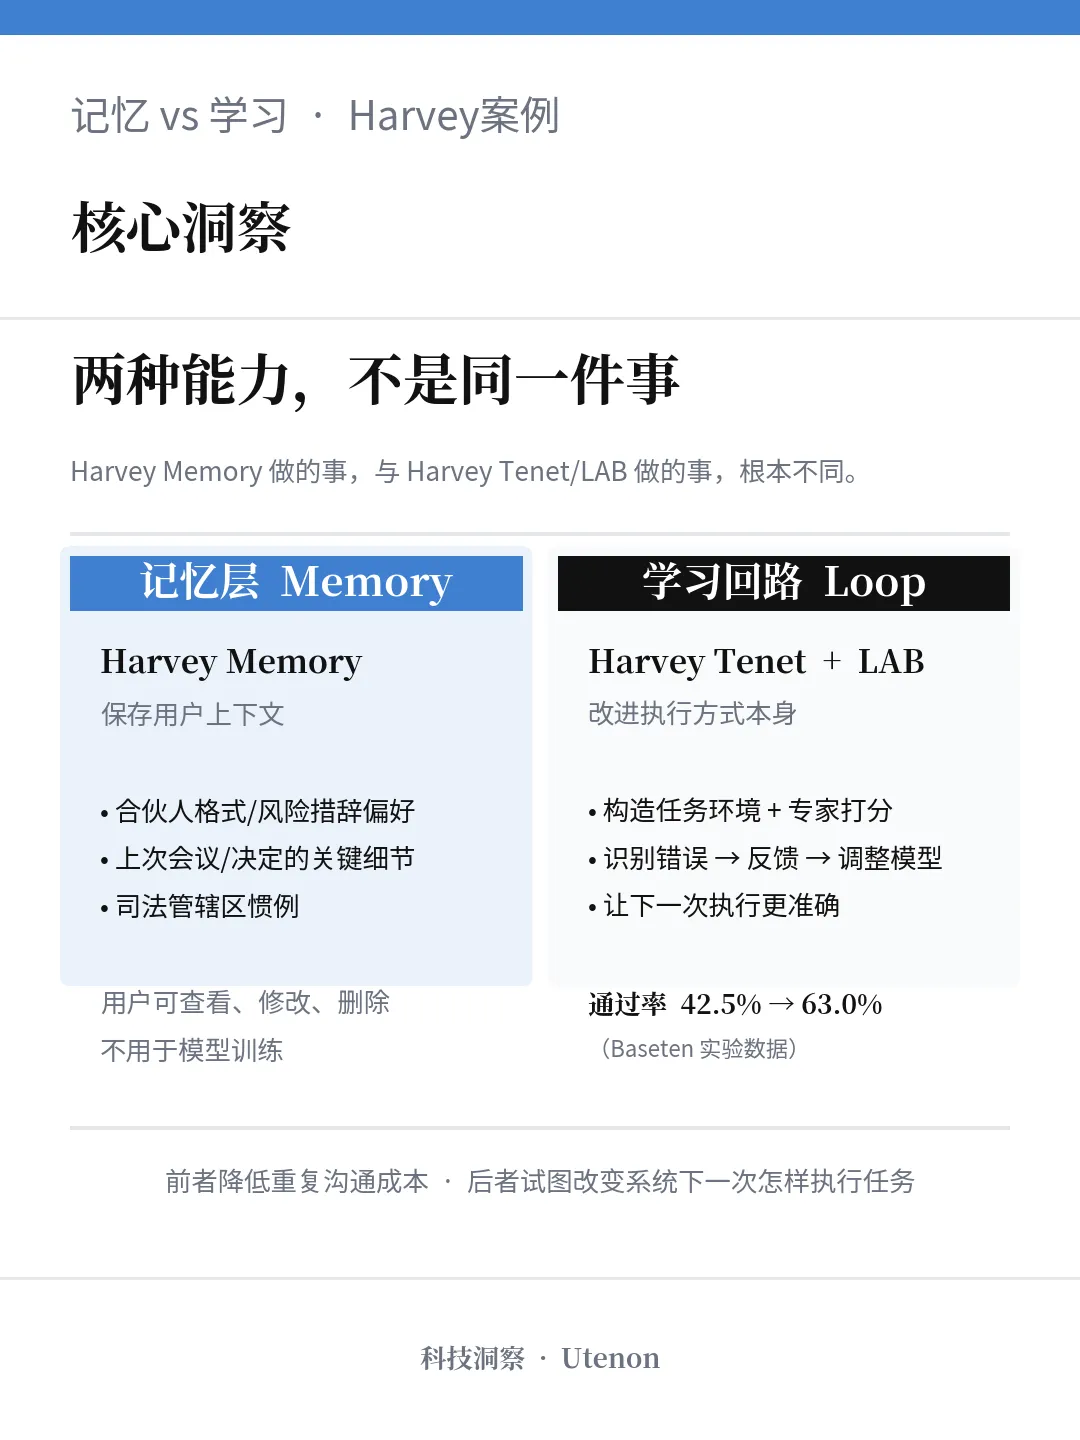
学习是另一回事。本文所说的「学习」,采用产品系统层面的宽口径:系统获得质量反馈,并据此改变后续执行。改变可以发生在模型参数中,也可以发生在提示词、工具、知识库或工作流中;它不等同于狭义的模型训练。
学习要求系统知道一份合同审查做得好还是差,知道资深律师为什么修改了某个条款,知道下次遇到类似情况应该怎么调整。这需要三个条件同时满足:有明确的「对错」信号,有把信号转化为改进的机制,有持续迭代的循环。
认知科学对陈述性记忆与程序性记忆的区分提供了一个类比:记住事实和偏好,不等于掌握完成任务的技能。但人类记忆分类与AI系统机制并不一一对应,这里只作参照,不作等价。
许多AI产品已经能保存事实和偏好,真正困难的是把反馈转化为可重复、可验证的执行改进。
Harvey的训练场:先构造环境,再进入客户场景
垂直AI创业的经典困境是:没有客户数据就无法训练好模型,没有好模型就拿不到客户。 Harvey没有等待客户过程数据自然积累,而是先用合成数据、公开资料和专家设计的任务构造可执行、可评分的训练环境。
Harvey联合创始人兼CEO温斯顿·温伯格(Winston Weinberg)在红杉资本播客Training Data中说:
我们面临的最大问题,是这些任务的过程数据在互联网上根本不存在。
公开互联网上很少存在可直接用于训练的完整法律工作过程数据。案例文本是静态的,工作过程是动态的。
Harvey先构造可执行、可评分的模拟工作环境。据Harvey披露,Tenet的训练集约含1,750个法律智能体任务环境。每个环境模拟一个封闭的客户事项,由一段模拟合伙人布置工作的短指令、混合关键文件与外围文件的材料包,以及专家评分标准组成;任务指令平均约50个英文词,每项任务平均约有50条评分标准。单次训练rollout可超过1,000轮,并使用数十万词元(token)。
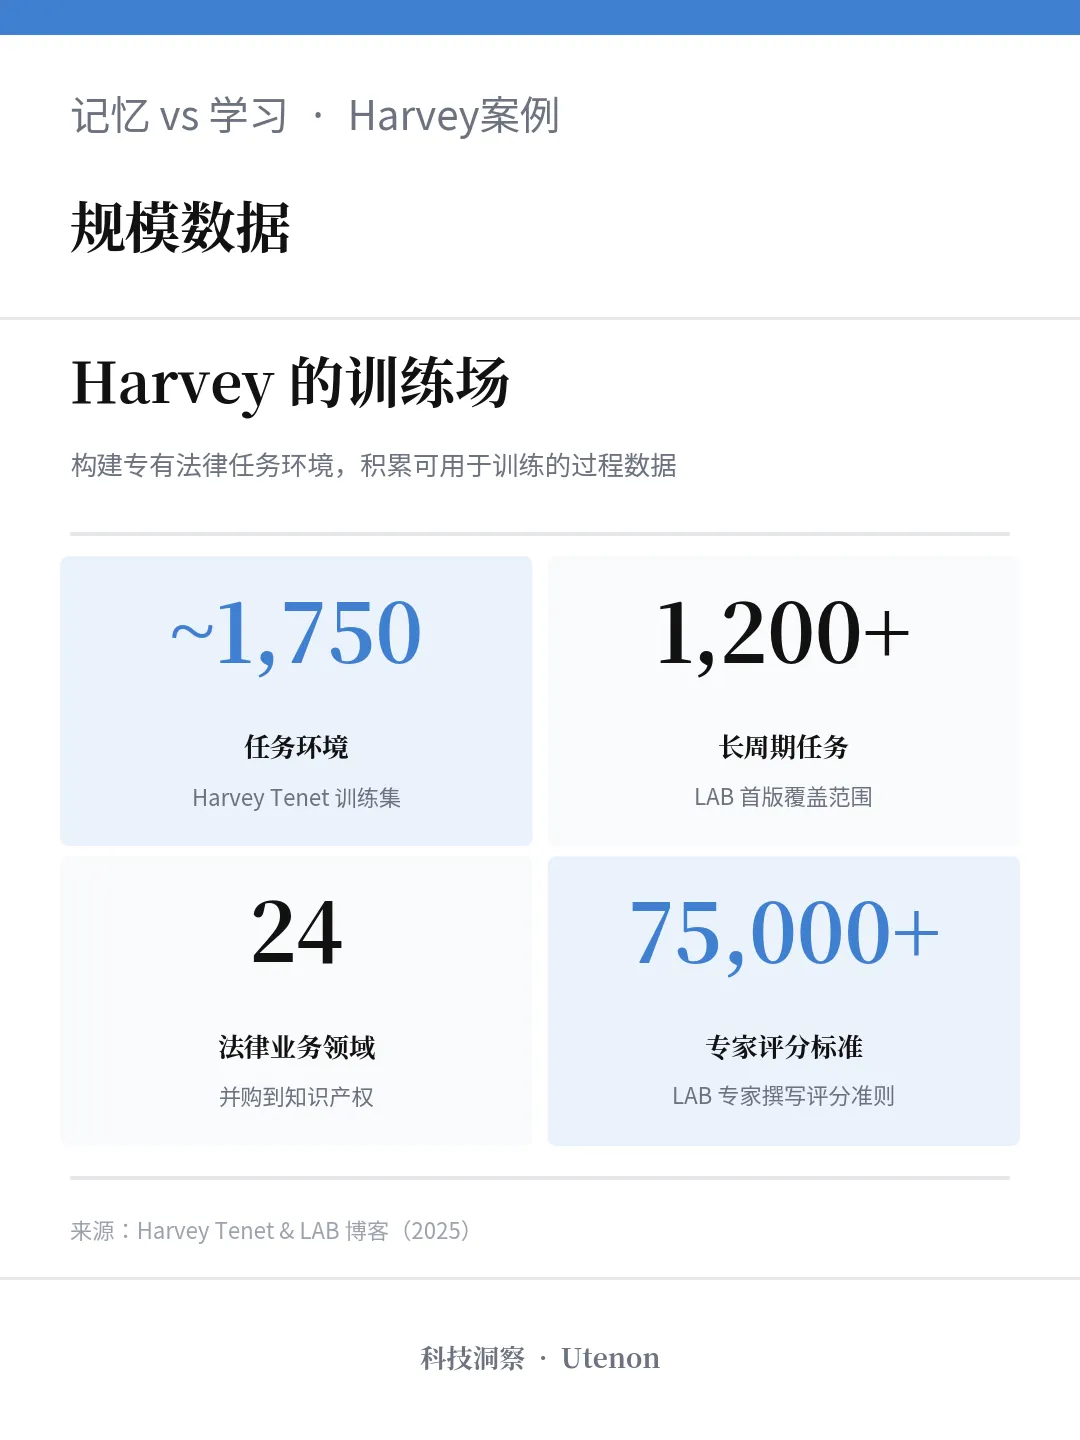
这套体系的关键在于评分标准。Harvey公开的法律智能体基准(LAB)首版包含1,200多个长周期法律任务、覆盖24个法律业务领域、75,000多条专家评分标准。评分标准把「这份合同审查做得好不好」拆解成几十个二元判断:这个风险条款是否被识别?管辖权冲突是否被标注?客户的特定偏好是否被执行?
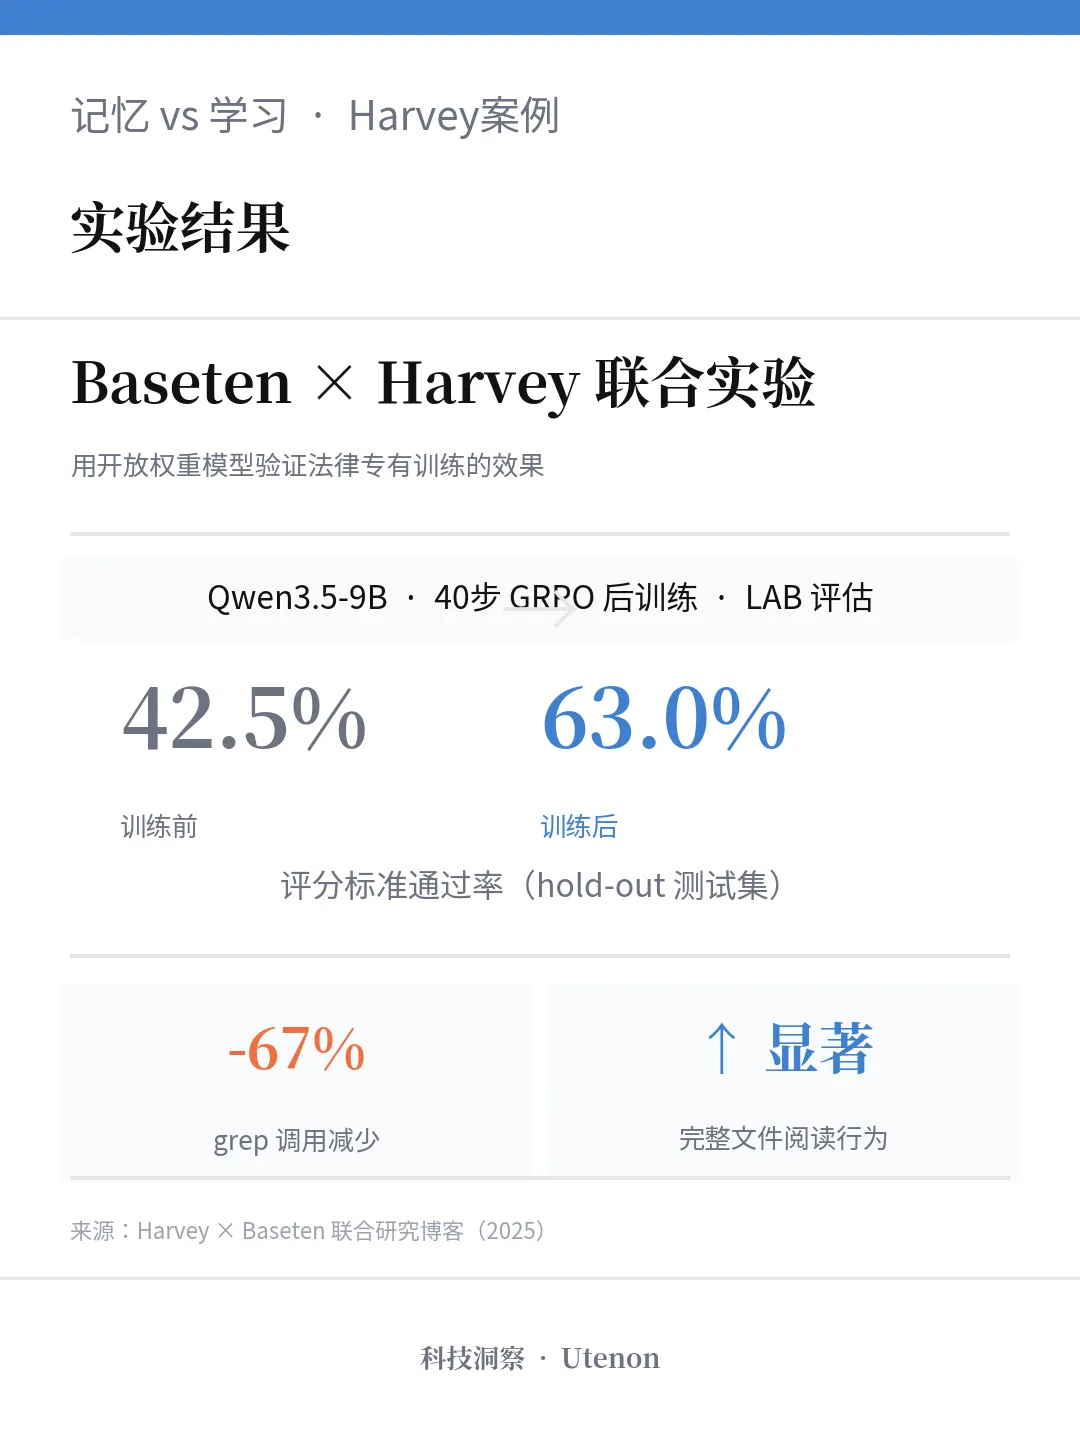
Harvey与Baseten联合开展了一项实验:Qwen3.5-9B仅以LAB评分标准作为奖励信号进行40步GRPO后训练,留出测试集(hold-out test set)的评分标准通过率从42.5%升至63.0%;与此同时,grep调用减少67%,完整阅读行为增加。该结果说明评分信号可能改变执行策略,但仍属于厂商与合作方的研究结果,不代表生产环境的普遍效果。
Harvey没有用任何客户数据完成这一步。训练材料来自合成数据、公开法律数据和专家创建的数据。温伯格的说法是「为职业制造课程」。a16z将这条路径概括为先学习职业通用标准,再逐步适应机构的模板、先例、风险阈值和升级规则。Harvey公开材料支持前半步的后训练研究;后半步仍是面向客户部署的路径判断,而非已被公开验证的持续学习成效。
学习循环的四个环节:大多数产品卡在起点
综合Harvey的实践以及OpenAI、Anthropic的评估方法,本文把学习循环整理为四个环节。
第一个环节是保存必要的上下文,包括偏好、历史和资料。 Harvey的Memory属于这一环节。它有明确价值,但仅靠保存上下文还不能形成持续改进。
第二个环节是定义好工作。专家把判断写成可执行的评分标准。 Harvey的75,000条评分标准在这里。这一步将「好坏」从模糊的人类直觉转化为可计算的信号。
第三个环节是在完整任务中测量。 Anthropic提醒,智能体评估不仅要看最终说了什么,还要检查执行轨迹和环境状态。Harvey的LAB则要求智能体在文档环境中完成可审阅的法律成果,并用专家评分标准核验成果是否满足要求。
第四个环节是让下一轮发生变化。 改进可以发生在提示词、工具、知识库、工作流、评估集或模型后训练中的任何一层。Harvey的Tenet研究预览以Kimi K3为基座,通过异步强化学习和GSPO优化长周期法律任务的执行策略。Harvey还在另一个使用开放权重模型Qwen3.8-27B的Firm Knowledge实验中报告了更高的词元效率(intelligence-per-token指标190.8,同规模对比模型37.2,前沿模型129.3)——但这是另一组模型、任务和评测,不能与Tenet成绩合并解读。
只有第四个环节发生,产品才从「记得更多」走向「持续改善」。
并非所有垂直领域都同样适合建立学习循环。Seema Amble在《The Incumbents Are Coming》中提出了一组判断条件:专家能否快速评估工作好坏?任务是否需要真正的专业判断,而不只是执行固定规则?执行是否高频发生?能否从单个任务扩展为完整工作流?四条同时满足的领域,反馈信号更密集、更可靠,学习循环相对更容易建立。
卡纳曼(Daniel Kahneman)对专家直觉的研究提供了一个有启发性的类比:可靠直觉更容易形成于规律相对稳定、实践频繁且反馈及时的环境,例如象棋和部分消防判断——与上述四个条件指向同一类特征。
某些高频、标准相对稳定的合同审查任务具备专业复核机制,也能从条款分析扩展到交易流程,因此相对适合建立学习循环。
反馈入口:三个垂直领域的早期信号
Harvey之外,一些垂直产品正在把审核、编辑和分类修正变成结构化反馈。
EvenUp公布了AI审核辅助标注的内部结果:在初步标注和人类专家审核之间加入AI审核层后,最终数据集标注精度提升约15%。
Abridge将临床医生对AI生成笔记的编辑视为潜在质量信号;一项单一机构前后试点数据显示,参与医生中71.9%同意或强烈同意工作满意度提高。
Ramp允许财务团队用自然语言修正分类规则;供应商报告显示,完成约250笔交易后,AI总账科目编码所需修正最多减少70%。
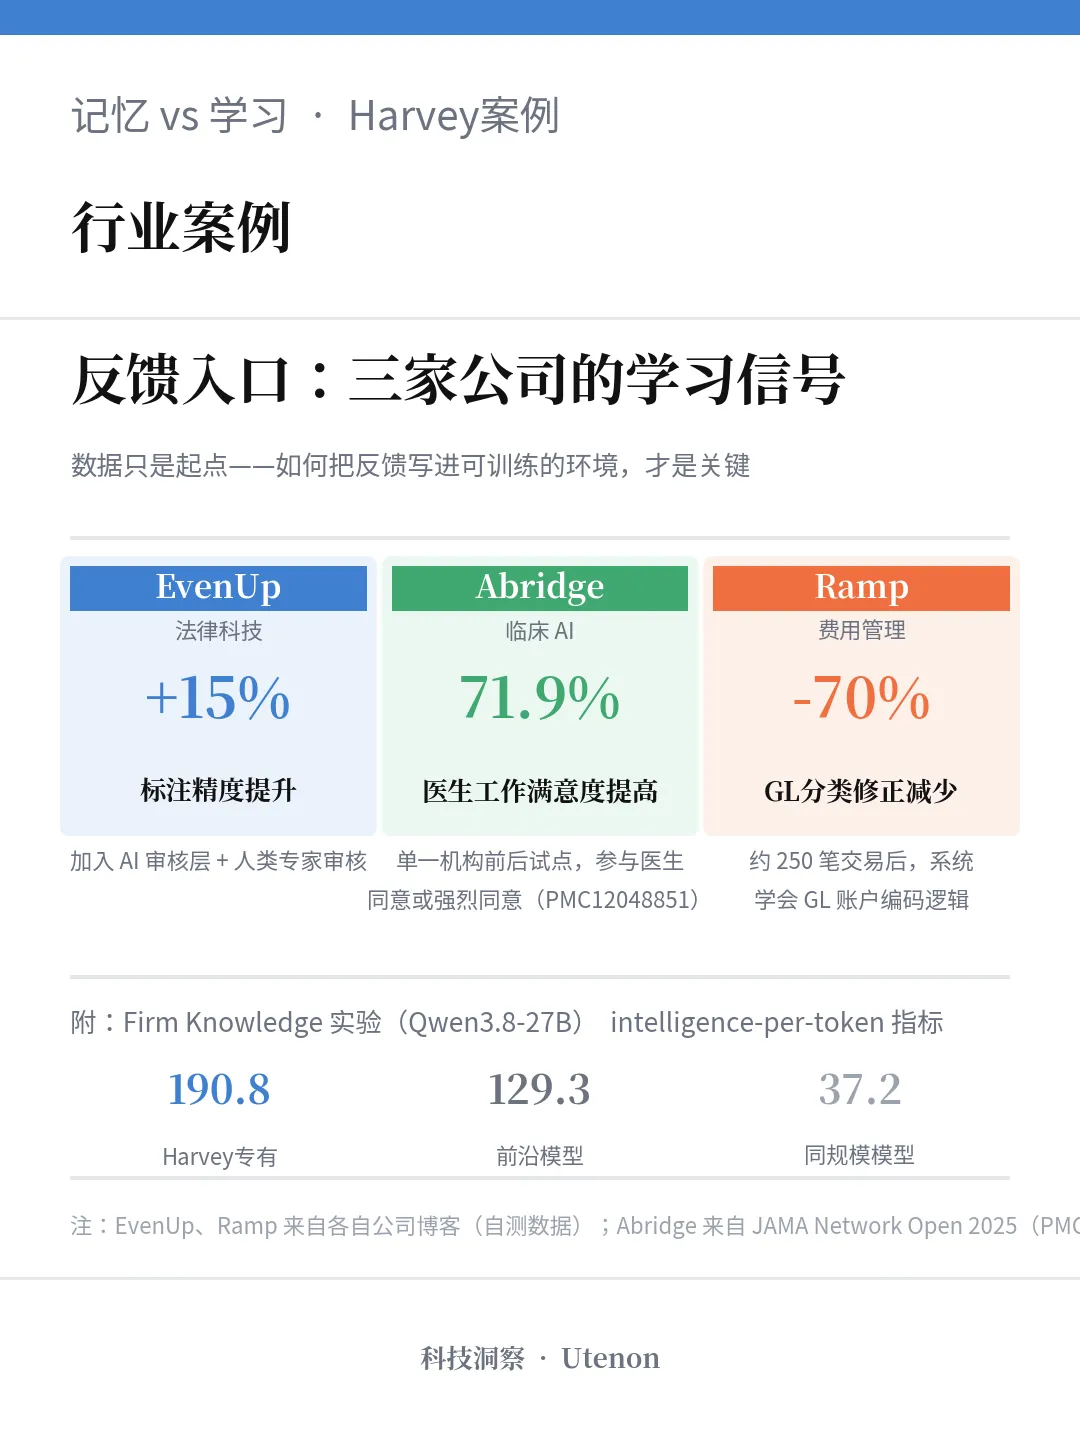
这些机制为学习循环提供了输入,但公开资料并不足以证明每次用户修正都会自动进入模型训练,或持续提升所有客户的结果。他们能说明反馈入口的形态,还不能宣称学习闭环已经完成。
对从业者意味着什么
如果你在做垂直AI产品,上述四个条件是一个快速自检工具:目标领域是否满足「专家可评估、任务需要判断、高频发生、可扩展为工作流」?满足得越多,越值得投入建设学习循环;但反馈质量、数据权限、更新机制和改进成本仍需单独验证。
更具体的行动是:在构建学习闭环之前,先定义一批可执行的评分标准。你不必一开始就拥有75,000条标准,但必须知道哪些结果算好、由谁判断,以及判断如何进入下一轮改进。Harvey不是在写第一行代码前完成了LAB,但它在进入客户场景之前,已经能够回答「好的法律工作」是什么。
国内市场已出现类似方向。百川智能(Baichuan Intelligence)将通用大模型能力迁移至医疗场景,自研了事实感知强化学习算法以区分事实陈述与幻觉,并在HealthBench上报告了较高综合评分——该结果来自团队自测,相关算法的消融数据显示其主要改善了被证伪率和不确定陈述率,值得关注但需独立验证。这个方向与Harvey的路径一致:先定义「什么是好的回答」,再让反馈驱动系统演进。
Harvey的Memory让系统不必反复询问你的格式和偏好;LAB与Tenet则尝试把法律任务、专家标准和反馈写进可训练、可评估的环境。前者降低重复沟通成本,后者试图改变系统下一次怎样执行任务。持续定义好工作、测出差距,让评估结果改变下一轮系统——这才是真正的门槛所在。
参考来源
① The Incumbents Are Coming(Seema Amble / a16z, 2026)https://a16z.com/the-incumbents-are-coming/
② Post-Training Update: Harvey Tenet(Harvey AI, 2026)https://www.harvey.ai/blog/post-training-update-harvey-tenet
③ Introducing Harvey's Legal Agent Benchmark(Harvey AI, 2026)https://www.harvey.ai/blog/introducing-harveys-legal-agent-benchmark
④ Memory is Here: Harvey, Personalized(Harvey AI, 2026)https://www.harvey.ai/blog/memory-is-here-harvey-personalized
⑤ How evals drive the next chapter in AI for businesses(OpenAI, 2026)https://openai.com/index/evals-drive-next-chapter-of-ai
⑥ Demystifying evals for AI agents(Anthropic, 2026)https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
⑦ Post-Training Open Legal Agents With Baseten Research(Harvey AI + Baseten, 2026)https://www.harvey.ai/blog/post-training-open-legal-agents-with-baseten-research
⑧ Training Data podcast(Winston Weinberg × Sequoia Capital, 2025)https://www.sequoiacap.com/podcast/training-data-winston-weinberg/
⑨ EvenUp AI Labeling Agents(EvenUp Law, 2026)https://www.evenuplaw.com/blog/ai-agent-ground-truth-data-labeling/
⑩ Physician Satisfaction with AI Ambient Documentation(JAMA Network Open, 2025)https://pmc.ncbi.nlm.nih.gov/articles/PMC12048851/
⑪ Ramp Accounting Automation(Ramp, 2026)https://ramp.com/accounting-automation-software