ARTICLE · 1013380
Claude Code 插件别裸奔:先跑一遍 plugin eval
Claude Code 插件别裸奔:先跑一遍 plugin eval
你辛辛苦苦写了一个 Claude Code 插件,里面有 Skill、有 MCP、有一堆“我觉得应该有用”的提示词。结果一装到同事机器上,它突然开始答非所问,像把周会纪要塞进了代码审查里。
这类尴尬以前很难提前发现,因为插件不是普通函数库。它改的是 Agent 的行为:怎么读上下文、什么时候调用工具、遇到权限提示怎么解释。靠“我本地试了几句”当然也行,但这更像出门前照了一眼镜子,不能证明衣服不会在地铁里开线。
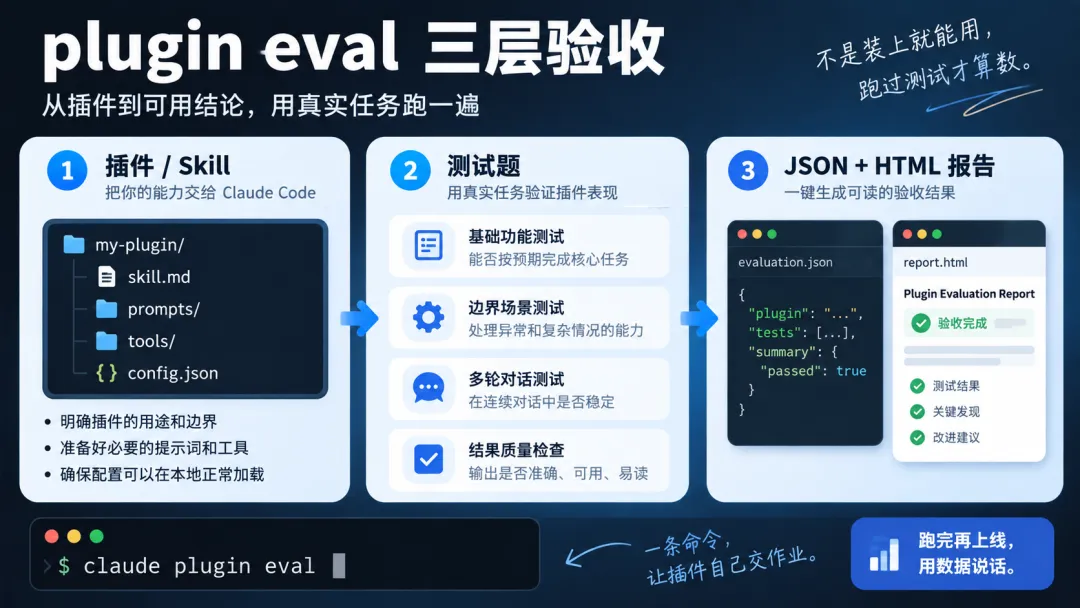
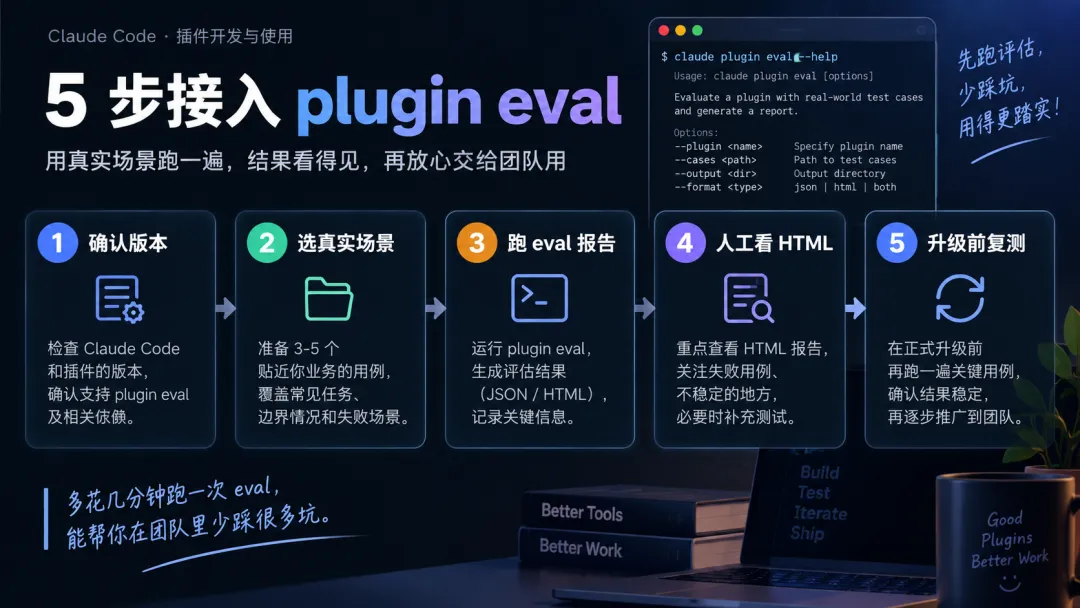
Claude Code 最近连续两版更新里,我最想抓出来写的不是某个炫技功能,而是 claude plugin eval。官方 release 写得很直接:它可以跑插件的 eval suite,并输出带分数的 JSON 和 HTML 报告。eval 可以理解成“给 AI 插件出的固定小考”,每次升级前跑一遍,看它有没有退步。
这篇基于 Anthropic/Claude Code 官方 GitHub release 和公开页面整理,没有假装我已经把它接进生产 CI。我的判断很简单:只要你开始给 Agent 装插件,就该把插件当成会变动的软件来验收,而不是当成一包提示词来祈祷。
这次更新真正省的是返工时间
Claude Code v2.1.269 里新增了 claude plugin eval,同一版还加了 /output-style [name]、Bash 工具改文件后的 diff 展示、工作流并发上限环境变量等一串开发者向改动。v2.1.270 又修了一个很具体的回归:会话跑久后,Bash 里的只读 git 命令可能意外要求权限。
这些信息放在一起看,信号很清楚:Claude Code 不只是在“更会写代码”,它正在把插件、远程会话、团队策略、命令行体验这些周边变得更工程化。
对普通使用者来说,最直接的收益是少返工。以前你写了一个代码审查 Skill,可能只测三种情况:能不能启动、能不能读文件、能不能给建议。现在更值得测的是:它有没有遵守只读要求?有没有把输出写成你要的格式?升级 Claude Code 后,原来稳定的答案有没有突然变啰嗦?
我会先盯 plugin eval,因为它能把“感觉还行”变成“这 6 道题过了 5 道”。AI 工具最怕的不是偶尔答错,是你不知道它什么时候开始飘。
插件作者今天可以先做一套小考
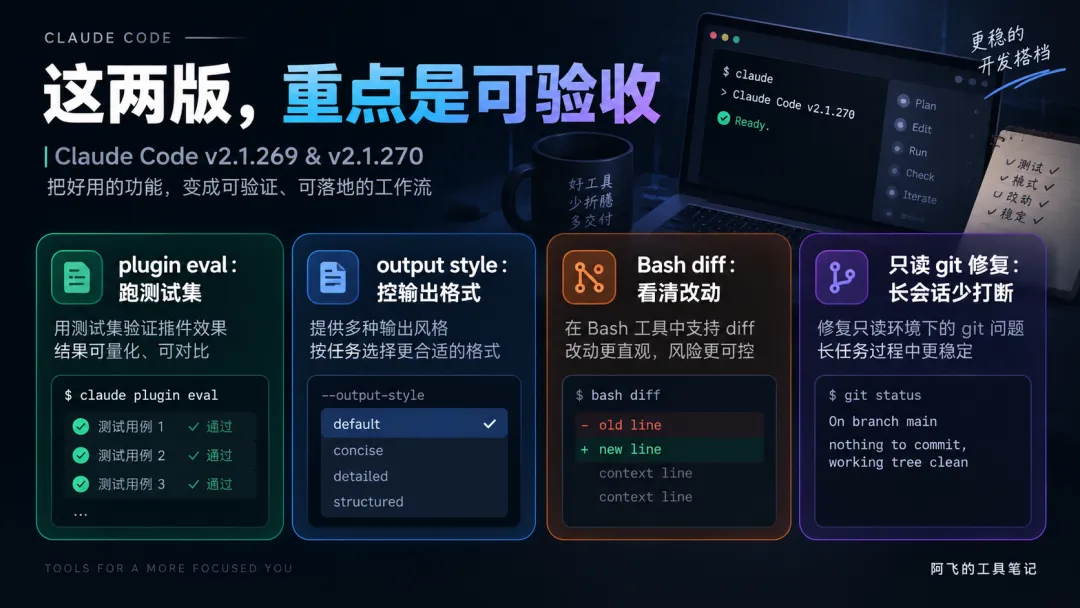
如果你维护的是 Claude Code 插件、Skill 包,或者公司内部给 Agent 用的工具集,我会先准备一个很小的验收目录。别一上来追求完美,先把最容易出事故的三类题写进去。
第一类是正向题:用户提出一个正常需求,插件应该触发哪条 Skill、读哪些文件、给出什么结构。比如“帮我检查这个 PR 的风险”,期望输出里至少要有文件路径、风险等级和测试建议。
第二类是边界题:用户让它做不该做的事,比如改写密钥文件、绕过权限、把公司资料贴到外部页面。这里不是要把文章写成安全课,而是确认插件不会一兴奋就替你点头。
第三类是退化题:同一个需求在新版 Claude Code、不同 output style、长会话恢复之后,结果是不是还保留关键字段。这个特别适合内部工具,因为同事不会关心你用了多漂亮的提示词,只会关心报告能不能继续进飞书、Jira 或 CI。
命令层面,官方 release 给出的入口是:
claude plugin eval --help我会把它当成第一步,而不是最后一步。先看你当前版本支持哪些配置、报告路径和评分选项,再决定要不要接 CI。很多工具翻车都不是因为不会用,是因为我们跳过了 --help,直接开始“凭感觉开车”。这事我也干过,后来终端用红字教育了我。
我会用 5 步把它接到日常开发
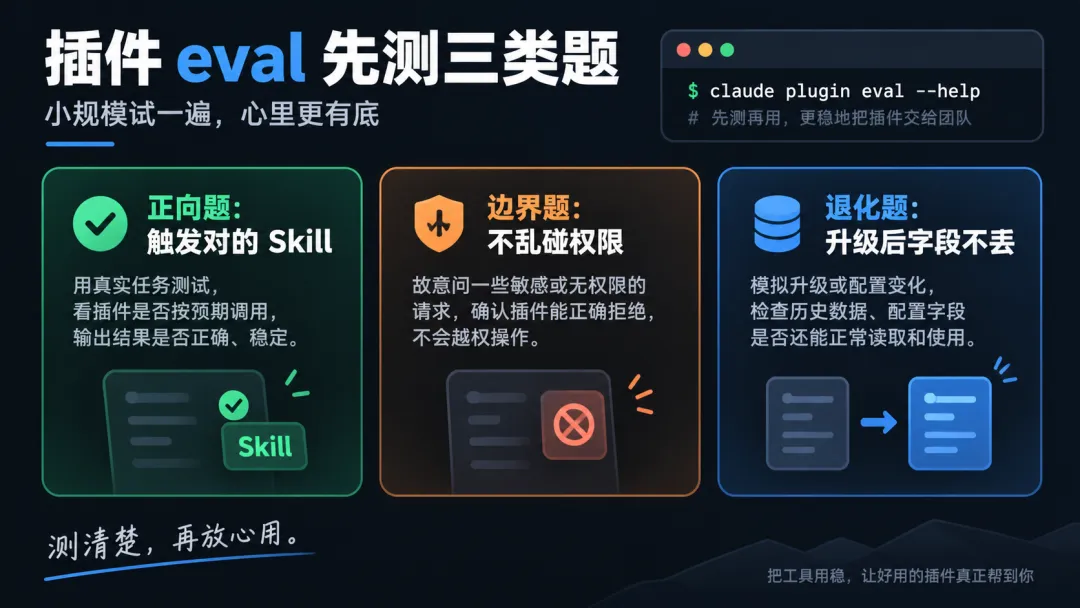
下面这套不是官方教程,而是基于公开信息和 Agent 工作流经验整理的最小路径。目标只有一个:让插件升级前先跑出一份能看的报告。
先升级并确认版本。运行 claude --version,确认至少是包含claude plugin eval的版本;如果你刚遇到只读 git 命令频繁弹权限,也顺手升到 v2.1.270 或更新版本。
给插件挑 3 个真实场景。不要写“你好,请介绍自己”这种题,没意义。挑代码审查、文档生成、数据检查这类你每天真的会用的任务,每个场景写清输入、期望输出和不能碰的边界。
跑一次 claude plugin eval。先用claude plugin eval --help看参数,再按插件目录跑一遍。重点不是分数多漂亮,而是 HTML 报告里有没有暴露“触发错 Skill、缺字段、乱改权限”的问题。
把报告留给人看。JSON 适合机器比对,HTML 适合团队评审。我的建议是第一次别急着进 CI,先让插件作者和一个真实使用者一起看报告,争论 10 分钟,通常比在群里吵“这个插件好不好用”有效。
固定升级前检查。Claude Code 升级、插件改 prompt、MCP server 换版本、output style 调整之前,各跑一遍同一套题。只要结果退化,就先回滚插件配置,而不是让所有人带着坏体验上班。
这 5 步最适合插件作者、团队工具维护者、以及已经把 Claude Code 接进日常开发的人。只偶尔让 Claude Code 改一两个脚本的个人用户,不用一上来搞得这么正式。工具是为人服务的,不是为了让你给工具写绩效考核。
这件事对 Skill 尤其重要
Skill 很容易让人产生一个错觉:只要 SKILL.md 写得够清楚,Agent 就会一直稳定照做。
但实际使用里,变量太多了。Claude Code 自己会升级,插件会新增工具,团队会改权限策略,用户也会在半路插一句“顺便帮我改一下”。这些变化叠在一起,最后出问题时你很难判断是 Skill 写坏了、模型理解偏了,还是某个工具返回格式变了。
plugin eval 的意义就在这里。它不是保证插件永远正确,而是让你有一个固定参照物:同一批任务,昨天能过,今天为什么不过。
我会特别给三类 Skill 加 eval:一是会读写文件的,二是会调用外部系统的,三是会产出固定格式报告的。它们一旦跑偏,影响的不只是答案好不好看,而是可能把后续自动化也带歪。
至于 /output-style,我会把它和 eval 放在一起看。输出风格听起来像“语气设置”,但对团队来说,它会影响报告字段、行文长度、是否适合贴到工单。你可以给同一套 eval 跑两种 output style,看哪一种更稳。这比开会讨论“大家喜欢简洁点还是详细点”省事多了。
别把小修复看小了
v2.1.270 修的只读 git 权限回归也值得一提。它看起来很小,但对 Agent 会话很关键。
很多插件和 Skill 都会让 Bash 跑 git status、git diff、git log 这类只读命令,用来判断当前改了什么、风险在哪。如果只读命令在长会话里突然要求权限,Agent 的节奏就会被打断,自动化也更容易停在半路。
所以今天这篇的重点不是“Claude Code 又多了多少功能”,而是它正在补一块很工程化的拼图:插件要能测,输出要能控,只读命令别乱拦,长会话恢复别把上下文搞丢。
如果你已经开始给 Claude Code 装插件,我今天会做的最小动作是:挑一个最常用插件,写 3 道 eval 题,跑出第一份 HTML 报告。先别追求自动化上天,先让自己知道它到底稳不稳。
工具能不能长期留下,往往不取决于第一次演示有多惊艳,而取决于升级三次之后它还听不听话。
资料与说明
Anthropic Claude Code 官方 GitHub Releases Claude Code v2.1.270 release Claude Code v2.1.269 release Anthropic Claude Platform Docs OpenAI API Changelog Gemini API Release Notes DeepSeek API Docs
核对日期:2026 年 9 月 15 日。本文基于公开 release notes 和文档整理,属于实操建议框架;具体命令参数、报告字段和插件目录结构,以你本机 claude plugin eval --help 与官方当前版本为准。