ARTICLE · 1014043
【AI制药-测评基准】深度解析英矽智能 DDB‑O3DC 基准平台:制药行业的“尺子工程”
深度解析英矽智能 DDB‑O3DC 基准平台:AI制药行业的“尺子工程”
时间线:2026‑07 ddb.insilico.com上线;8 月 4 日组建基准联盟,披露单个候选药物从立项到 PCC 约产生 1200 个基准点;8‑24 O3DC(o3dc.org)正式发布,收录 129 个基准,覆盖 10 大类别,社区可提交、挑战、修订条目。 |
一、行业背景:为什么必须造这把尺子
AI 制药长期存在 “跑分与现实脱节” 的核心矛盾:
1.基准分数幻觉:很多公开基准存在数据泄露、数据集偏置,模型刷出高分,但进入湿实验完全失效;典型案例 DUD‑E 虚拟筛选基准,模型靠配体特征即可拿高分,并不学习蛋白‑配体真实相互作用。
2.单点任务陷阱:现有基准大多是孤立任务(亲和力预测、ADMET、逆合成)。单点优秀≠ 端到端药物研发能力。一个完整 PCC 项目,靶点、生物学、化学、合成、成药性、临床风险是连续决策链,每一步都会累积错误。
3.基准缺陷埋藏于论文讨论区:大量基准的漏洞、局限、批评散落在文献,没有统一检索入口,科研人员继续盲目引用有缺陷的基准,形成行业负循环。
4.大模型时代的新问题:通用大模型涌入药物研发,没有统一标尺区分“科学推理能力” 和 “背诵训练集记忆”。欧盟 JRC 在 2026‑08 报告明确结论:基准分数不能直接证明工程落地就绪度。
Alex Zhavoronkov 核心判断:基准定义行业认为什么叫进步,如果基准本身是错的,整个行业的前进方向就会扭曲。英矽智能的解法不是做一两个数据集,而是两层平台:DDB 是测评执行引擎;O3DC 是基准元数据库 + 开放联盟。
二、平台架构:DDB 与 O3DC 分工、1200 个基准的真实含义
2.1 两大平台定位对比
项目 | ddb.insilico.com(DDD‑BaaS,商业测评服务) | O3DC o3dc.org(开放联盟元索引) |
性质 | Benchmark‑as‑a‑Service,可执行测评服务 | 社区 curated 基准目录,不跑模型,只做元数据管理 |
核心产出 | 模型标准化得分卡,支持 API 接入大模型 | 129 个基准元数据,记录维护方、仓库状态、已知缺陷(Caveat) |
数据来源 | 清洗公开数据集 + 英矽内部真实项目 OOD 分布外数据 | 汇总全球 15 个联盟 / 项目的基准资源,社区可提交、挑战、修订条目 |
套件组成 | ①Drug Discovery Foundations(300 + 基础测评)②Drug Candidate Essentials(端到端候选药物测评) | 10 大类:分子性质、对接、结合亲和力、生成设计、逆合成、靶点识别、临床预测、AI Agent 评估等 |
访问模式 | 机构可付费测评,可生成公开排行榜或内部保密报告 | 完全开放免费,任何人查阅、提交修订 |
关键概念:一个候选药物约 1200 个基准,不是 1200 套独立数据集。指从靶点假设→苗头→优化→PCC 提名整条研发链路,需要在生物学、化学、成药性、合成、临床风险等节点累计约 1200 次校验判断,每一次判断对应一个基准校验点,是端到端项目的校验粒度,不是公开数据集数量。 |
2.2 DDB 内部两大测评套件拆解
1.Drug Discovery Foundations(基础套件)300 + 测试用例,以深度去污的公开数据集 + 自有 OOD(分布外)数据集为主。评估模型基础能力:疾病生物学推理、分子性质预测、逆合成、基于结构分子设计、临床风险预判。
OOD 数据集是核心壁垒:用训练集完全没有见过的样本,规避 “背题库刷分”。支持任何兼容 Chat Completions API 的大模型接入自动测评,输出统一对比得分卡。 |
2.Drug Candidate Essentials(候选药物核心套件)行业少有的端到端仿真研发测评,基线来自英矽多个走完临床前的真实自研项目。不考孤立分子,而是模拟完整项目连续决策:靶点优先级、苗头筛选、多轮分子优化、合成可行性、ADMET 淘汰、PCC 提名。检验 AI 能否在真实项目约束下做连贯决策,而不是只输出漂亮分子结构。
2.3 O3DC 独特创新:给基准附上 “已知缺陷 Caveat”
这是区别于其他所有基准目录的核心设计:每一条基准条目,除维护者、代码仓库、更新状态(自动轮询 GitHub 判断仓库是否停止维护)之外,专门记录基准自己文档不会写的偏见、漏洞、已发表批评。例:DUD‑E、PDBbind‑CASF、PoseBusters 相关缺陷直接挂载在条目旁,研究者查阅时第一时间看到风险,而不是读完论文才发现坑。同时开放社区机制:任何人可以挑战现有条目,提交新基准,联盟审核入库。
2.4 完整业务漏斗逻辑(技术 + 商业)
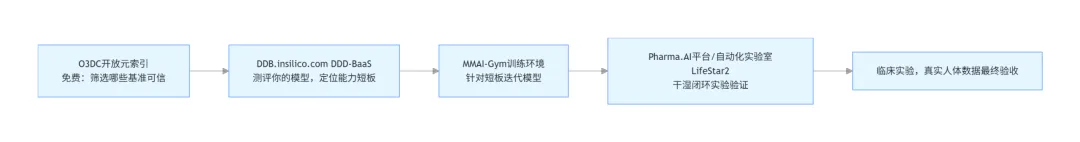
越往下越靠近真实研发,从免费开放逐步过渡到付费服务。O3DC 不直接产生收入,作用是建立行业信任,筛选有真实模型研发需求的机构导入下游业务。 |
三、核心价值:解决 AI 制药三大痛点
痛点 1:大模型 “科学幻觉” 难以量化评估
传统测评很多是训练集内样本,大模型靠记忆拿高分。DDB 大量使用分布外 OOD 数据,模拟真实研发遇见从未见过的靶点、分子,检验真正推理能力,而不是记忆能力。Alex 公开内部测试结果:主流前沿大模型在 75% 以上自研内部基准上不及格。
痛点 2:单点基准无法评价端到端药物发现
过去评价模型:分子生成 FCD、对接 RMSD、ADMET AUC。但药物研发不是竞赛做题。同一个模型,分子生成指标 SOTA,但靶点优先级全部错,整个项目直接报废。DDB 的 Candidate Essentials 套件尝试模拟连续决策链,评估模型多步骤累积表现,更贴近药企真实项目逻辑。
痛点 3:行业基准碎片化,缺陷信息散佚
O3DC 把分散全球论文、联盟的基准收拢,并且强制附带已知缺陷,改变 “只看跑分,不问基准质量” 的科研文化。同时对标同期 BEACON 联盟,形成全球两套主要 AI 制药基准基础设施阵营。
四、平台不可回避的局限(批判性视角)
1.私有数据壁垒:DDB 高价值 OOD 与端到端仿真基线来自英矽内部项目,外界无法完全复现全部测试集。测评服务本身是商业产品,完整大规模测评需要机构付费,公开排行榜只是部分子集。
2.“1200 个基准点” 是项目校验粒度,不等于可公开数据集。绝大多数校验点依托企业内部未公开实验失败样本,无法全部开放给社区,O3DC 只能收录其中可公开的 129 个基准。
3.仿真≠ 真实湿实验:无论 DDB 测评得分多高,都只是计算机仿真评估,不能替代 LifeStar 自动化实验室湿实验,更不能替代动物、临床。平台本身反复强调:基准分数只是前置筛选,实验才是金标准。
4.社区治理风险:O3DC 宣称开放社区,但联盟发起方是英矽智能。未来会面临:如何平衡商业公司利益和中立性、如何处理商业机构提交的自家基准、如何避免条目被商业营销裹挟,这套治理机制还需要时间验证。
5.生物本身的不确定性:即使真实历史项目作为基线,生物学本身存在不可复现,仿真测评无法完全复刻真实生物学噪声。
五、对行业的战略意义
1.范式转变:从“刷 SOTA 分数” 转向 “评估研发就绪度”此前 AI 制药论文普遍优先报单点指标;DDB‑O3DC 体系推动行业问新问题:模型在分布外样本表现如何?端到端项目链能否连续正确决策?基准本身有什么缺陷?
2.给通用大模型进入制药设立门槛通用大模型不断宣称进军药物研发,DDB 提供标准化 API 测评接口,任何模型都可以跑同一套题库,减少 PPT 宣传,提供可对比的量化证据。
3.基准基础设施竞赛正式开启2026 成为 AI 制药基准大年:BEACON 联盟、欧盟 JRC、英矽 O3DC‑DDB 多条线并行。行业共识:AI 制药最大瓶颈不再是模型架构,而是评估体系与高质量、包含失败案例的数据集。
4.与英矽自身管线互为印证英矽手上拥有全球推进最快的 AI 原生药物 Rentosertib(ISM001‑055)III 期临床。平台的逻辑闭环:自己踩过真实研发的坑,把坑转化成基准,反过来测评所有 AI 模型,包括自己的模型。Alex 的观点:批评 AI 泡沫最好的方式,是手里同时有临床管线,同时有一套严格的测评标尺。
六、总结
DDB‑O3DC 不是一套新的分子数据集,而是一套完整的评估元基础设施。
•O3DC 负责治理:盘点全球基准,记录每个尺子本身的瑕疵,防止行业拿错尺子;
•DDB 负责执行:用真实项目衍生的 OOD 与端到端任务,实际度量 AI 模型距离真实药物研发还有多远。
“1200 个基准点” 揭示残酷现实:把一个靶点推进到临床前候选,不是几次漂亮分子生成,而是上千次连续校验与取舍。基准永远不能替代湿实验与临床,但可以提前筛掉大量幻觉模型,降低整个行业试错成本。
风险提示:平台仍处于早期阶段,社区治理、数据集复现性、仿真与真实实验的鸿沟仍有待更多实践检验。 |
生物智能:在生物先进产业场景中构建“状态感知-实时认知-自主决策-精准执行-学习提升”的生物科学智能(NeuroAI);实现生物产业转型升级、DT驱动业务、价值创新创造的产业互联生态链。
生物产业+物理AI=生物智能
产业智能官:NeuroAI
加入知识星球“生物智能研究院”:自动化生物铸造厂OT技术(自动化+机器人+工艺+精益)和新一代IT技术(云计算+物联网+区块链+大数据+人工智能)深度融合,在场景中构建“状态感知-实时认知-自主决策-精准执行-学习提升”的生物科学智能(NeuroAI);实现产业转型升级、DT驱动业务、价值创新创造的产业互联生态链。
版权声明:产业智能官(ID:NeuroAI)发表的文章,除非确实无法确认,我们都会注明作者和来源,涉权请联系协商解决,联系、投稿邮箱:wolongzy@qq.com