夜雨聆风学习资料网

ARTICLE · 1014097

AI拍出来的「抑郁」:App里78%走向痊愈,开发者接口只有14%
AI拍出来的「抑郁」:App里78%走向痊愈,开发者接口只有14%
精读 · J Med Internet Res · 混合方法研究 · CC BY 4.0
AI拍出来的「抑郁」:App里78%走向痊愈,开发者接口只有14%
向 Sora 2 只输入一个词——「Depression」,不许加任何修饰。Beth Israel Deaconess 医疗中心数字精神病学部用这个极简提示词各生成了 50 条视频(消费版 App 50 条 + 开发者 API 50 条),结果令人坐直:App 版 78%(39/50)讲了一个「从抑郁走向痊愈」的完整故事,API 版只有 14%(7/50);App 版视频随时间持续变亮(亮度斜率 2.90/秒 vs -0.18/秒,Cohen d=1.59),运动量是 API 版的 3 倍。同一个模型,换一个入口,拍出来的「抑郁」是两种病、两种人生。
文献:Depictions of Depression in Generative AI Video Models: Mixed Methods Study of OpenAI’s Sora 2J Med Internet Res 2026;28:e95682 | DOI: 10.2196/95682作者:Flathers M、Smith G、Herpertz J、Zhou Z、Torous J(通讯)——Beth Israel Deaconess 医疗中心数字精神病学部等;无专项资助
一句话结论:Sora 2 没有发明新的抑郁视觉语法——它把人类文化里几百年的忧郁意象(暗室、雨窗、灰连帽衫、低垂的视线)压缩重组;但真正决定用户看到什么的,是模型外面的那一层:消费版 App 的产品层(内容审核+信息流逻辑)把 78% 的输出推向「痊愈叙事」,而绕过产品层的开发者 API 86% 停留在静止的抑郁状态。AI 生成的心理健康内容反映的是训练数据和平台设计,不是临床知识——患者可能在最脆弱的时候刷到这些视频,临床医护需要知道这件事。
摘 要
背景与目的:生成式 AI 视频模型已能批量生产心理健康主题内容,#mentalhealth 标签在 TikTok 单平台播放量超 440 亿次;但这类系统如何表征「抑郁」几乎没有实证。研究考察 Sora 2 对无限定提示词「Depression」的默认输出,并区分「底层模型」与「消费产品」两个访问点。方法:探索性混合方法。2025-11-21 至 28 单一窗口内,用孤立的单词提示「Depression」各生成 50 条视频(App:10 秒 720p 竖屏;API:12 秒 720p),共 100 条语料。质性:2 名编码者按 6 维度(叙事弧/环境/物件/人物画像/姿态/备注)定向内容分析,Cohen κ 检验一致性(叙事弧 0.71、独处 0.94、姿态 0.89;不足者剔除)。定量:4 域 28 项计算特征(视觉美学/音频/语义/时序动力学),Welch t 检验 + Benjamini-Hochberg FDR 校正,Cohen d 效应量。结果:App 版 78%(39/50)含走向希望/解脱的恢复弧,API 版仅 14%(7/50)。App 版亮度随时间上升(斜率 2.90 vs -0.18/秒,d=1.59,q<.001),光流(运动量)约为 API 版 3 倍(0.35 vs 0.11 像素/帧,d=2.07),场景切换 3.10 vs 0.76 次。两通道共同收敛于狭窄视觉词汇:坐姿 94%、低垂视线 93%、连帽衫 194 次、窗户 148 次、雨 83 次;人物 88% 为 20-30 岁年轻人、98% 独处。抑郁期词汇围绕重量与困住(heavy/drowning/room),恢复期反转为光与呼吸(light/breath),亮度较恢复点前 +26.6%(d=0.68),67% 的恢复视频视线由垂转抬。性别分布随入口反转:App 偏男性(68%),API 偏女性(59%)。结论:Sora 2 不发明新视觉语法,而是压缩重组文化意象;平台层约束实质性地塑造了哪些叙事能到达用户。临床医护应意识到:AI 生成的心理健康视频反映训练数据与平台设计而非临床知识,患者可能在脆弱期接触这类内容。
一为什么研究这个:AI 视频正在成为心理健康的第一入口

心理健康内容已经是短视频平台的顶流:#mentalhealth 标签在 TikTok 单平台播放量超过 440 亿次,约六成美国青少年每天访问 TikTok。而 2025 年 9 月发布的 Sora 2 把「生成一条以假乱真的视频」的成本压到了一句话——上线 72 小时,Sora App 冲上 iOS 下载榜第一(超 16.4 万次下载),12 月还宣布与迪士尼合作引入 200 多个角色。当用户(包括正在经历抑郁发作的人)搜索「抑郁」时,AI 生成的视频正在成为他们信息环境的一部分:这些画面可能强化其体验、正常化或污名化它,也可能内置一套关于「康复」的隐含剧本。

这篇研究更聪明的一点是方法论自觉。作者指出,现有临床 AI 研究经常把「模型」当研究对象,却混淆了两样东西:底层模型(base model)和构建在它之上的消费产品。你在 Sora App 里输入提示词,中间隔着提示词处理、UX 约束、安全过滤、信息流策展等一整层产品管线;而开发者通过 API 访问的是接近裸模型的通道。只研究产品,看到的是「用户会遇到什么」;只研究模型,看到的是「训练编码了什么」——两边对照,才能看见公司为「抑郁」这类敏感话题装了什么样的隐形方向盘。

二研究怎么做:一个单词、100 条视频、28 项特征

极简提示词是核心设计:所有视频只用孤立的单词「Depression」,无任何限定词、语境或提示工程。作者的理由很妙——「Depression」一词本身歧义(临床心境障碍/口语情绪/地形凹陷/经济萧条), elaborate 的提示词会把你的解释强加给模型;而单词提示把解释劳动全部推回给模型,输出的每一个视觉选择都只能来自训练数据或产品层的引导——这让它成为探测模型默认表征的更灵敏探针。结果也确实如此:100 条视频无一例外全部拍了情感意义上的抑郁,没有一条拍成经济萧条。

生成与质控:2025-11-21 至 28 单一窗口(防模型更新混淆),App 版 50 条(10 秒 720p 竖屏,全新无历史账号)+ API 版 50 条(12 秒 720p,sora-2 端点)。质性段:2 名编码者独立对全部 100 条按 6 维度编码(叙事弧/环境/物件/人物画像/姿态状态/备注),Cohen κ 一致性:独处 0.94、性别 1.00、姿态 0.89、环境 0.91、叙事弧 0.71——不达标的维度(面部表情 0.49、种族 0.53、社会经济地位 0.20)直接剔除,不用,这个「κ 不达标就扔」的纪律值得所有内容分析研究学习。

定量段:4 域 28 项计算特征——视觉美学(亮度/饱和度/色温/纹理,逐秒采样)、音频(音量/音高/频谱质心,librosa)、语义(Whisper 转录 + VADER 情感 + 基于概念隐喻理论的明暗词典 + 第一人称代词比)、时序动力学(Farnebäck 光流/场景检测)。统计全部走 Welch t 检验 + Benjamini-Hochberg FDR 校正,效应量 Cohen d。研究不涉及人类受试者(分析对象是 AI 生成内容),无需伦理审批。

三核心发现:78% vs 14%,平台层那只看不见的手

主结果一张表看完——同一个模型,只换访问入口:

特征(App vs API,各 n=50)
消费版 App
开发者 API
效应量与显著性
恢复叙事占比
78%(39/50)
14%(7/50)
—
亮度斜率(每秒)
+2.90(SD 2.43)
-0.18(SD 1.24)
d=1.59,q<.001
光流运动量(像素/帧)
0.35(SD 0.15)
0.11(SD 0.07)
d=2.07,q<.001
场景切换次数
3.10(SD 1.88)
0.76(SD 1.42)
d=1.39,q<.001
音频音高(Hz)
115.5
148.9
d=-0.92,q<.001
第一人称代词比例
0.04
0.08
d=-0.78,q=.001
性别倾向
偏男性(68%)
偏女性(59%)
—
Welch t 检验 + Benjamini-Hochberg FDR 校正(28 项特征)。据原文 Table 1 与结果节整理(CC BY 4.0)。

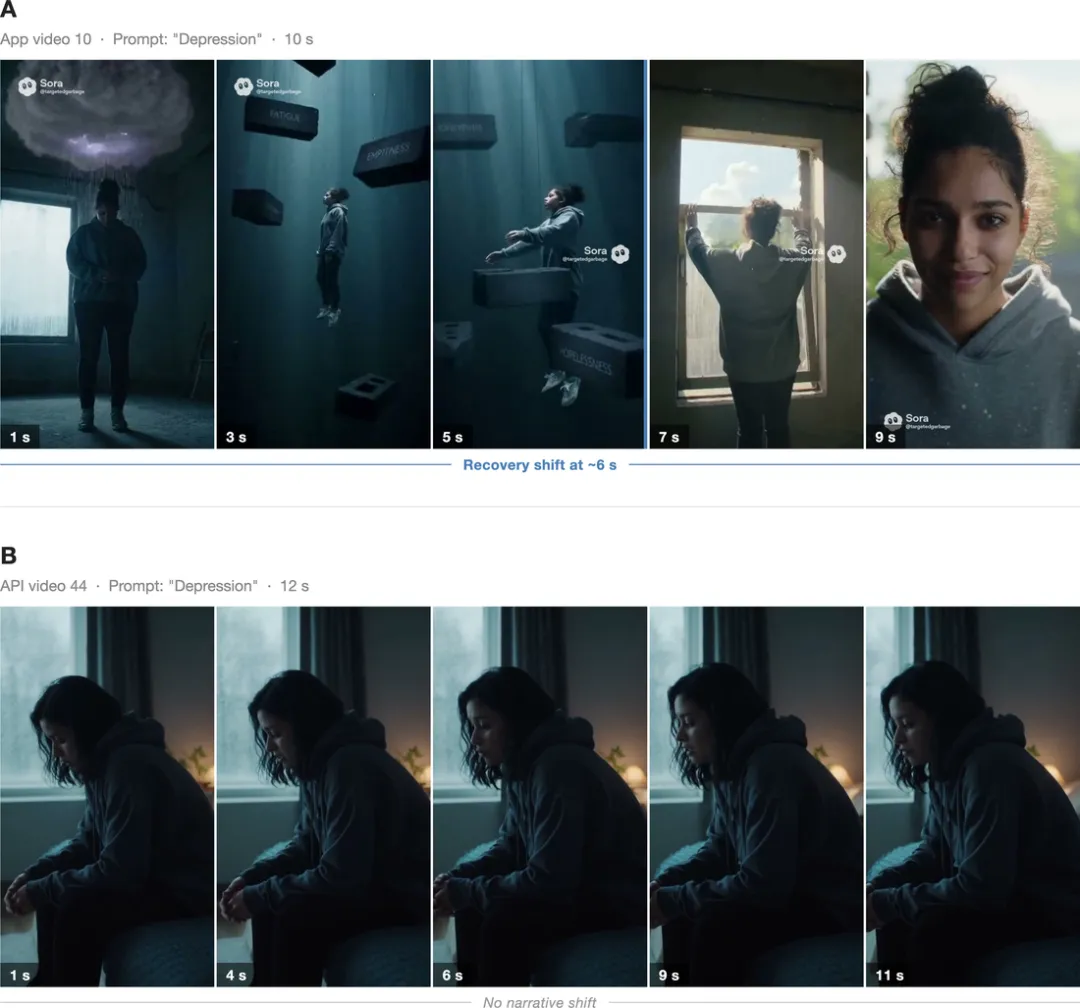
数字背后是两种截然不同的「抑郁剧本」。App 版是治愈系短片:从黑暗房间和头顶的个人暴雨云开始,漂浮的方块标注着「疲劳」「绝望」,然后人物转身面向亮窗,结尾走进阳光里微笑——一条标准的恢复弧,_recovery shift_ 平均发生在第 6 秒。API 版是静态困局:穿灰色连帽衫的人物坐在昏暗卧室的床边,12 秒里姿态、光线、环境几乎不变。原文 Figure 5 的对比帧一目了然:
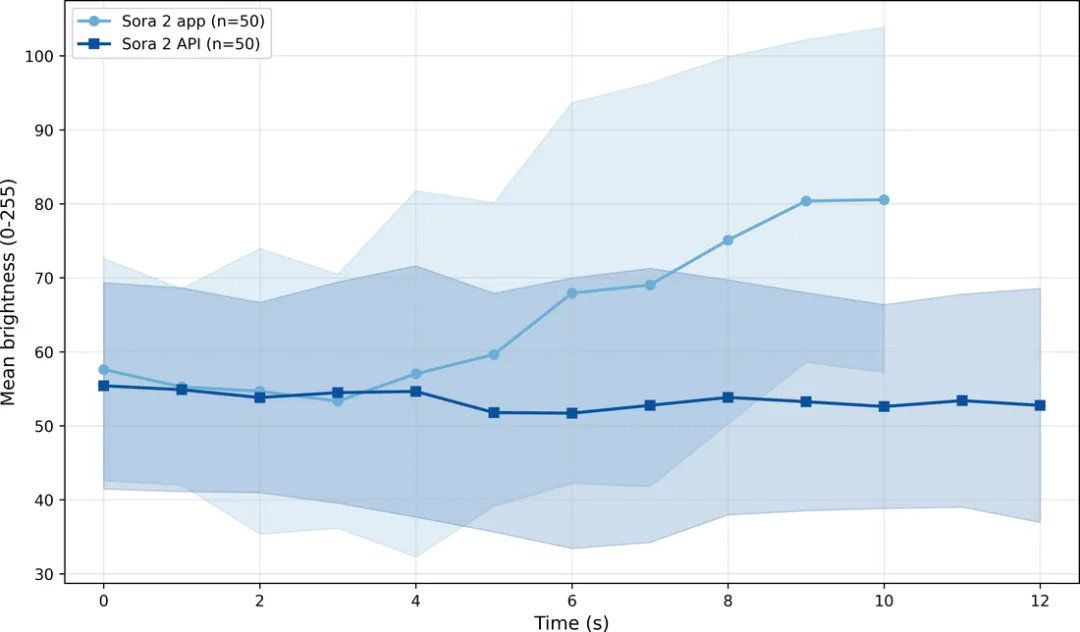
亮度轨迹把这种分化量化到了秒级(原文 Figure 2):App 版开局亮度与 API 版相当,然后一路爬升(斜率 +2.90/秒),API 版几乎水平(-0.18/秒),效应量 d=1.59。
运动与剪辑的差异更夸张(原文 Figure 3):App 版光流是 API 版的 3 倍(d=2.07,全篇最大的效应量),平均 3.1 次场景切换 vs 0.76 次——到视频结尾,App 观众平均已看了约 4 个场景,API 观众不到 2 个。
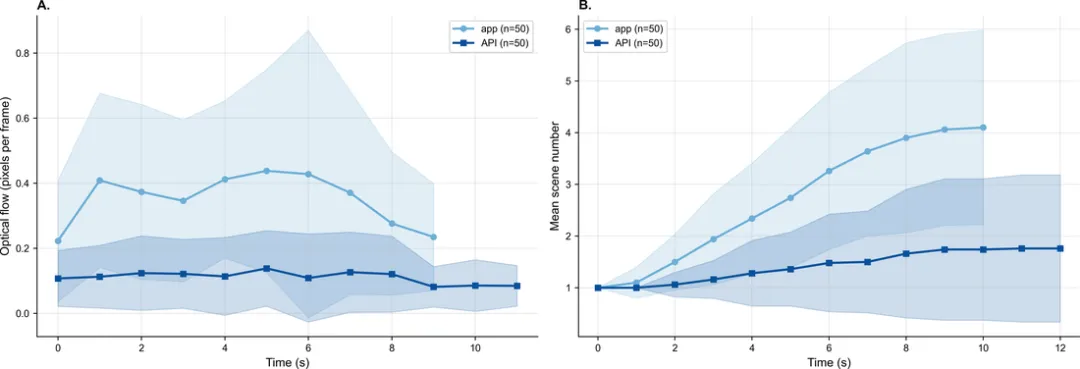
为什么会这样?作者诚实地表示无法归因——Sora 的审核管线是专有黑箱。但可以确定的是:Sora App 的社区准则明文禁止「被视为主张抑郁或描绘自残」的内容,且信息流按参与度优化——要么是显式安全护栏,要么是平台动态偏爱「叙事有闭环」的内容,两者必居其一(或兼有)。无论机制如何,产品层引入了强叙事约束,「康复」成了安全且可读的默认终点。

四两百年忧郁意象的 AI 复读:连帽衫、雨窗与低垂的视线

如果说叙事弧是平台层的作品,那么视觉词汇就是文化层的沉积。100 条视频惊人地收敛:坐姿出现在 94% 的视频里,低垂视线 93%,人物 98% 独处,88% 是 20-30 岁的年轻人;出现最多的物件是连帽衫(194 次)、窗户(148 次)、床(114 次)、雨(83 次)、灯(59 次)。卧室是压倒性的主场景,恢复片段才出现屋顶、山顶、桥这类「高处户外」。这套语法不是 Sora 发明的——从文艺复兴寓言、启蒙时代的精神病画像到现代影视,「退隐的身影+昏暗室内+雨打窗棂」就是西方文化两百年来的忧郁成像传统。

语言学证据同样整齐。转录文本的词频(原文 Figure 4)聚成四个隐喻簇:

隐喻簇
代表词(词频)
解读
重量与压迫
heavy(22 次)、heavier(10)、pressing、chest、weight
「重」是抑郁最稳定的概念隐喻——语言学与影像学在此重合
水与困住
underwater、drowning(5)、room(8)、stuck
溺水/水下的失重感与「房间」的封闭感成对出现
天气与黑暗
rain(7)、storm(7)、night、world
雨和风暴是病中片段的环境标配(雨共出现 83 次)
光与呼吸(恢复期)
light(12)、breath(5)、clouds(5)、small(7)、cracks
恢复期词汇反转:变轻、变小、透气——「裂缝透光」的意象
100 条视频转录文本(Whisper)词频与恢复点前后差分分析。据原文 Figure 4/6 与结果节整理(CC BY 4.0)。

更妙的是恢复点的「词汇反转」分析:把 46 条含恢复弧的视频按编码的恢复时间戳切成前后两段——

物件/环境/姿态
恢复点之前
恢复点之后
床
32/46(69.6%)
1/46(2.2%)
窗户
32/46(69.6%)
8/46(17.4%)
雨/雨滴
23/46(50.0%)
1/46(2.2%)
浴室/窗帘
15.2% / 26.1%
0% / 4.3%
阳光/日出
3/46(6.5%)
17/46(37.0%)
鸟
1/46(2.2%)
7/46(15.2%)
高处户外(屋顶/山顶/桥)
5/46(10.9%)
8/46(17.4%)
视线方向
低垂为主
67%(30/45)由垂转抬
46 条含恢复弧的视频,按编码的恢复时间戳做前后差分。据原文结果节整理(CC BY 4.0)。

视觉特征同步反转:恢复点后亮度 +26.6%(d=0.68)、饱和度 -13.2%、色彩丰富度 +10.5%。原文 Figure 6 把这套「病中→恢复」的物件/环境/词汇/姿态差分画成一张总图:
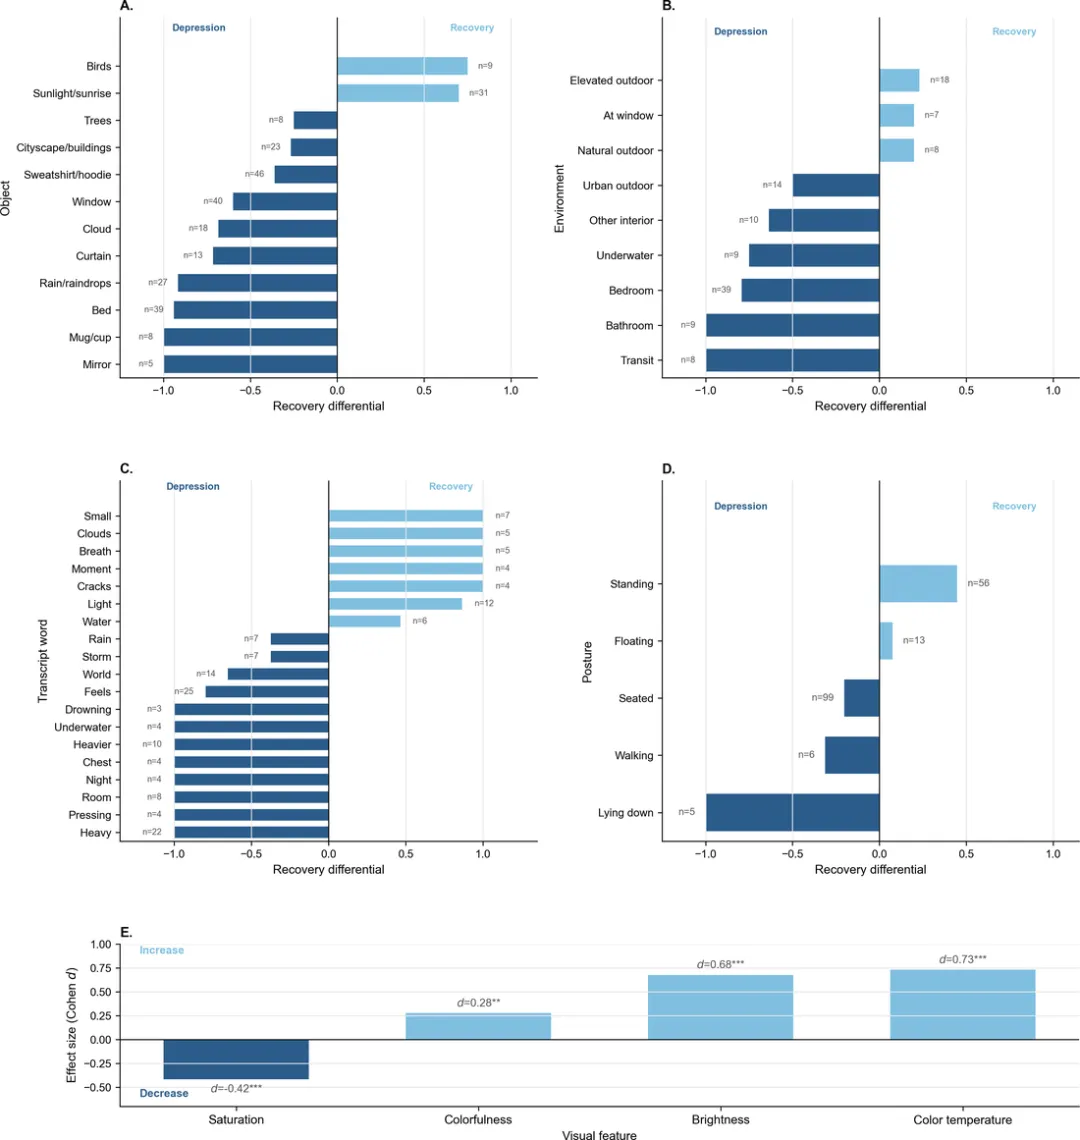
 gender 的入口反转值得一提:App 版 68% 是男性人物,API 版 59% 是女性——连「谁来演抑郁」都随入口而变。推测与默认参数、审核过滤或训练采样有关,原文未深究,但这个现象本身对「AI 输出的代表性审计」是个现成的选题钩子。

五对护理科研与临床实践:五个直接可用的接口

接口一:患者数字环境评估应写进护理评估。护士是与患者沟通时间最长的专业角色,也是最可能第一时间了解到「患者最近在刷什么」的人。对抑郁/焦虑患者的数字素养教育与信息环境评估(他们从短视频里获得的「康复剧本」是否符合循证路径),是精神心理健康护理学的现成干预切口。

接口二:「恢复叙事偏置」是健康传播研究的天然实验场。78% 的痊愈结局是平台认为安全、易传播的叙事,不是临床事实——真实抑郁康复是中长期的、非线性的。「AI 生成内容如何塑造公众康复预期」可用本篇的极简提示词法 + 内容分析框架直接复刻到中文平台(可灵、即梦、通义万相),对比中外平台的叙事偏置。

接口三:「模型 vs 产品」双层框架可直接迁移到护理 AI 评测。本篇最大的方法学贡献是证明同一模型在 App 与 API 两个入口行为系统性不同。评测任何护理 AI 工具(语音记录、交班助手、患者教育生成器)时,都应区分「模型默认行为」与「产品层调校后的行为」——采购决策测的是后者,科研复现需要对齐前者。

接口四:AI 生成内容的代表性审计是空白选题。本篇 100 条视频里人物 88% 是 20-30 岁、98% 独处——老年抑郁、产后抑郁、儿童抑郁在 AI 的视觉词典里近乎不存在。「主流视频生成模型对不同人群抑郁表征的覆盖率与刻板印象审计」,一张 GPU 都不需要,纯内容分析就能发高质量论文。

接口五:护理教育素材的合规提示。越来越多护理教学开始用 AI 生成演示视频,本篇提醒:生成的「患者形象」继承的是影视刻板印象而非临床观察——用 AI 生成的抑郁患者演示视频教护生识别症状,可能在无声中强化污名。教学素材审核清单里应加一条「AI 生成内容的文化刻板印象审查」。

六局限与冷静阅读

其一,单平台单提示词。结论只对 Sora 2 与单词「Depression」负责,不能外推到 Veo 3、Runway 或其他精神疾病主题。其二,时长混杂。App 默认 10 秒、API 默认 12 秒,作者用逐秒斜率缓解但无法根除——恢复弧「更常出现」与「更快出现」在 10 秒片里是绑定的。

其三,机制不可观测。审核管线专有且不透明,App-API 差异只能确认「存在产品层效应」,无法定位是哪道过滤器。其四,没有人。研究分析的是输出内容,没有做人类感知实验——「观众看后会怎样」仍是开放问题。其五,编码者未盲法。两个入口界面肉眼可辨,可能引入期望效应。每臂 50 条是基线观察规模,效应量解释需谨慎——作者在局限节逐条自曝,这份透明本身就是同类研究的范本。

七关键信息一览

把全文压缩成一张「带结论」的速查表——每行回答一个问题:这个发现,对关注「AI×心理健康内容」的你意味着什么。
关键信息
事实与数据
对实践的含义
78% vs 14%
同一模型两个入口:App 版 39/50 恢复叙事,API 版 7/50;App 亮度持续爬升、运动量 3 倍
「AI 怎么拍抑郁」的答案一半在模型里,一半在平台里——评估 AI 生成内容必须区分产品层与模型层
狭窄的视觉词汇
坐姿 94%、低垂视线 93%、连帽衫 194 次/窗 148/雨 83;人物 88% 是 20-30 岁、98% 独处
AI 没有发明新意象,只是高保真复读文化刻板印象——代表性偏差会被规模化放大
恢复叙事的平台偏置
App 78% vs API 14%;机制不明(可能是内容审核,也可能是信息流偏好叙事闭合),作者明说无法归因
「痊愈结局」是平台认为安全/易传播的叙事终点,不是临床事实——患者可能据此形成错误的康复预期
隐喻系统原样继承
病中=heavy/drowning/room(重量、溺水、房间),恢复=light/breath/small;亮度 +26.6%(d=0.68)
概念隐喻理论预言的「抑郁=重/暗/下」在 AI 视频里全数复现,可作为健康传播研究的天然语料
方法学样板
单词极简提示法:不给上下文,把解释权全部交还给模型的编码联想;28 特征 FDR 校正;κ 剔除制
「模型 vs 产品」双层分析框架可直接迁移到护理 AI 工具评测(App 版护理助手 vs API 版行为差异)
证据边界
单平台单提示词;App 10 秒 vs API 12 秒存在时长混杂;专有审核管线不可观测;未做人类感知实验;每臂 n=50 为基线观察
结论当「探索性基线」用;效应量解释需谨慎,作者已逐条自曝局限
关键信息一览据原文结果与讨论节整理(CC BY 4.0)。
📚 完整版在 IMA「护理科研知识库」(免费订阅)
若需要获取文献原文或实时了解护理科研情报信息,欢迎免费订阅 IMA「护理科研知识库」,知识内容每日更新。
长按识别二维码,免费订阅
◈ 每日情报 + 科研选题,按学科归档◈ 文献精读系列持续更新◈ 溯源链接齐全,可一键回到原文
公众号内也可点击「阅读原文」直达知识库 →
🔗 原文全文(开放获取,CC BY 4.0,免费阅读)
https://doi.org/10.2196/95682(长按复制,浏览器打开)
本文所有数据均出自该原文(J Med Internet Res 2026;28:e95682,已经同行评审;研究内容为 AI 生成内容分析,不涉及人类受试者,无需伦理审批)。
📋 精读说明:本篇由 AI 辅助整理,所有定量数据、统计量、原文观点均来自 JMIR 官方 PDF 全文(J Med Internet Res 2026;28:e95682,经同行评审)。正文首图为原文首页截图(CC BY 4.0);图 2 至图 6 为原文 Figure 1、2、3、5、6 原图直接嵌入(CC BY 4.0);封面图为 AI 生成示意图;主表/隐喻表/恢复差分表据原文 Table 1 及结果节整理。「对护理科研与临床实践」相关段落属编者延伸推论,请以原文为准。
AI 的分数和患者的结局是两回事 I 护理科研
握力少掉近5公斤的差距:武大三中心II期RCT,把多学科康复装进App帮肿瘤患者扛住放化疗
别再问AI「结石患者不能吃啥」了:重庆团队把临床指南装进Prompt,30例实测大模型全面升级
让癌症患者一天打卡5次坚持6周:湘雅护理团队算出了这条依从率基线
#生成式AI#Sora2#抑郁#心理健康传播#内容分析#数字精神病学#护理科研

相关学习资料