ARTICLE · 1016637
供应商推私有化 AI?这5个问题帮你避开百万级坑
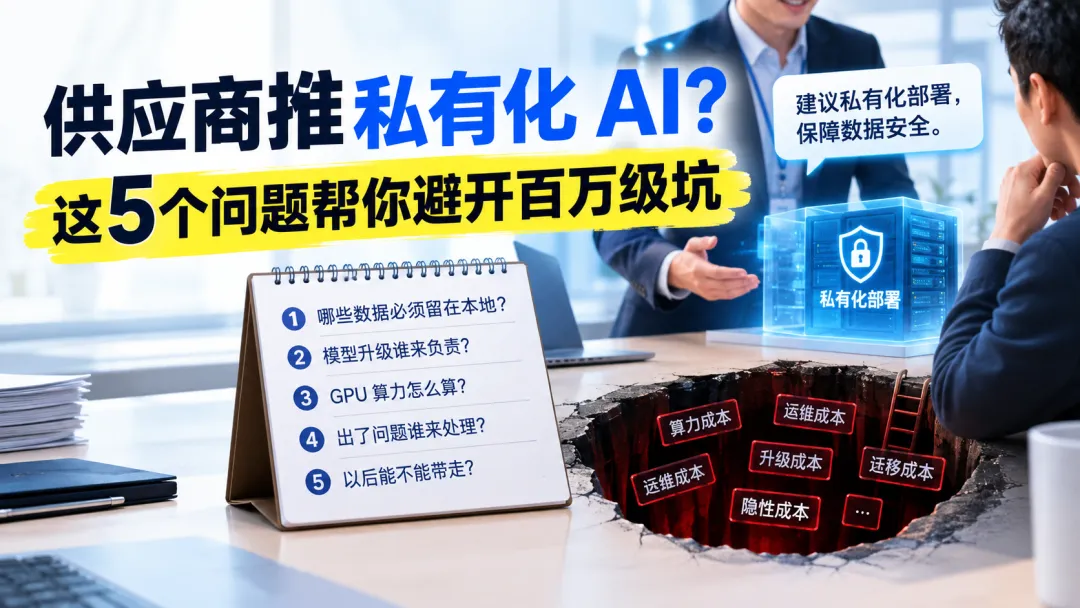
“这个场景涉及企业敏感数据,建议私有化部署。”
做企业 AI 项目,这句话我听过很多次。
尤其到了 Agent 采购阶段,供应商往往会很自然地把话题带到“私有化部署”上。
听起来没什么问题。
数据敏感,当然要重视安全。
但如果我是甲方,我不会马上问:“那私有化部署多少钱?”
我会先问供应商几个问题。
因为这些年做企业项目下来,我越来越觉得:
私有化部署不是一个“安全开关”,而是一个需要算账、需要权衡的架构选择。
很多企业真正吃亏的地方,不是私有化本身贵,而是一开始没把后面的账算清楚。
所以,如果供应商告诉我“这个项目建议私有化”,我通常会先问下面5个问题。
TITEL 0101 哪些数据必须留在本地?
这是我一定会先问的问题。
因为很多时候,供应商说的“数据敏感”,其实没有把数据进一步拆开。
比如客户身份信息、合同原文、交易数据、未公开的财务数据,这些当然需要重点管控。
但 Agent 运行过程中产生的东西,就不一定都属于同一个安全等级。
比如:
意图识别结果
任务拆解结果
工具调用参数
脱敏后的结构化数据
系统运行日志
这些数据是不是必须全部留在企业内网?
不一定。
更重要的是,很多 AI 场景本来就没有必要把原始数据直接交给大模型。
比如合同审核。
完全可以先在企业内部完成文档解析、敏感信息识别和脱敏,再把需要模型判断的信息交给模型。
再比如客服 Agent。
知识库可以留在企业内部,先完成检索,再把必要的信息交给模型生成回答。
这样一来,实际上就出现了另外一种架构:
敏感数据留在企业内部,模型服务和部分计算能力可以根据实际情况放到外部。
所以我通常会直接问供应商:
“这个场景里,哪些数据是绝对不能出内网的?哪些数据经过脱敏以后可以出去?能不能把整个数据流画出来?”
这个问题非常重要。
如果供应商连数据到底怎么流都没有分析清楚,上来就告诉你“全部私有化”,我反而会比较警惕。
因为这可能不是安全方案,而是最省事的方案。
TITEL 0202 私有化以后,模型升级谁负责?
这是很多企业签合同的时候不会问,但一年以后很容易开始头疼的问题。
云上的模型,今天和一年前可能已经不是一个能力水平。
但是私有化部署不一样。
供应商交付给你的模型,往往是某一个确定版本。
交付完成以后,模型不会自己升级。
于是一个很现实的问题就来了:
半年以后模型出了新版本,你要不要升级?
如果升级:
谁来升?
怎么升?
收费吗?
要不要重新做测试?
会不会影响现在已经跑起来的业务?
如果不升级:
那云上的模型能力越来越强,你的私有化模型是不是一直停在原来的水平?
尤其是 Agent 场景。
它不是简单的“模型能不能回答问题”,还涉及工具调用、流程编排、上下文处理、知识检索、输出稳定性等。
业务规则一变,原来的效果可能就不够用了。
所以我会继续问:
“交付以后,模型多久更新一次?模型升级由谁负责?升级一次多少钱?需要停机吗?如果半年以后业务规则发生变化,需要重新调优,这部分工作怎么算?”
这些问题,供应商如果没有明确答案,私有化的成本其实还没有算完。
TITEL 0303 GPU 到底是怎么算出来的?
到了这里,就开始涉及钱了。
也是私有化方案里非常容易被低估的一部分。
供应商给你报几张 GPU 卡,并不意味着这就是你未来生产环境真正需要的算力。
我更关心的是:
这个数字到底怎么算出来的?
比如现在做 POC,可能同时只有几十个人使用。
但真正上线以后,可能有几百、几千甚至更多用户。
而且 Agent 和传统应用不太一样。
用户问一个问题,背后可能发生:
一次模型调用、一次知识检索、几次工具调用,甚至多轮模型推理。
用户看到的是“一次请求”,后面可能已经跑了很多次计算。
所以我一般不会接受一句简单的:
“按照你们现在的用户量,配置4张卡就够了。”
我会继续追问:
“这个4张卡是按照多少并发算的?”
“按照什么模型算的?”
“平均请求和峰值请求分别是什么?”
“Agent平均一次任务会调用几次模型?”
“如果业务量增长一倍,需要怎么扩?”
这几个数字算不清楚,GPU 配置就只是一个报价。
而且还有一个经常被忽略的问题:
GPU买回来以后,大部分时间可能根本跑不满。
企业业务通常有高峰和低谷。
为了高峰买的卡,低谷的时候也在那里。
云上可以弹性扩缩,私有化的 GPU 却是你自己买、自己养。
所以不能只算“买几张卡多少钱”。
真正应该算的是:
三年下来,这套算力到底花多少钱。
TITEL 0404 出问题以后,谁来处理?
这个问题我会问得非常具体。
因为“提供运维服务”和“出了问题有人能把系统救回来”,是两回事。
Agent 上线以后,故障可能来自很多地方。
模型服务挂了。
GPU 显存不够。
向量数据库出了问题。
知识库检索异常。
某个内部系统接口超时。
工具调用失败。
模型输出格式发生变化,导致后面的业务流程解析失败。
这些问题,传统 IT 运维团队未必都有经验。
云服务模式下,很多事情是供应商在背后处理。
但私有化以后,系统就在你的机房里。
于是责任边界必须说清楚。
所以我会直接问:
“如果晚上系统挂了,谁来处理?”
“你们是7×24还是5×8?”
“远程支持还是现场支持?”
“多久响应?”
“多久恢复?”
“哪些问题包含在服务里,哪些需要另外收费?”
还有一个特别重要的问题:
SLA能不能写进合同?
如果供应商说:
“放心,出了问题我们肯定处理。”
这句话没有太大意义。
企业真正需要的是:
什么时候响应、谁负责、多久恢复、出了重大故障怎么办。
这些东西最好都落到合同里。
TITEL 0505 三年以后,如果我不想用你家的了,怎么办?
这是我认为最容易被忽略、但非常重要的一个问题。
我甚至建议所有企业采购 AI 系统的时候,都问一句:
“如果三年以后我们不续约了,能不能把东西带走?”
很多企业采购的时候只考虑“怎么上线”,很少考虑“以后怎么退出”。
但 AI 项目一旦深入业务,沉淀下来的东西其实不少。
比如:
提示词和流程
Agent 编排逻辑
评测数据
知识库数据
模型微调成果
工具接口
与内部系统的集成
各种业务规则
这些东西到底归谁?
能不能导出来?
用什么格式导出来?
换一家供应商以后还能不能继续用?
这些问题,如果一开始不问,三年以后再问,可能就晚了。
尤其要注意供应商的技术栈。
如果 Agent 编排、知识库、向量数据库、工具协议全部是供应商自己的私有体系,那么你用得越深,迁移成本可能越高。
最后就可能出现一种情况:
不是因为这家供应商一直最好,而是因为换一家太贵。
这就是典型的技术锁定。
所以我会问:
“模型权重能不能带走?”
“提示词、流程和评测数据能不能导出?”
“知识库数据能不能完整迁移?”
“Agent流程是标准格式还是你们自己的格式?”
“如果以后换供应商,迁移大概需要多长时间?”
这几个问题,其实是在问一件事:
你的系统有没有退出机制。
TITEL 06所以,私有化到底该不该做?
我的答案很简单:
该做的时候一定要做,不该做的时候,也不要为了“安全”两个字硬做。
企业 AI 的部署方式,从来不是只有“上云”和“私有化”两个选项。
公有云、专属云、私有化,甚至混合部署,都可以是方案。
真正应该先回答的是:
企业到底在防什么风险?
如果是监管要求,那就按照监管要求来。
如果是核心数据不能出域,那就把数据边界做好。
如果是模型不能访问外部网络,那就解决模型和数据的部署问题。
如果只是因为“AI比较新,所以不放心”,那就更应该把风险具体化,而不是直接买一套最贵的方案。
我一直比较反感一种项目逻辑:
甲方问安全,乙方回答私有化;甲方问价格,乙方开始报价。
中间其实少了非常重要的一步:
为什么需要私有化?
我通常把这5个问题归结成一句话
数据为什么必须留下来?
模型以后怎么升级?
算力到底怎么算?
出了问题谁负责?
以后能不能换?
这五个问题问清楚,私有化到底值不值,基本就有答案了。
所以,下一次供应商跟你说:
“这个项目建议私有化部署。”
先别急着让他报价。
先让他把这5个问题回答清楚。
因为私有化真正贵的,从来不只是第一年的服务器和软件费用。
更贵的,是那些一开始没人告诉你的成本。
作者注:
本文基于企业 AI 项目咨询与实施经验整理。不同企业、行业及监管环境的要求差异较大,金融、医疗、政务、央国企等场景不能简单套用同一套部署方案。
我的基本判断是:
私有化应该是经过数据、安全、成本、运维和长期演进综合论证后的结果,而不应该只是供应商报价单上的一个产品选项。