ARTICLE · 1018649
这份 PDF 转 Markdown 工具,比 pdftotext 强在哪、又贵在哪
这份 PDF 转 Markdown 工具,比 pdftotext 强在哪、又贵在哪
做 RAG、给大模型喂论文、要把扫描合同批量整理成结构化文本的人,大概都试过 pdftotext。出来的结果你一眼就懂:标题混进正文、表格散成单字、公式变成乱码、多栏排版左右交错读成一句话。
这不是工具不好用——是 PDF 这个格式本身就不存"语义"。一份 PDF 里只有"每个字符、线条、图像的坐标和样式",没有"这是一级标题""这三条线围成一个单元格"。任何 PDF 抽取工具都在做同一件事:从坐标反推语义。
传统工具的目标是"把字符取出来",MinerU 的路线不一样——重建结构。公式转 LaTeX、表格转 HTML、自动去页眉页脚页码、按人类阅读顺序重排、扫描件自动走 OCR(109 种语言)。
三剪客这份《PDF 高精度转 Markdown》手册的价值就在这一层:它把 MinerU 从装到选型到排坑讲透,并明确告诉你这条路线要付出什么代价——硬件、Python 版本、许可证,三个关一个都过不了它就跟你无关。
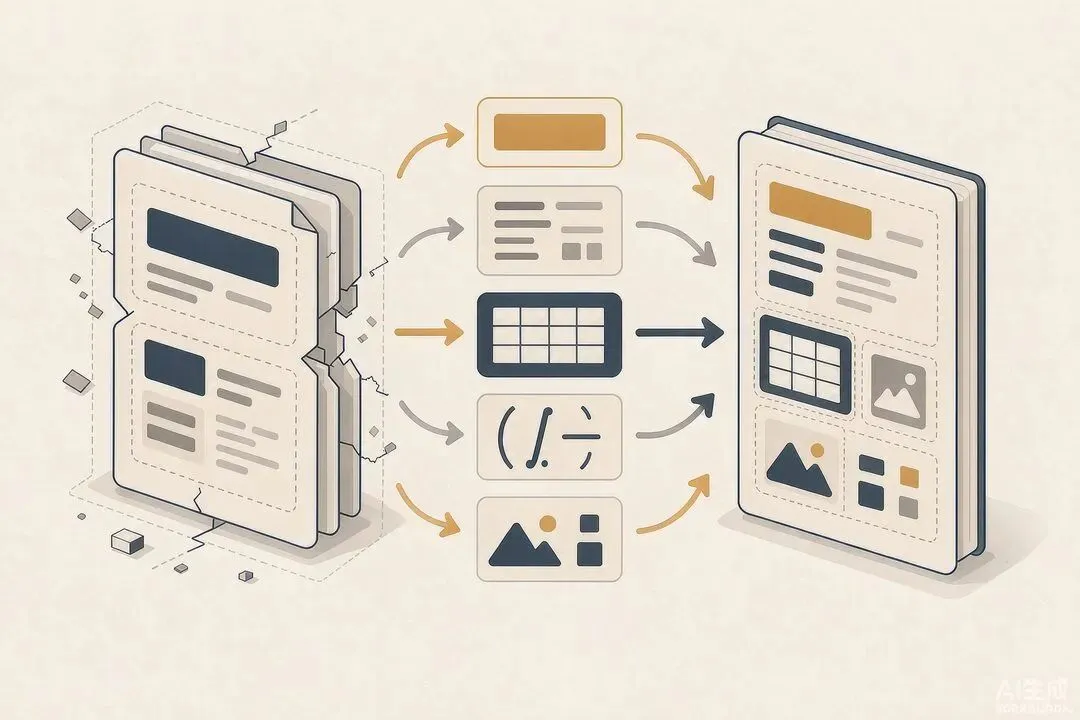 从坐标反推语义:MinerU 的版面重建路线
三剪客是谁
如果你看过这个账号前几期文章,应该对这个作者不陌生。三剪客在 SkillHub 上 9 月 12 日注册账号,今天再去翻,他名下已经挂出了 200 个技能包,累计下载 1431 次。
他的产品线大致两条。一条是工具矩阵——图片生成、视频生成、语音克隆、视频超清——这种包一个 API 就能用,按点计费。另一条是开源项目手册,MinerU 属于这条:把某个成熟的开源项目讲透,从装到用再到排错,写成一份能照着做的文档。
这条线里的技能包有个共同特征:包里没有一行上游代码,也不带模型权重。SKILL.md 加 README.md 加 LICENSE.md 加一个 _meta.json,四个文件就是全部。它卖的是"少走弯路",不是代码本身。
MinerU 是什么
一句话:把 PDF、图片、DOCX、PPTX、XLSX 高精度解析成结构化 Markdown / JSON,公式转 LaTeX、表格转 HTML、自动按人类阅读顺序重排。
它上游是 OpenDataLab 团队的 opendatalab/MinerU,GitHub 上 79,909 star、6,681 fork、111 open issues,最后一次 push 是 2026-09-13,活跃度不低。官方自述说这个项目"诞生于 InternLM 预训练过程中的文档清洗需求"——也就是说,它一开始就不是"文档转 Word"那种办公工具,而是给大模型喂数据用的预处理流水线。
PyPI 当前最新版 3.4.5,要求 Python 3.10~3.13(Windows 只支持 3.10~3.12)。Docker 镜像默认带 vllm 加速。
三种后端:86 到 95 分的取舍
MinerU 把"怎么解析"拆成三条路线,结果差异巨大:
• pipeline(纯 CPU 可跑):用版面检测、表格识别、公式识别、阅读顺序几个专用小模型接力打。OmniDocBench v1.6 端到端得分 86.47。优点是兼容性好、资源占用低、不易产生幻觉;代价是精度上限就在 86 附近。
• vlm-engine(GPU 必需):让视觉语言大模型整页理解。得分 95.30。精度最高,需要 8GB+ 显存和 Volta 架构及以上显卡或 Apple Silicon,不支持纯 CPU。
• hybrid-engine(GPU 必需):PDF 有文字层时直接取原生文本,只在没文字层或乱码时才让模型识别图像。得分 medium 95.26、high 95.39。官方默认走它。
这里有一个不那么显眼但很关键的取舍:hybrid 的 medium(默认)相比 high 只损失 0.13 个精度点(95.26 vs 95.39),却换来 35%~220% 的提速(Linux 文本 PDF 约 80%、Windows 约 90%、macOS 约 220%)。代价是 medium 不支持文档内图像分析,要分析图就显式切 --effort high。
理解这一段就知道默认值的逻辑:它默认选的是"边际收益最高"的那档,不是"最准"的那档。
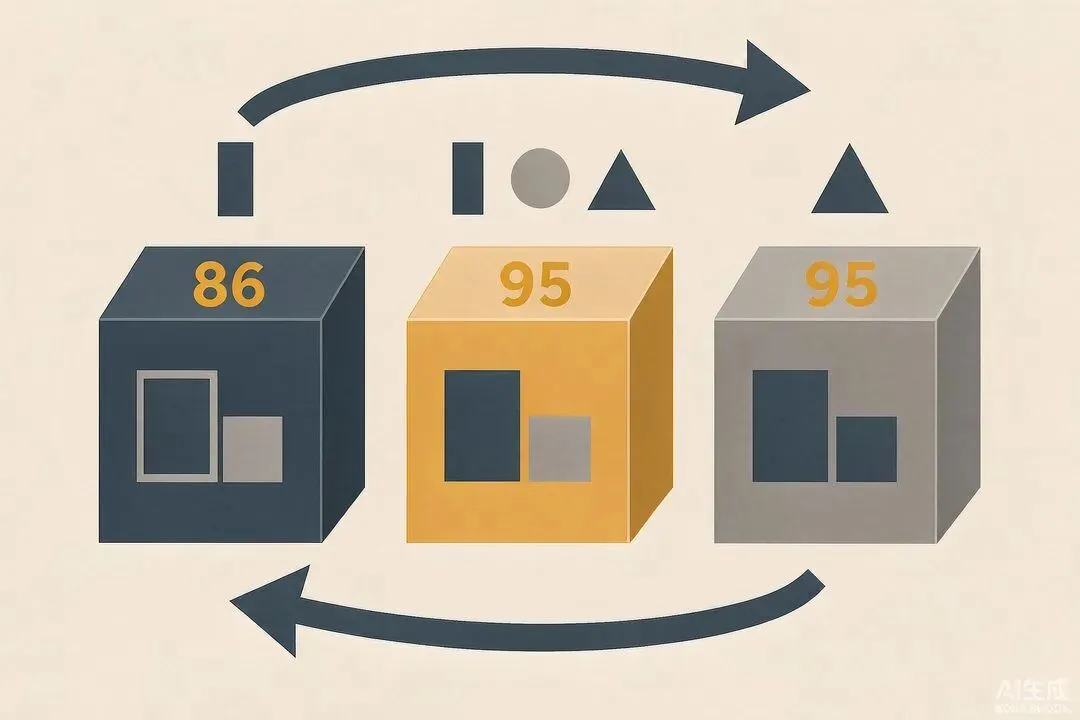 三种后端的精度/速度/硬件取舍
安装:pip、uv、Docker 三条路
最常用的是 uv:
pip install --upgrade pip pip install uv uv pip install -U "mineru[all]"源码安装走 git clone https://github.com/opendatalab/MinerU.git 然后 uv pip install -e .[all]。
Docker 给的是官方镜像,只支持 Linux 和带 WSL2 的 Windows——macOS 官方明确不推荐走 Docker,理由是拿不到 MPS / MLX 加速。Docker 起一次带四个 profile:api(8000 端口)、gradio(7860 端口)、router(8002 端口)、openai-server(30000 端口)。
起服务的命令:
mineru-api --host 127.0.0.1 --port 8000 # FastAPI,文档在 /docs mineru-gradio # WebUI mineru-router # 多服务/多 GPU 统一入口CLI:最简路径
# GPU 可用时(默认 hybrid-engine) mineru -p <input_path> -o <output_path> # 纯 CPU mineru -p <input_path> -o <output_path> -b pipeline # 用远端 GPU,本机只跑客户端 mineru -p <input_path> -o <output_path> -b vlm-http-client -u http://<server_ip>:30000页码范围、解析强度、OCR 语言、关掉公式/表格——这些都有独立开关:
mineru -p in.pdf -o out/ -s 10 -e 20 # 第 10~20 页(页码 0-based) mineru -p in.pdf -o out/ --effort high # medium 默认更快,high 更准 mineru -p in.pdf -o out/ -b pipeline -l ch # pipeline 后端 + 中文 OCR mineru -p in.pdf -o out/ -f false # 关掉公式解析 mineru -p in.pdf -o out/ -t false # 关掉表格解析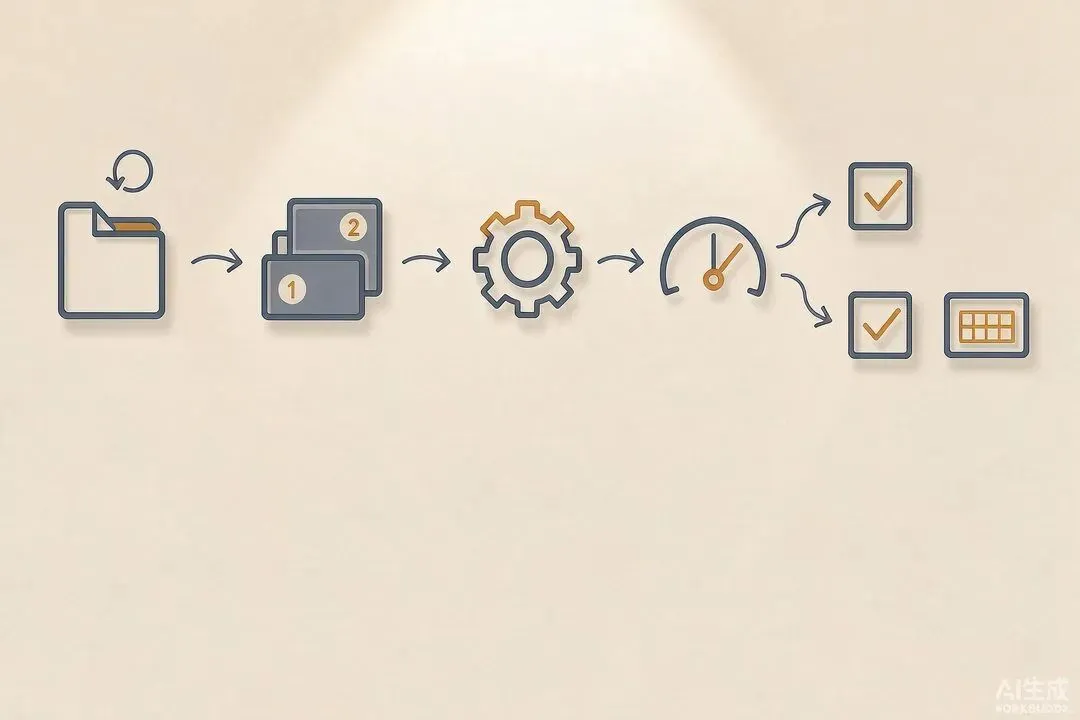 CLI 参数全景:从路径到页码到 OCR 语言到关闭模块
三个容易踩的 URL 坑
mineru 这个 CLI 现在的内部实现是基于 mineru-api 的编排客户端——不给 --api-url 时自己起一个临时本地服务,给了就连过去。所以有两种 URL:
• -u/--url:这是给 vlm/hybrid 的 OpenAI 兼容后端地址(通常是远端 vllm 服务)。-b vlm-http-client 或 -b hybrid-http-client 时才用。
• --api-url:这是 MinerU 自己 API 服务的地址(mineru-api 起的那个)。
很多人改 --url 想连 MinerU 服务,结果连不上——它指向的是 OpenAI 兼容后端,不是 MinerU API。这是这份手册里被点出来专门防错的一条。
另一个隐藏层级:环境变量优先级高于命令行参数。MINERU_FORMULA_ENABLE、MINERU_TABLE_ENABLE、MINERU_TOOLS_CONFIG_JSON 这些一旦设了,命令行 -f false / -t false 都不会生效。改行为前先 env | grep MINERU 看一眼。
官方明确不做的几件事
它自己划线,划得比同类工具清楚:
• 不做高保真版式还原,不产出排版一致的 PDF。
• 不保证任意文档完美解析——复杂版面、扫描页、手写可能不及预期。
• 不做 PDF 编辑、拆分合并、加水印、签名——完全是另一个工具的事。
• 不是通用格式转换器——不负责 Markdown 转回 Word。
• 不提供语义理解与摘要——"它给你结构化的文档内容,不给结论"。
这五条里最后一条最容易被误解。它是预处理工具,不是"读完再回答"的工具。要"读完再回答",交给后面的大模型。
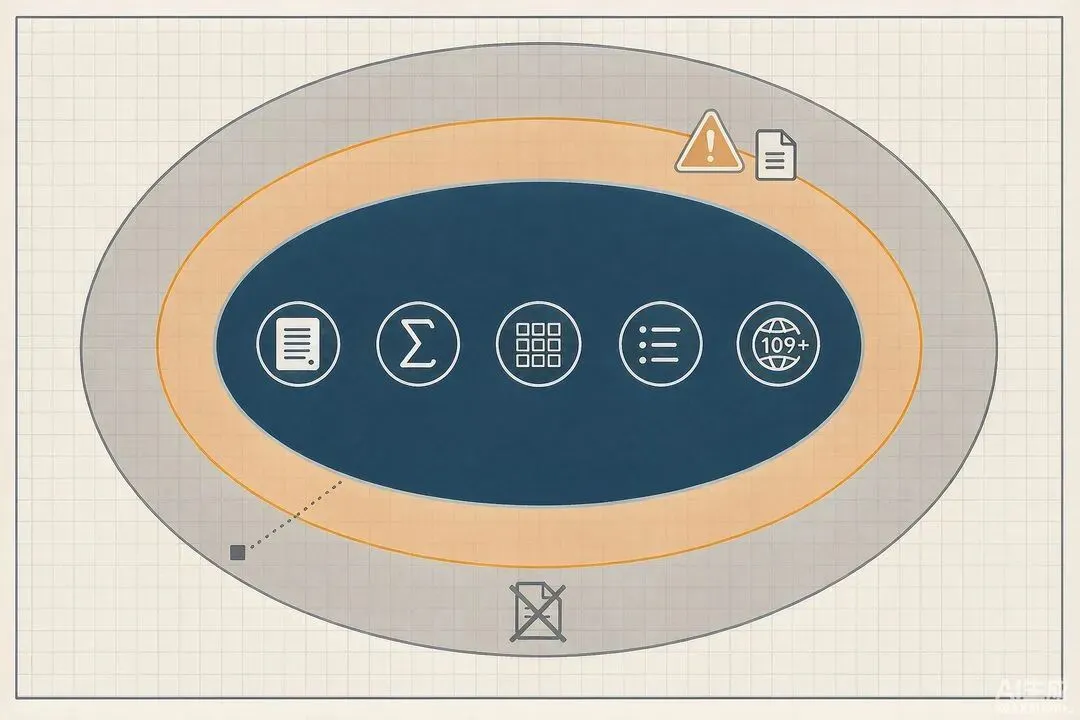 MinerU 的能力边界:重建结构 vs 版面还原 vs 语义理解
快速开始
pip install --upgrade pip pip install uv uv pip install -U "mineru[all]" # GPU 可用 mineru -p ./report.pdf -o ./output # 纯 CPU mineru -p ./report.pdf -o ./output -b pipeline # 长任务超时调大 export MINERU_TASK_RESULT_TIMEOUT_SECONDS=72008 个坑,逐条对着看
1. macOS 上跑 Docker 没加速、慢得离谱 — 官方不支持 macOS 走 Docker。动作:macOS 改 pip/uv。
2. 显存不够、vllm 起不来 — vlm/hybrid 有硬件门槛。动作:纯 CPU 走 -b pipeline;或 http-client 把推理放远端;同机不要同时起多个用 vllm 的服务。
3. --url 连不上自己起的 mineru-api — -u/--url 给的是 OpenAI 兼容后端。动作:连自己服务用 --api-url http://127.0.0.1:8000。
4. 命令行参数改了不生效 — 环境变量优先级最高。动作:env | grep MINERU 看一眼 MINERU_FORMULA_ENABLE、MINERU_TABLE_ENABLE、MINERU_TOOLS_CONFIG_JSON。
5. 装完跑第一条命令卡下载模型很久 — 首次拉权重。动作:网络受限时按官方"模型源文档"手动配置;耐心等本地缓存建立。
6. 超长文档把内存吃满 — 峰值内存问题。动作:升级到较新版;调 MINERU_PROCESSING_WINDOW_SIZE 平衡内存与吞吐。
7. Windows 装了 Python 3.13 后装不上 — ray 在 Windows 上不支持 3.13。动作:Windows 用 3.10~3.12。
8. 想拿单页结果,页码对不上 — -s / -e 是 0-based。动作:第 1 页对应 -s 0。
我的看法
第一,许可证这件事别再按 MIT 套。 MinerU 上游不是 MIT 也不是标准 Apache 2.0——是"MinerU Open Source License",基于 Apache 2.0 加附加条件。它 3.1.0 从 AGPLv3 迁过来的,因为 AGPLv3 对通过网络提供服务有源码开放要求,会挡住企业商用。理解这段历史就明白,为什么它是"最好的开源 PDF 解析项目之一",却不能简单说"Apache 2.0 随便用"。商用前必须自己读一遍 LICENSE.md 确认条款。本 Skill 包自身的许可证是 MIT——两个层级别混淆。
第二,"默认走 hybrid medium"不是偷懒,是工程取舍。 0.13 个精度点换 35~220% 提速,这个比值在 RAG 预处理场景里完全划算。但 medium 不支持文档内图像分析——如果你的 PDF 里图很多(比如产品手册、论文图表),必须显式切 --effort high,不然图就被当装饰跳过了。
第三,硬件门槛是真的,不是文档吓你。 vlm/hybrid 后端要 Volta 架构及以上的 NVIDIA 显卡、8GB 可用显存、推荐 32GB 内存、20GB SSD。机器不够还想用这条线,要么走 -b pipeline(纯 CPU,慢但能跑),要么走 http-client(2GB 显存起步,本机只跑客户端)。这两条都是真路径,不是什么 workaround。
第四,OS 限制是硬性的。 macOS 14.0 以下、Docker 部署 macOS、Python 3.13 on Windows——三条任一踩中就装不上。装机前先查清楚自己机器的 Python 版本和 OS 版本,别等到 pip 报错再来翻 FAQ。
最后一句给"只会用 pdftotext"的人:MinerU 跟 pdftotext 不是同一类工具。pdftotext 的目标是"快、能取出来字符",MinerU 的目标是"重建结构、喂给大模型"。如果你只需要一段文本,pdftotext 够用;如果你要给 RAG 喂论文、要保留公式 LaTeX、要表格转 HTML、要按阅读顺序重排——这条线是当下最强的开源选项之一,前提是你愿意为它付出硬件成本和许可证上的注意。
技能地址:https://skillhub.cn/skills/user_13e245e1/sanjianke-mineru版本 1.0.0,MIT 许可(Skill 文档),上游为 MinerU Open Source License(Apache 2.0 + 附加条件),不内嵌任何密钥,四个文件,纯文档。
本账号长期拆解 SkillHub 上的热门 AI 技能包,一天一个。不想自己翻的话,点个关注,后台留言告诉我你想看哪个 Skill。