ARTICLE · 1019184
踩大坑!文档成功导入知识库,但想用的时候根本找不到
这是「打工人AI自救」的第 18 期分享。
你好,我是旺旺。
我的 Obsidian 里躺着 70 页笔记,45 个 X 账号的人物卡片,还有十几份公众号原文。数量看着挺唬人。
前两天我随手问了 AI 一句,说帮我看看我之前记的那个出海博主怎么变现。
它翻了半天,翻出来了。
但那一瞬间我脑子里冒出来的第一个念头,是后怕。
因为这 70 页里,有相当一部分,我自己都定位不到它在哪一层。
于是我把这件事认真想了一遍。
大多数知识库的结局,是在文件夹里躺死
先说个判断。
知识库的终点不是存储,是检索命中率。
存和整理都是成本,花时间,花 token,本身不产生价值。
只有被检索到的那一刻,它才产生价值。
所以一个知识库好不好用,看的不是你记了多少,是你能不能找到。
找不到,那它就是个仓库,不是知识库。
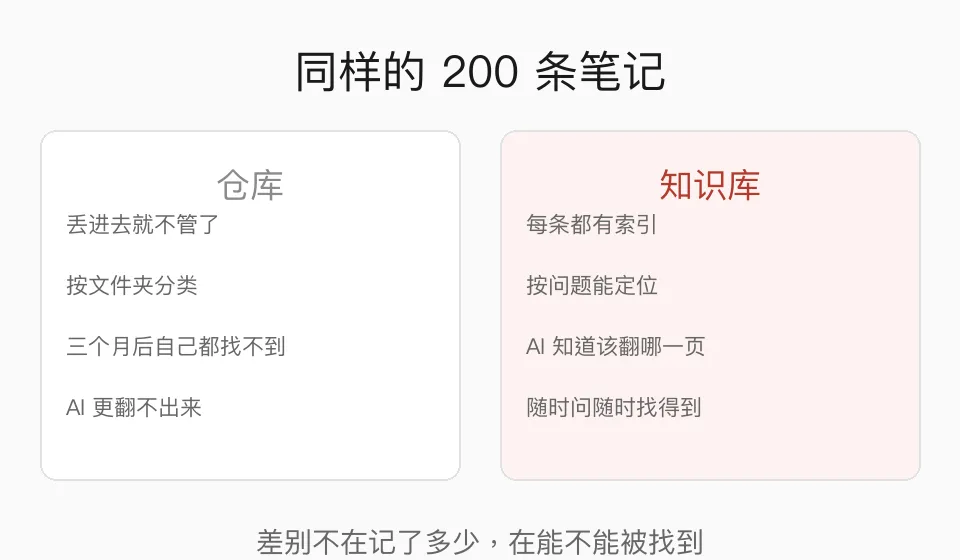
图 1 同样的 200 条笔记,堆着是仓库,能被翻出来才是知识库
我见过太多人搭建知识库的路径是这样的。
装个 Obsidian,买几个插件,建一堆文件夹,把公众号文章、网页收藏、读书笔记一股脑塞进去。
前两周很爽,觉得自己有系统在长。
三个月后你会发现一件事,你自己都不知道某条笔记在哪。
更麻烦的是,你让 AI 去搜,它也搜不出来。
因为 AI 不会主动去翻文件夹,除非你告诉它去哪翻。
我的底座是 Karpathy 那套 LLM wiki
我这套东西的起点,是 Karpathy 提的 LLM wiki。
核心思想很朴素,不要让 AI 每次提问时临时拼答案,要让它持续地、增量地维护一份知识库。
每次有资料进来,都留下变化,而不是丢进一个文件夹了事。
我照着这个思路落地成了三层。
第一层 sources,原始资料,只读,永远不改。推文原文、公众号原文、爬下来的资料都扔这里。
第二层 wiki,编译知识,AI 维护。分成 entities 人物页、concepts 概念页、topics 主题页、daily 日报、weekly 周报、strategy 战略文档。
第三层 SCHEMA,规则文件,写死命名规范、页面模板、操作约定。
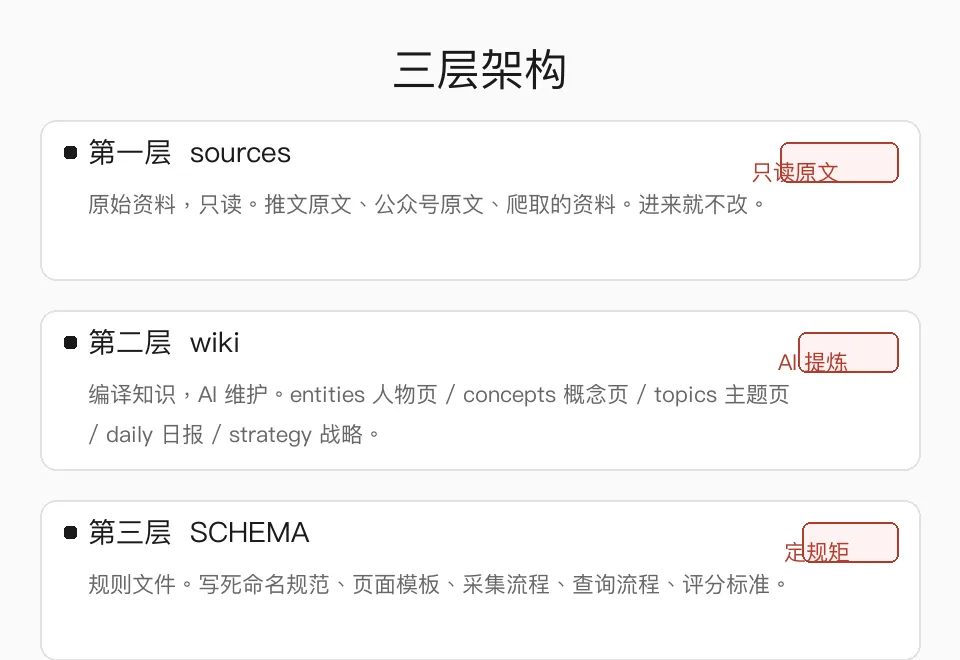
图 2 sources 只读、wiki 编译、SCHEMA 定规则,三层分离
这个三层是网上能搜到的,我没什么原创。
真正的差异在后面。
真正解决问题的,是四层记忆
Karpathy 原版解决的是 Obsidian 里那三层。
但我实际用下来发现,Obsidian 根本不是最关键的那一层。
让我「任何时候问都能找到」的,是上面这三层。
第一层,Hermes 的 MEMORY.md,每次对话强制注入,约 2200 字符。只放最高频的东西,飞书知识库入口、常用 provider、关键约定。
第二层,mem0,通过 MCP 协议让 Hermes、Claude Code、CodeBuddy 三个 AI Agent 共用同一份记忆。
这一点很多人忽略。你本地写笔记,你手机上的 AI、云端的 AI 都看不到,那等于没共用。
第三层,Obsidian 本体,深度知识,按需检索,不进上下文。
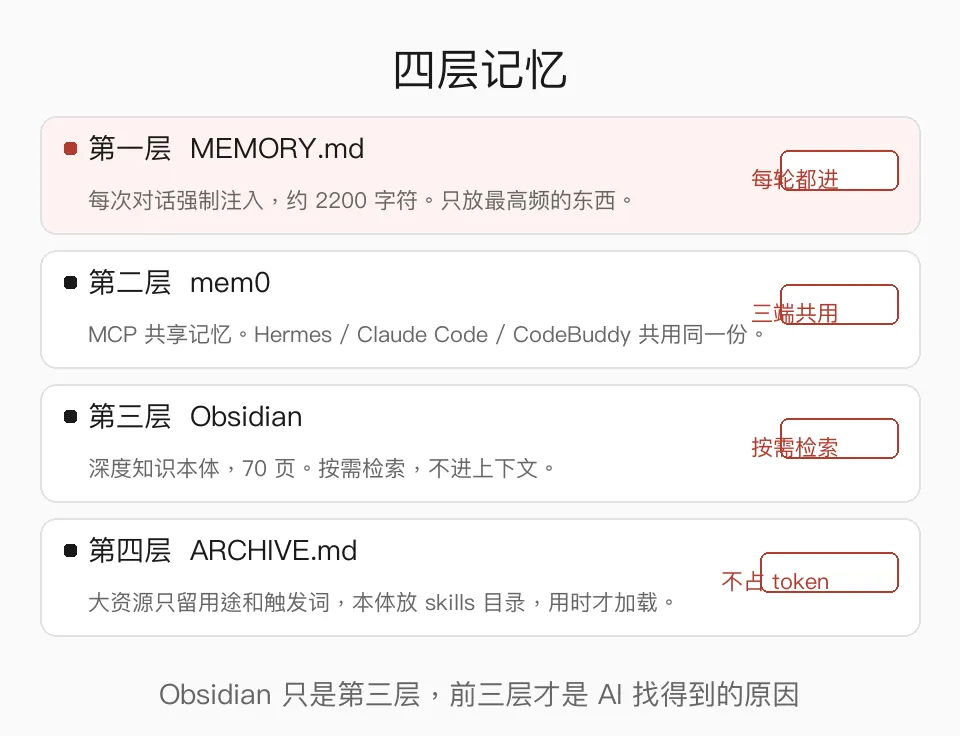
图 3 Obsidian 只是最底层,前三层才是让 AI 找得到的原因
第四层,ARCHIVE.md,这条最容易被忽略,但对我最值钱。
我装过一款设计 skill,光 references 就有 107 个文件。
如果全塞进 MEMORY.md,每次对话都要带一遍,token 直接爆炸。
所以我的做法是,skill 本体放 skills 目录,ARCHIVE.md 里只写一句用途和触发词,然后明确标注不进 MEMORY.md。
AI 需要它的时候才去 skills 目录加载,不需要的时候,它不占我一分钱 token。
这不是记笔记,这是在管 token 预算。
Karpathy 那篇文章没有这一层。
入库有纪律,不然三个月后全是孤儿
三层架构听起来漂亮,落地的时候最容易翻车。
我踩过一次。
8 月底我一次批量入库了十几个 X 账号,只建了人物卡片,没同步更新 index 和 log。
三天后我想查其中某个人,找不到。
不是内容没了,是索引没更新,它成了孤儿页。
从那以后我定了四条硬约束。
第一,同一概念只维护一个页面。新采集来了是更新旧页,不是新建副本。
第二,入库必须四层同步。内容卡、汇总表、index、log,一次改完。少一层就是技术债。
第三,不编造。AI 最擅长的就是编造得像真的。所以入库时的观点区,一律写待补充,等我真的看过那些内容再回填。
宁可留白,不可填假。
第四,查询走固定流程。先读 index.md 找页面,再读 2 到 5 个最相关的页面,综合回答并标注来源。
第四步是重点。
有了 index.md 这个入口,AI 就知道该翻哪本书,而不是把整个库翻一遍。
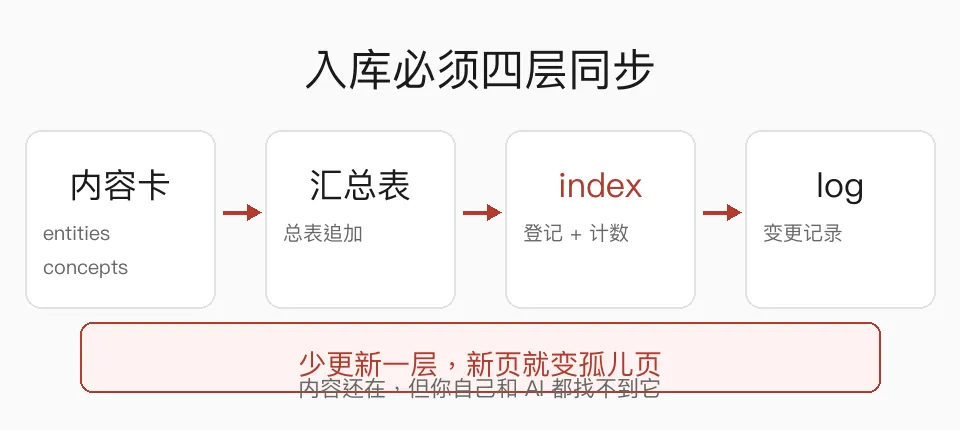
图 4 建卡不是终点,同步 index 和 log 才算入库完成
我是怎么用的
举几个真实场景。
问它「有哪些 AI 博主值得跟进」,它能直接列出 45 个账号、每个的定位,以及它们之间的关系,因为人物卡之间是双链的。
问它「我现在的变现方向是什么」,它能翻出 strategy 下的作战地图和生产流水线计划。
问它「这个工具怎么装」,它能翻出 ARCHIVE.md 里的触发词,然后去加载对应的 skill。
这些都不是我一层层扒出来的,是我问出来的。
最后说一句
这套东西从 8 月 9 号开始搭,到今天正好三个月。
三个月前它是 55 个文件堆在一起,我自己都翻不动。
现在它是 70 页,问什么都能找到。
区别不是记了多少,是能找到多少。
如果你也在攒 Obsidian,或者 Notion,但 AI 问你还是找不到,可能需要调整的不是记忆层,是检索层。
我是旺旺,一个从 Java 转 AI、正在做一人公司的打工人。我在这个号只写一件事,打工人怎么用 AI 给自己加杠杆,把一个人活成一个小团队。
看到这里,你准备好让 AI 替你翻档案了嘛?
感谢!