ARTICLE · 1019559
知识库搜到了相关文档,为什么回答还是错的?
你问知识库:“今年正式员工在国内住酒店,报销上限是多少?”
它搜到了差旅规定,回答“400 元”,还附了一条引用。打开文档一看:这条规定属于去年,今年的标准已经是 500 元。
搜到了相关文档,只说明拿到了一批候选资料。能不能据此回答,还要看资料是否适用于这个问题。
这是一个人为构造的例子。但如果你正在给自己的 RAG 项目做验收,它比继续试几个“能答对的问题”更值得留下来。RAG 可以简单理解为:先查资料,再让模型结合资料回答。
01引用是真的,答案也可能用错了地方
先把问题缩到几条小规则。下面都是教学样例,不是任何公司的实际报销制度:
去年,正式员工国内酒店上限 400 元;今年改为 500 元。另有一条今年的海外酒店规则,上限 900 元。
用“酒店、国内”检索,旧规则可能与新规则一起返回。假如直接拿第一条里的金额作答,400 元就出来了。
引用确实来自知识库,金额也确实存在,错在它没有回答“今年、国内、正式员工”这个完整问题。
再把提问人换成实习生。库里只有正式员工规定,就算搜到了三条“酒店报销”文档,也不能替实习生给出金额。正确的提示应是:“当前资料没有覆盖实习生的适用规则。”这和“实习生不能报销”完全不同。
还有一种情况更容易被忽略:两份都标为今年、适用人群也相同的资料,一份写 500 元,一份写 600 元。样例没有提供哪份更权威的依据,此时应暂停给结论,核对来源。靠排序位置挑一个数字,会把资料冲突藏起来。
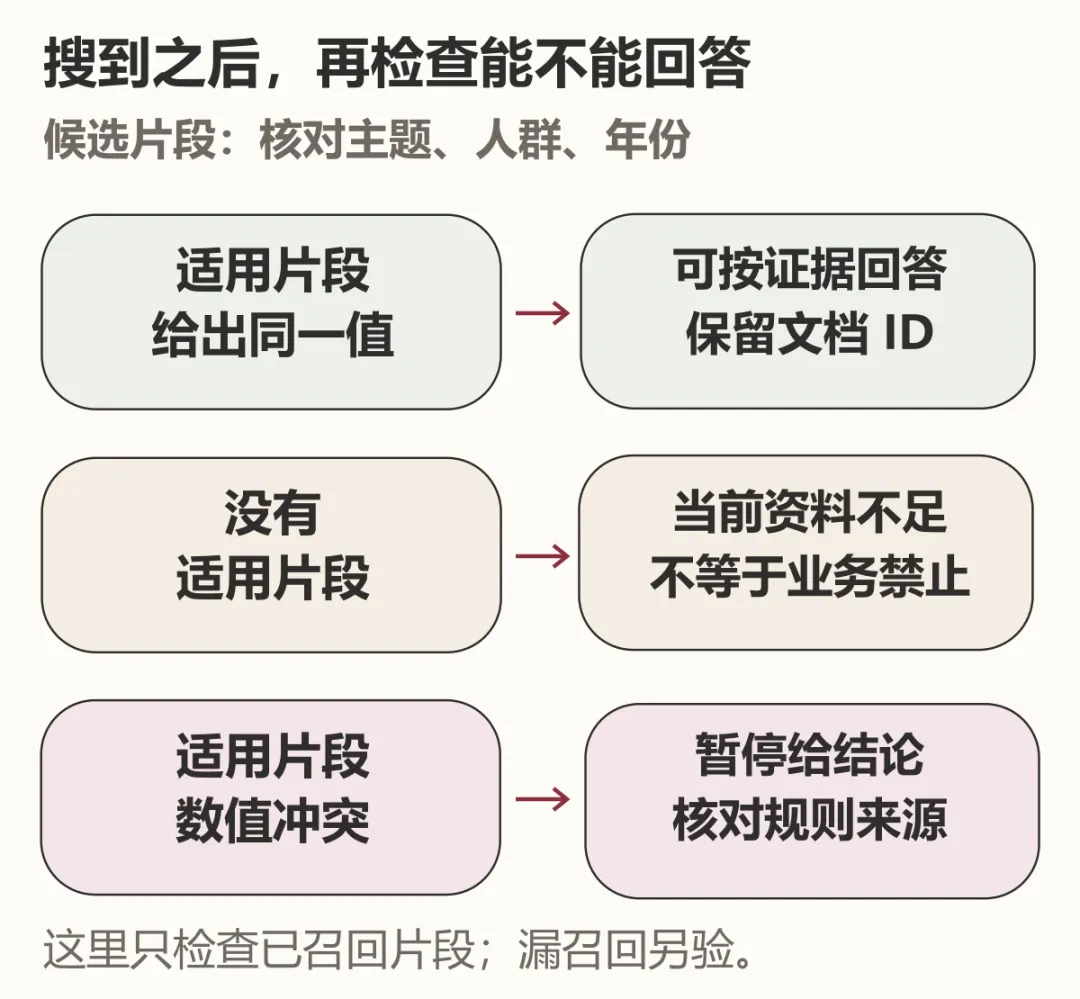
图中表示的是本文的人工规则实验。检查只覆盖已经召回的片段;真实业务还要核实来源、权限和生效范围。
02先验收这六个问题
我用 Python 标准库做了一个离线小程序。它按手工关键词重合数取前三条候选,再检查主题、人群、年份以及摘录值是否冲突。没有调用大模型,也没有接向量数据库。
这次刻意保留六种输入:
正常问题:发票最晚几天提交,资料明确写了 30 天。 旧版干扰:今年的酒店规则与去年的规则一起返回。 范围不符:实习生的问题,只找到了正式员工规则。 资料缺失:问停车费,库里没有对应规定。 证据冲突:两份适用规则分别写 500 元和 600 元。 检索漏掉:把“酒店”换成“住宿”,简单关键词检索没找到已有答案。
运行后,直接取第一条值的简陋基线只符合 1 条预期。加上证据检查,符合 5 条。
这不是“RAG 准确率从多少提升到多少”。六条题和规则都由人编写,金额直接来自预先整理的字段。它验证的是:程序有没有把不同失败情况区分开。
最后那条仍然失败,正是这份验收最该保留的地方。
问题用了“住宿限额”,文档关键词只有“酒店”。库里明明有今年的 500 元规则,检索却返回空。后面的检查只能报告当前证据不足,无法凭空找回遗漏的文档。
所以,要同时保留两个判断:这次没有证据时,程序没有乱给金额;但这个本来有答案的问题,系统仍未完成任务。
只看“没有胡说”,会漏掉第二个问题。只看“有没有返回文档”,又会漏掉前面的过期、范围不符和冲突。
这里的分开验收也有现成参考:Microsoft 的 RAG 评估文档将检索过程与最终回答分别评价,检索标签和回答依据承担不同作用。本文只做前面的简化练习,没有执行模型回答评测。官方说明
给自己的项目留一条能追查的记录
不用一开始就攒上百道题。先围绕真实资料补上这几类失败样例,每条保存问题、资料版本、应该找到的文档 ID、实际返回的 ID,以及应当回答还是提示资料不足。
当它失败时,先问:“正确资料到底有没有进候选列表?”有,就继续看适用条件和回答;没有,就回到检索环节。不要每次都从改提示词开始。
对从 Java 后端转向 AI 应用的开发者,这是一项可以直接动手补的工程能力:定义输入与预期,保留运行记录,解释失败发生在哪里。完成后,你可以清楚说明项目验证过哪些边界,哪些还没有覆盖。
下一次演示知识库时,除了展示一个答对的问题,也拿出一条它答不了、而你能解释原因的记录。它更能说明你对这个系统了解到了哪一步。