ARTICLE · 1021358
阿里开源 AI 代码审查工具登顶 GitHub:为什么它不让模型决定所有步骤?
9 月 16 日,阿里开源的 OpenCodeReview 登上 GitHub Daily Trending 第一。今天页面快照显示,它一天新增约 2756 个 star;同一天,项目还发布了 v1.12.3。
热度之外,我更在意它的架构选择:哪些步骤必须由确定性程序负责,哪些判断才交给模型。
这比“又一个 AI 代码审查工具”重要。代码评审进入 CI 后,漏文件、评论位置漂移、规则忽略和 token 失控,都会变成真实的工程成本。
我的结论是:OpenCodeReview 最值得看的不是模型有多聪明,而是它主动缩小了模型能随意决定的范围。不过,它仍不能替代静态分析、人类批准和安全边界。
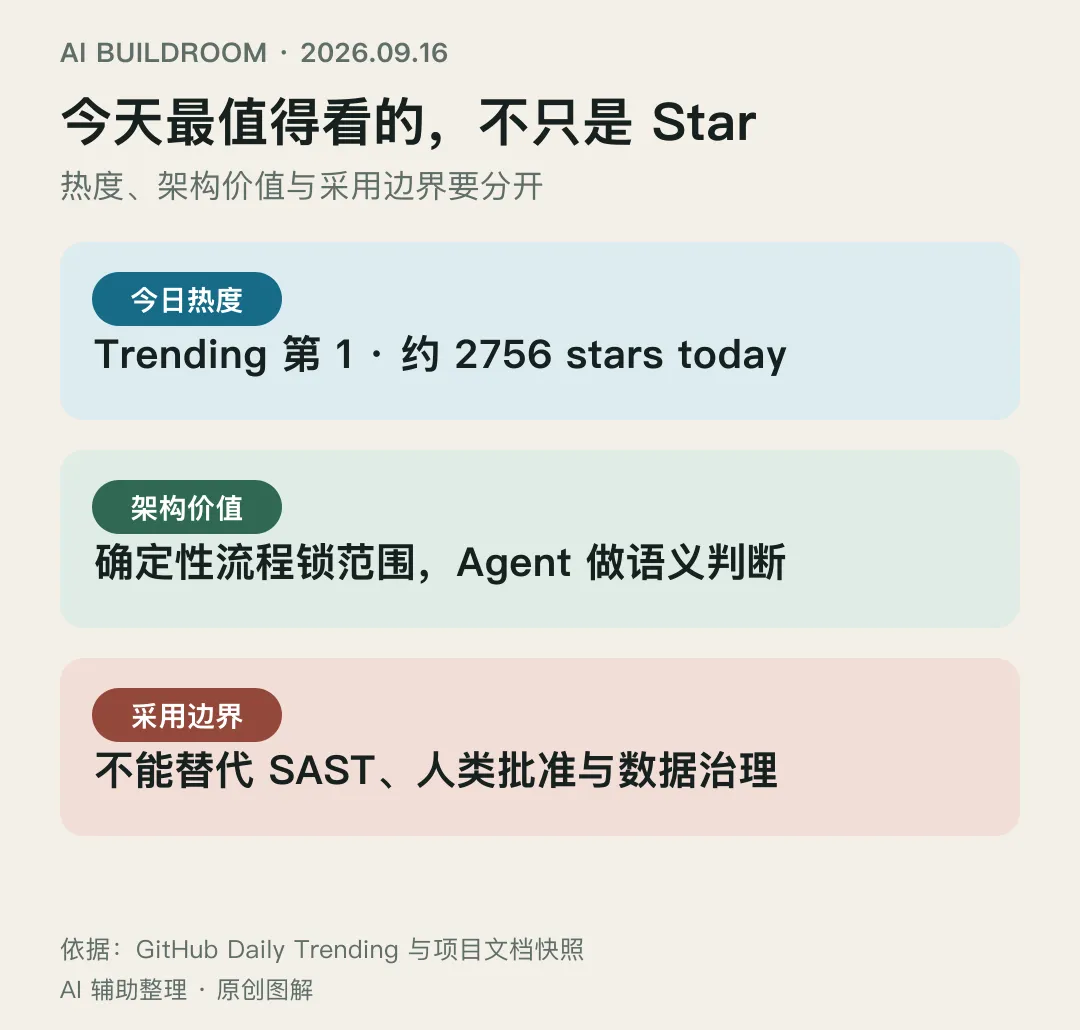
图:热度、架构价值与采用边界要分开看。
解决什么问题
通用 Coding Agent 当然可以阅读 diff。但改动一多,单靠提示词很难稳定保证:所有文件都被覆盖、相关文件被放在一起、每种语言应用正确规则、评论准确落到对应行。
OpenCodeReview 的 README把流程拆成两部分。
确定性工程负责文件筛选、相关文件分组、规则匹配、评论重新定位和结果反思;Agent 负责理解代码、动态检索上下文并判断问题是否成立。
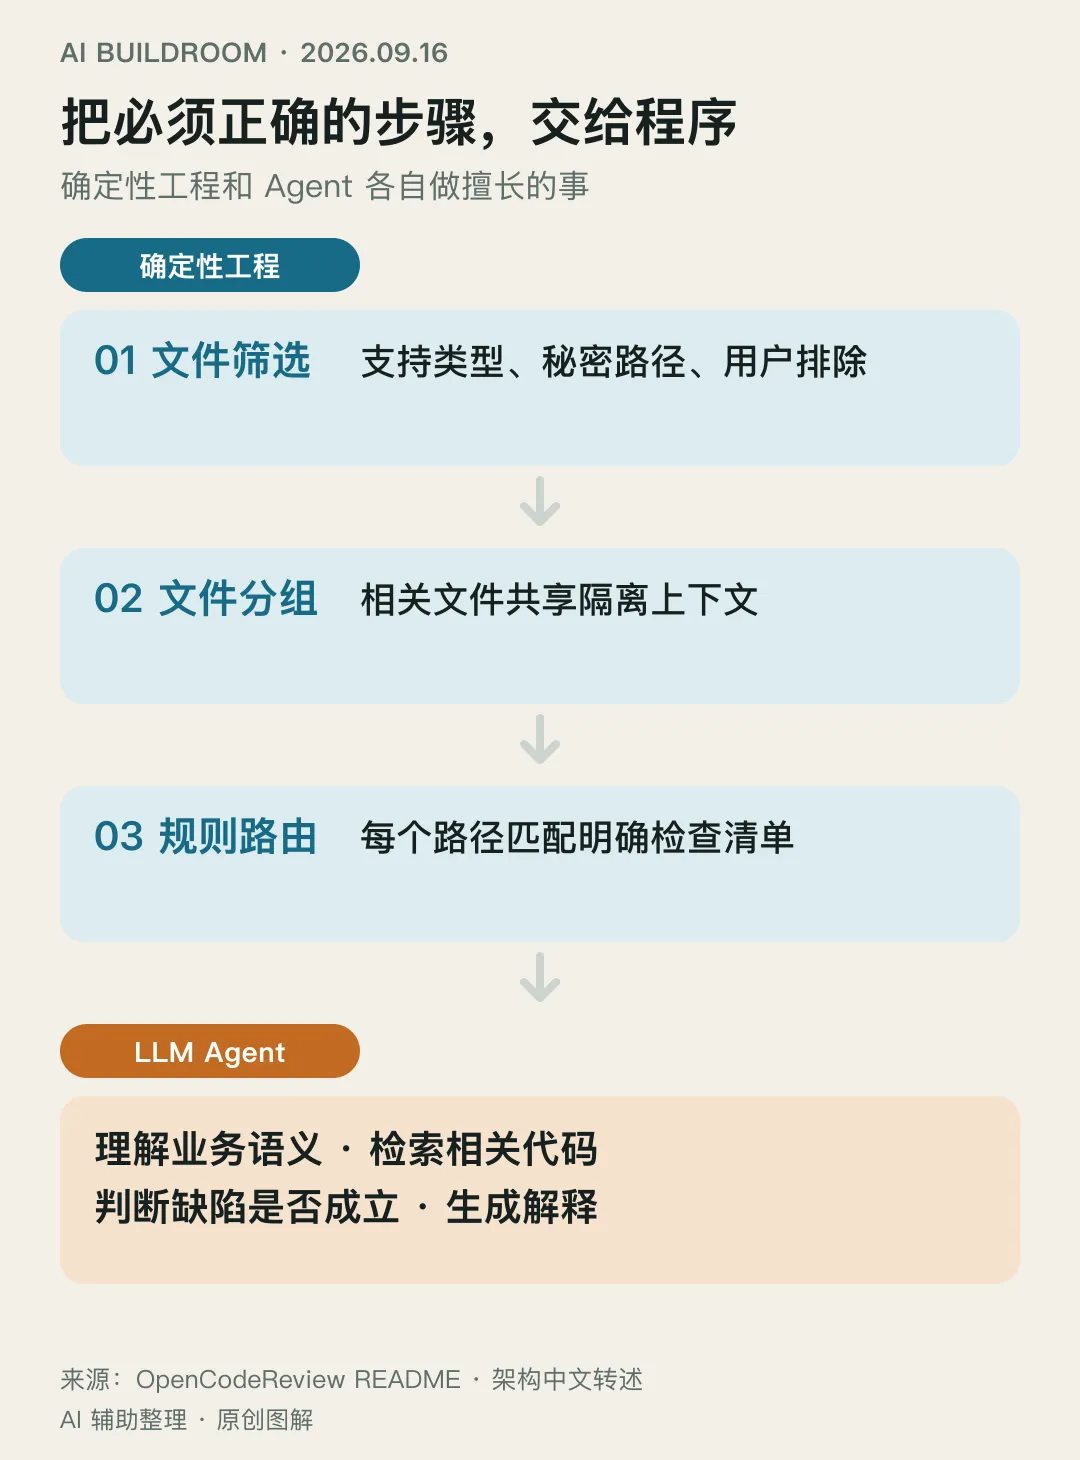
图:先把范围锁住,再让模型做语义判断。
这种拆分符合一个朴素原则:可以用程序准确计算的事情,不必让模型猜。模型的价值应该留给跨文件理解、业务语义和异常路径。
项目方公开的 AACR-Bench 涵盖 50 个开源仓库、200 个真实 PR、10 种语言和 1505 个标注问题,并称在相同底模下,Precision 与 F1 高于通用 Agent,平均 token 约为后者九分之一。
但同一份说明也承认 Recall 更低。这意味着它选择少报一些问题,换取更少误报。该基准由项目方构建,本轮没有独立复跑,因此只能写成项目方结果,不能写成通用结论。
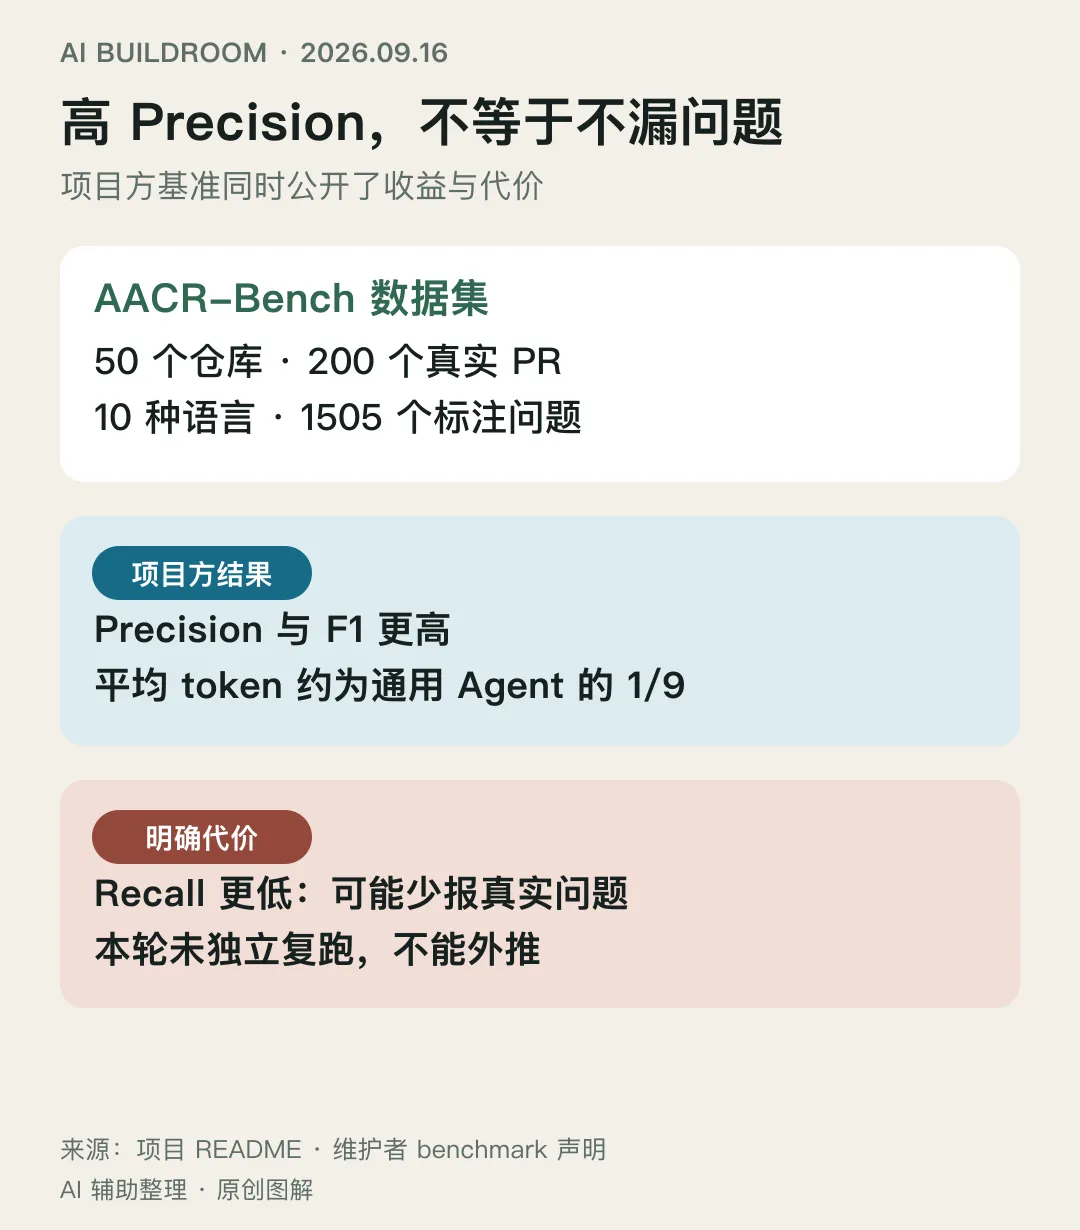
图:Precision、Recall 与成本之间存在取舍。
适合谁
它更适合已经有 Git 流程、规则清单和 CI 的团队:希望自动覆盖每个 PR,同时又不想把文件范围、排除项和审查规则全交给自然语言。
如果团队正在用 Codex、Claude Code、Cursor 等订阅制工具,可以关注委托模式。OCR 只输出文件列表和规则分组,由宿主 Agent 使用自己的模型额度执行审查,不需要再给 OCR 配一个 API Key。
它不适合被当成合并批准者。项目路线图明确写着:自动修复而不经人工审核不在规划范围内。只有几个小文件的个人仓库,也未必需要引入一套新的审查层。
测试环境
本轮使用官方 v1.12.3 macOS arm64 二进制。下载前核对发布页,下载后验证文件大小和 SHA-256 均一致,才允许执行。
测试仓库是临时生成的虚构仓库,不含真实业务代码。没有配置模型、API Key 或遥测,也没有发起任何 LLM 请求。
本机 Git 是 2.39.3,低于项目要求的 2.41。两个委托命令都给出警告后继续完成,因此实验只能证明当前预览行为,不能证明所有受支持环境都一致。
最小实验
我准备了 5 个改动文件:Go 鉴权代码、YAML 配置、生成代码、.env.production 和 .env.example。项目规则明确排除 generated/**,并分别给 Go 与 YAML 配置审查清单。
第一步只查看范围:
OCR_BIN=/path/to/ocrDEMO=/path/to/demo"$OCR_BIN" delegate preview \ --repo "$DEMO" \ --format json第二步只解析规则:
"$OCR_BIN" delegate rule \ --repo "$DEMO" \ --format json \ src/auth.go config/app.yaml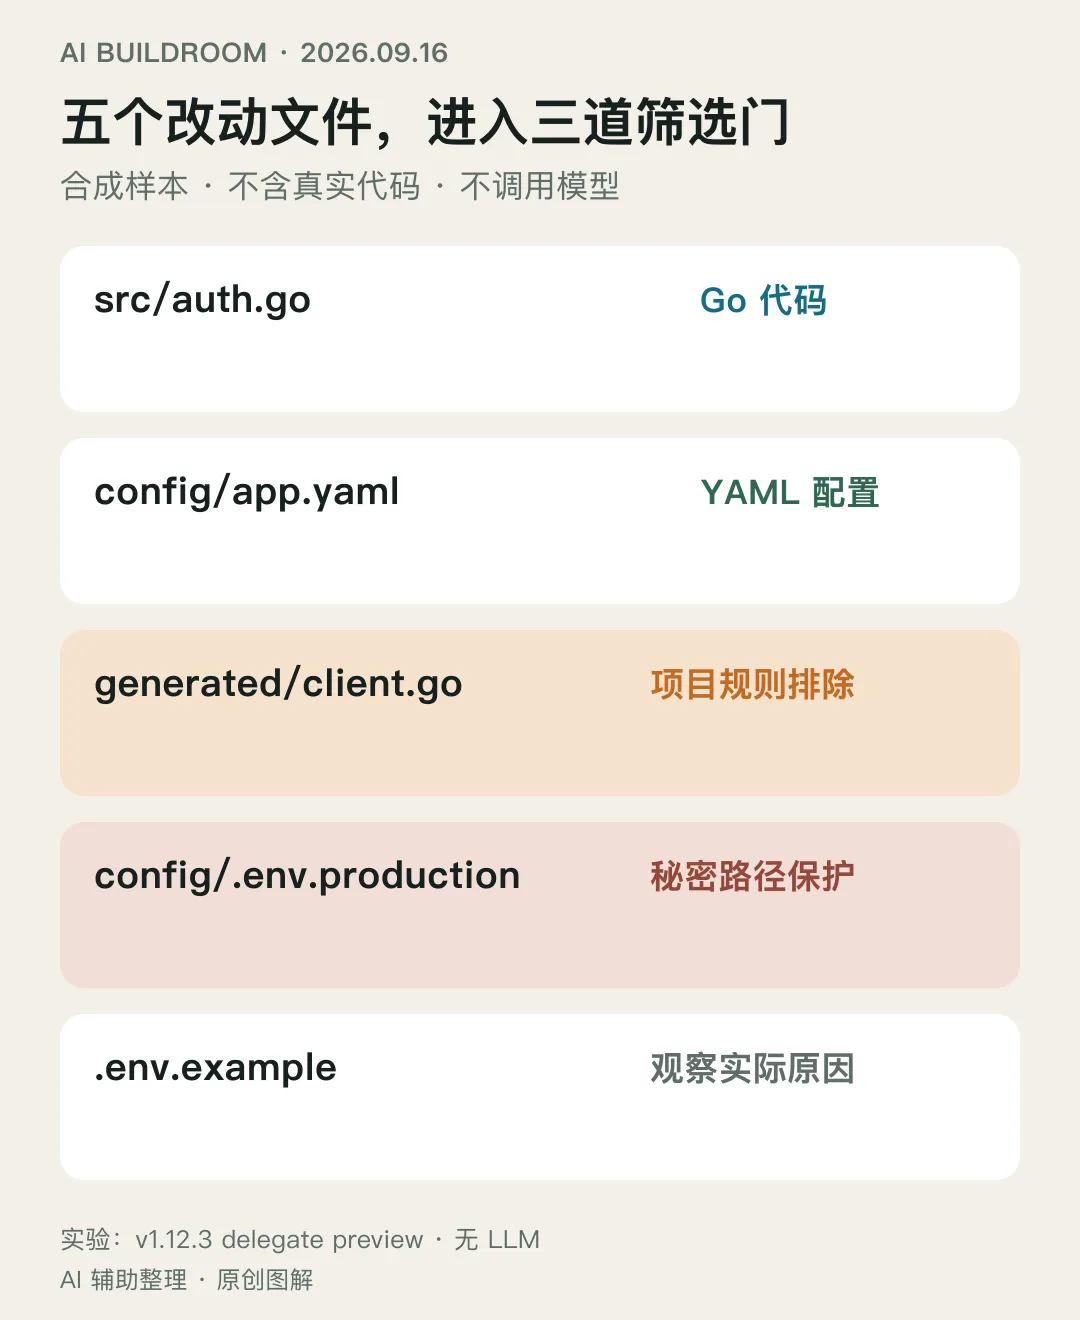
图:合成样本只验证范围和规则,不测模型质量。
实际结果
5 个文件中,只有 src/auth.go 和 config/app.yaml 进入审查。
config/.env.production 被标记为 secret_exclude;generated/client.go 被项目规则标记为 user_exclude;.env.example 没有进入审查,但原因是扩展名不受支持,而不是敏感路径保护。
规则解析同样符合配置:Go 文件匹配鉴权与并发检查,YAML 文件匹配生产默认值、密钥引用和 debug 设置检查。
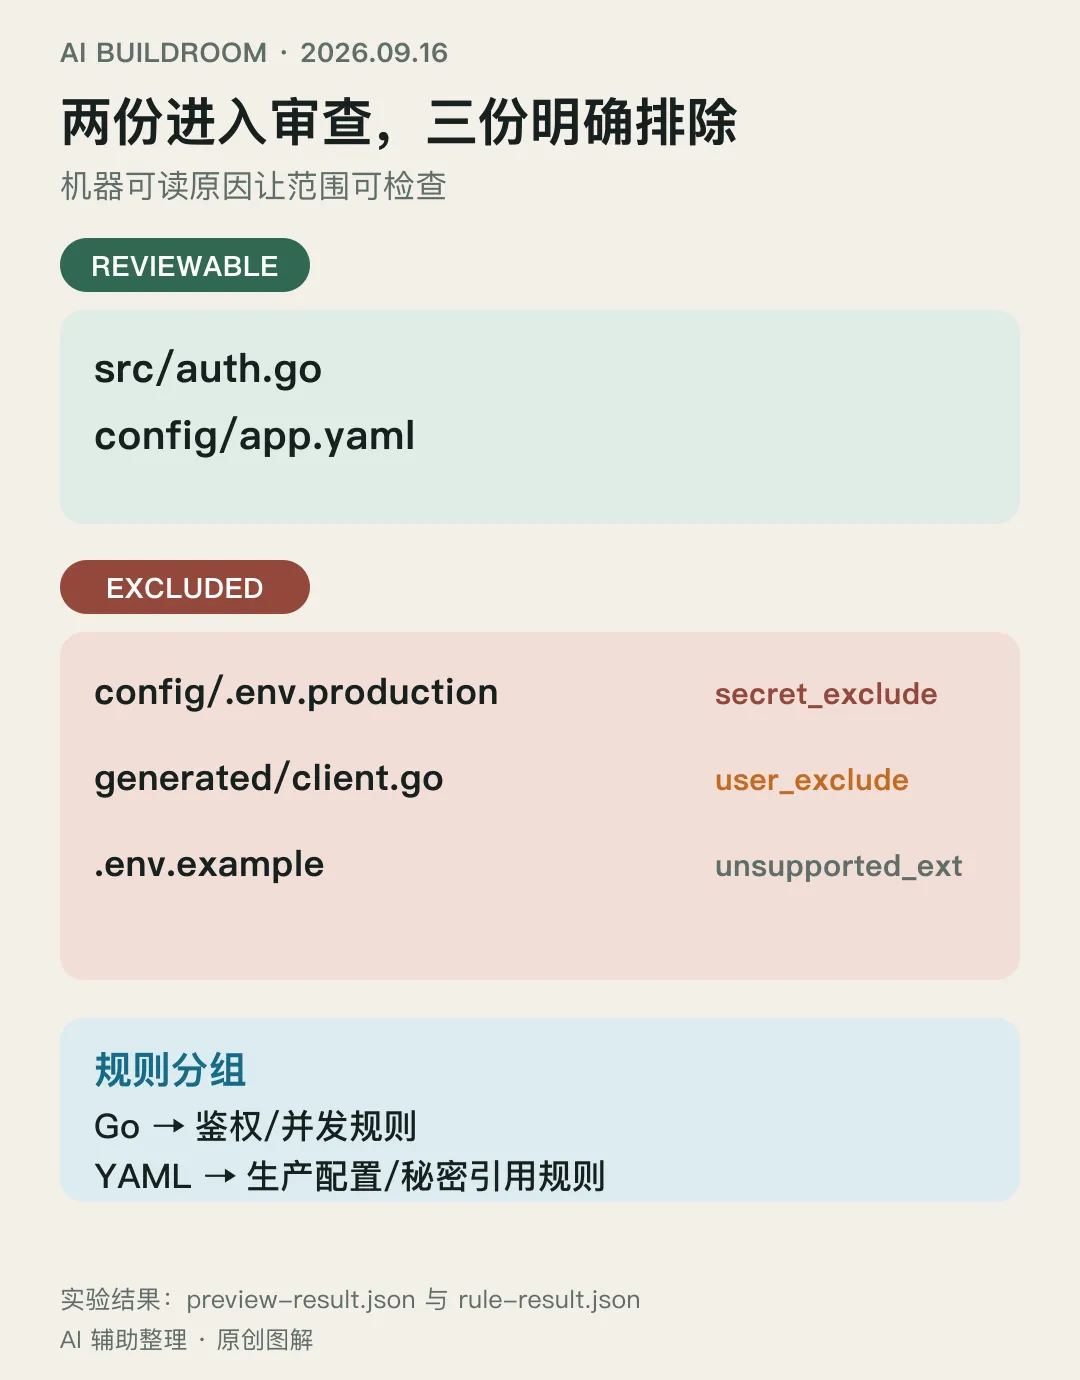
图:每个排除项都有机器可读原因。
这个结果验证了“范围由程序决定”在最小样本上真实存在。它没有验证 LLM 是否能发现我们故意留下的鉴权绕过,也没有验证官方 benchmark。
权限、成本与限制
默认模式会把 diff 和按需读取的上下文发送到所配置的模型端点。即使委托模式不需要 OCR API Key,宿主 Agent 仍可能把代码交给自己的模型服务。数据是否可外发,必须按团队合同和仓库等级判断。
遥测默认关闭。启用后,官方文档称只导出调用数量、延迟、token 和工具指标,不导出提示词正文;但本地会话记录仍保存在用户目录,开启 raw logging 还会保存原始请求与响应。
今天的 v1.12.3 新增环境 .env.* 与秘密路径保护,并修复代码搜索和评论工具的路径穿越绕过。这体现了维护速度,也提醒我们:此类工具能读取仓库和调用外部模型,必须跟进最新安全版本。
另一个未解决问题来自公开 issue #1295。报告者称,并发组较少时 --max-tokens-budget 可能无法及时生效,曾出现约六倍预算的运行。该问题目前仍为 open,本轮没有模型调用,无法独立复现。
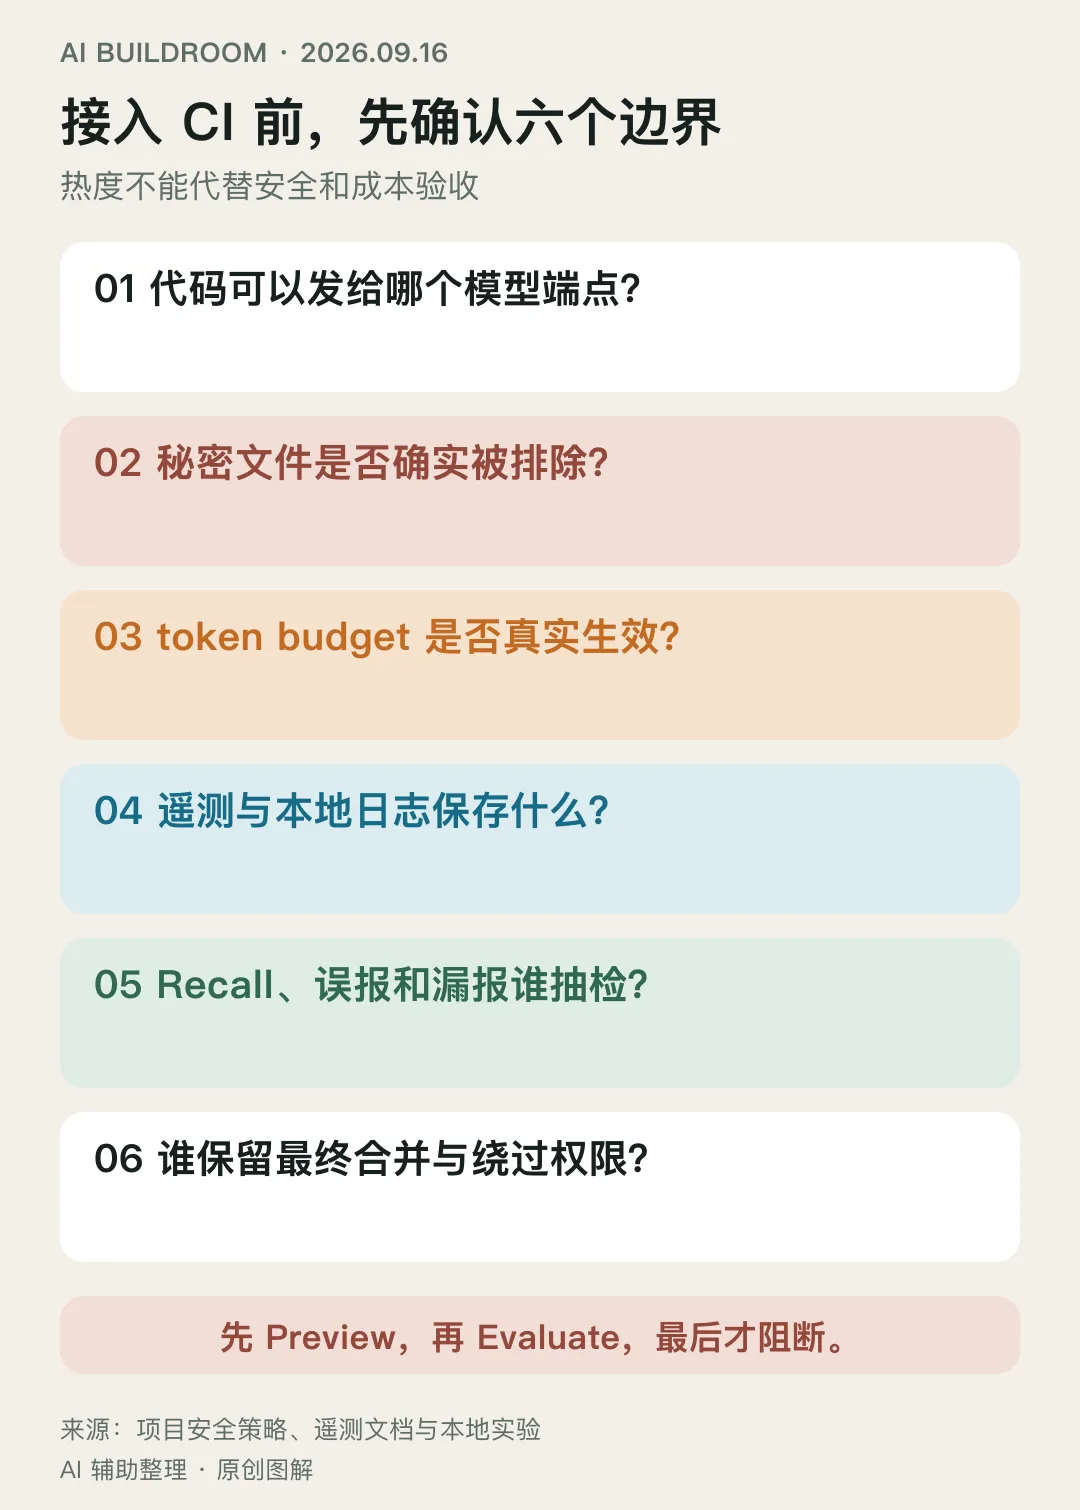
图:先确认数据、权限和停止条件,再进 CI。
替代方案
如果目标是确定性缺陷检测,Semgrep、CodeQL、语言编译器和现有 SAST 更成熟,也不应该被 LLM Review 替代。
如果已经有 Coding Agent,也可以用固定 Skill 做 PR 审查,部署更简单,但需要自己解决文件覆盖、规则路由、评论定位和成本记录。
OpenCodeReview 的优势是把这些工程脚手架做成独立层;代价是多一个需要升级、审计和观测的组件。
结论
今天的热度值得关注,但更值得学的是它的边界设计:文件范围、秘密排除和规则解析交给确定性代码,模型只处理真正需要语义判断的部分。
采用时先在非敏感仓库跑 Preview,再抽样核对排除原因、Recall、误报率和 token 上限。确认稳定后进入 CI 的 Evaluate 阶段,最后才考虑阻断合并。
来源
• GitHub Daily Trending,9 月 16 日页面快照。 • alibaba/open-code-review 仓库与 README,Apache-2.0。 • v1.12.3 发布说明,9 月 16 日。 • 委托模式文档、遥测文档。 • token budget 未执行问题 #1295,写作日仍为 open。
把这份 AI Code Review 接入清单保存下来,下一次接入代码评审 Agent 时逐项核对。