ARTICLE · 1022346
多agent协同完成WUJIAN100文档整理工作
多agent协同完成WUJIAN100文档整理工作

4.4 CCB
工作流复盘:从 User Guide + RTL 提取 wujian100_open SoC 模块分析(2026-09-16)
范围:在
/home/IC_verify/project/wujian100_uvm项目下,从wujian100_open/doc/wujian100_open Userguide v1.0.docx与wujian100_open/soc/*.v中提取 8 个模块(System Overview / TIM / DMA / USI / WDT / PWM / RTC / GPIO)信息,产出 8 份中文分析文档及配套比对脚本。
1. 任务背景与目标
• 输入:1 份 docx(27 章,含大量寄存器表);约 30 个 Verilog 源文件;项目内 CCB 多 agent 分工规则( doc-write写文档、doc_review审文档、main协调)。• 目标:每模块产出一份统一结构的 markdown 分析文档(概述 / 结构 / 端口 / 寄存器配置 / 工作流程 / Spec-RTL 差异 / 信息来源 / 自检),共 8 份。 • 约束:只读不改任何代码;寄存器信息以 User Guide 为准;RTL 作结构证据;每份文档附自检结论。
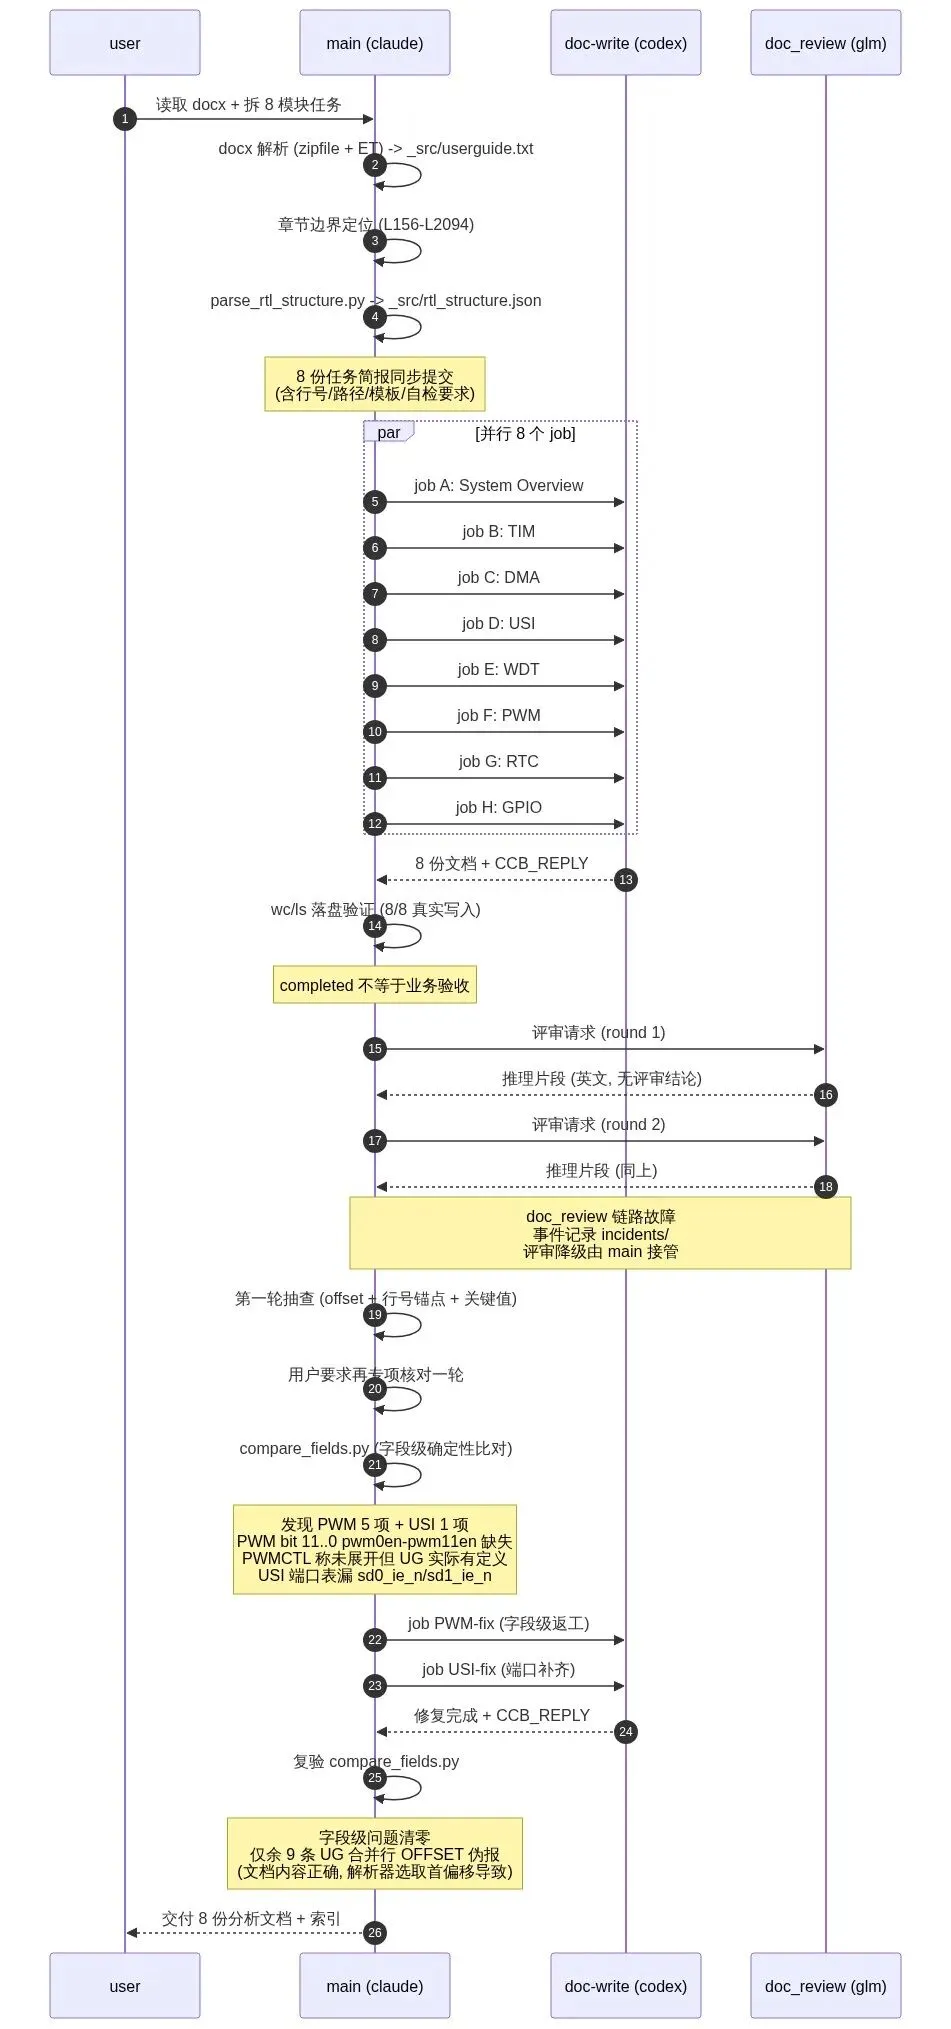
2. 整体工作流
3. CCB 多 agent 协作过程
关键事件:
• 并行委派:8 个 doc-write job 同步提交,被全部接受( accepted),无拒收。• 落盘验证:8 份文档均通过 wc -l+ls确认真实落盘。• doc_review 链路故障:glm-5.3 两次返回英文推理片段( completed但无业务交付),事件已记录至.ccb/incidents/doc_review-reasoning-fragment-replies-20260916.md。• 降级接管:评审降级为 main 抽查 + 确定性脚本比对。
4. 关键技术经验(现象 → 根因 → 规则)
4.1 XML 解析不用正则
• 现象:初版用正则 <w:t[^>]*>提取 docx 文本,结果<w:tbl>被部分截获,表格 XML 泄漏进 userguide.txt,导致下游表格解析失败。• 根因:正则 <w:t会匹配<w:tab>、<w:tbl>等所有以w:t开头的标签,是经典 XML/正则误用。• 规则:解析 XML 一律走 ElementTree/lxml/zipfile + ElementTree;正则只用于非嵌套纯文本。
4.2 自动提取工具输出必须抽查
• 现象: parse_rtl_structure.py输出_src/rtl_structure.json中 33 个文件,模块名 /_define/ FSM 提取成功,但仅 4 个文件端口非空(E902/dmac/pwm/rtc 等ports: [])。• 根因:自动工具对参数化端口数组、跨多行声明、 output wire [W-1:0]这类形态识别不全。• 规则:自动提取工具的输出必须人工抽查;缺失字段改为直接读 RTL module ... ;声明补齐(grep -n "^module\|input\|output"即可)。
4.3 LLM 产出文档不能只信自检声明
• 现象:PWM 文档自检声明 "54 个 _OFFSET",实际 RTL 53 个;PWMCFG 字段表只到 bit[12],注释写"其余 bit 用户指南仅写 Reserved",实际 UG Table 6-1 完整定义 bit[11:0] =pwm0en~pwm11en;PWMCTL 称"spec 未展开",实际 UG Table 6-14 定义了 12 个字段。• 根因:LLM 在缺资料时会"合理化"输出——用 Reserved掩盖未知字段,或声称"spec 未展开"逃避核对。• 规则:必须用确定性脚本( compare_fields.py)做字段级回归;自检声明只能作为线索,不能作为结论。
4.4 CCB completed ≠ 业务验收
• 现象:doc_review 两次 completed但返回英文推理片段;8 份 doc-write 全部completed且均真实落盘(前者无交付,后者有交付)。• 根因:CCB 任务 completed仅代表 provider 进程正常结束,不代表业务内容合格。• 规则:每次收到 CCB_REPLY 必须做内容验证( wc/ls/grep),把验证脚本嵌进 main 侧而非依赖外部信号。
4.5 委派简报的完备性决定产出质量
• 现象:8 份文档首轮交付即结构统一(8 节模板)、行号与 UG 对齐、RTL 引用到位、自检结论齐全。 • 根因:每份简报统一含 6 项——目标 / 输入文件+行范围 / RTL 文件清单 / 交叉参考文档 / 输出路径 / 自检要求(含"寄存器数量 + offset 核对"等硬性 checklist)。 • 规则:并行委派前先把简报"模板化 + 完整化",把每模块差异(行范围、RTL 文件清单)参数化,避免 doc-write 自行解读。
4.6 spec 文本不规则性是自动化比对的主要噪声
• 现象: compare_fields.py迭代修复了 7 类解析器问题:1. doc 内存映射表 "Width (bits)" 表头被误判为字段表 2. 寄存器名带空格(如 Timer2 Control Reg)导致标题正则失配3. bit 域带反引号( \31:16``)正则未剥引号4. DMA 字段表 3 列表头( | bits | R/W | Describe |)但数据行 4 列(含 name)5. 复位值 32'h0000_FFFF下划线未规范化6. 复位值提取需按出现位置取最先匹配(避免把描述末尾 2'b10误当复位值)7. UG 合并行( PWM01LOAD PWM23LOAD PWM45LOAD | 0x38 0x3c 0x40)产生 OFFSET 伪报• 根因:UG 文档本身是 Word 输出 + 人工校对,多处不统一;解析器必须按形态分类处理。 • 规则:自动化比对脚本要支持"形态分类 + 多分支解析 + 容错跳过 Reserved",并把已知伪报显式列入文档(如 PWM45LOAD OFFSET)。
4.7 降级接管与事件记录机制保证协作链可恢复
• 现象:doc_review 链路故障后,main 直接接管评审职责,未阻塞后续流程;事件记录 .ccb/incidents/doc_review-reasoning-fragment-replies-20260916.md留下审计痕迹。• 根因:CCB 协作天然存在单点失败(provider 故障 / 模型退化 / 网络),必须有降级路径。 • 规则:每条 CCB 链路必须有 main 侧的降级方案;故障事件必须落到 .ccb/incidents/而非仅口头记录,便于后续 agent 上下文恢复。
5. 数据汇总
5.1 模块文档统计
sd0_ie_n/sd1_ie_n) | ||||
| 合计 | 3336 | 126 |
5.2 CCB job 列表
5.3 关键抽查值
0x76 | 8'b0111_0110 | ||
0x330 | 10'h330 | ||
_OFFSET 定义数 | grep -c) | ||
0x4C | pwm45count_OFFSET=0x4C |
5.4 Agent LLM 调用与 Token 消耗
数据来源:CCB provider 会话日志(codex rollout 的 token_count 事件 / claude session 的 usage 字段),范围 2026-09-16 本次工作。
| 合计 | 461 | ≈ 44.6M |
任务分摊:
• doc-write:12 个 task(8 份模块文档 + 2 修复 + 1 总结文档 + 1 数据修正)。 • doc_review:2 个评审任务,但各被执行 2 次(两个会话 rollout 各含两个 job id,CCB 会话回收后重投递);38 次调用零有效交付,属沉没成本。 • main:覆盖 docx 提取、14 次 ask 委派、落盘验证、比对脚本迭代、字段级核对与复验; cache_read占 93%。
观察:
1. doc-write 缓存命中率 96.5%,重复读大文件场景成本优势明显。 2. doc_review 1.09M tokens 零交付,印证 incidents/中记录的链路故障,且重投递机制放大了浪费。3. main 的高调用次数主要来自比对脚本迭代与逐模块核对,若外部评审链路恢复可部分卸载。
6. 可复用资产清单
doc_summary/module_analysis/_src/userguide.txt | ||
doc_summary/module_analysis/_src/rtl_structure.json | _define / FSM 可用;端口字段 4/33 完整,需手动补齐 | |
doc_summary/module_analysis/_src/compare_fields.py | ||
doc_summary/module_analysis/README.md | ||
doc_summary/{Module}_registers.md | ||
.ccb/incidents/doc_review-reasoning-fragment-replies-20260916.md |
compare_fields.py 已知伪报模式(无需再"修复",已在文档中说明):
• OFFSET PWM45LOAD/COUNT/CMP/DB等 9 条:UG 合并行被解析器选首偏移• doc 寄存器的"merged-row stub"(如 #### PWM01LOAD / PWM23LOAD / PWM45LOAD)被脚本认作首寄存器,后续同源表格内容会泄漏到cur—— 已在文档侧改写为单名正则兼容形式
7. 后续建议
1. 字段级比对纳入文档 CI:把 compare_fields.py接到 git pre-commit / pre-push,任何模块文档改动自动跑比对,零差异才允许合并。2. doc_review 链路恢复后再启用外部评审:该链路已于 2026-09-16 当日切换 API 恢复;恢复后首个任务应先以小型冒烟任务验证回复含实质结论,再恢复正常委派。仍保留"评审不应长期依赖 main 降级"的观点(main 的注意力是单点瓶颈)。 3. parse_rtl_structure.py端口提取能力补强:当前 33 文件仅 4 文件端口完整,需要扩展对参数化端口数组、跨多行声明的支持。4. UG 文本规范化:建议给原始 docx 加一份"机器可读版本",把合并行拆开、3 列异形表补齐、复位值统一为 0x...,将显著降低比对脚本复杂度。5. 简报模板版本化:把 §3 中的 8 字段简报模板抽到 .claude/templates/doc-write-brief.md,下次类似任务直接套用。