ARTICLE · 1024594
OpenAI 的 Agent 软件工厂:用 9 个环节把 Codex 接入生产闭环
摘要:Codex 在 OpenAI 内部已进入写代码、测试、审阅、部署、监控和事故响应。拆开这套 9 环节软件工厂,真正的变化是:代码生成加速后,验证、风险分层和生产反馈成了新的工程主线。
本文基于 Gergely Orosz 对 OpenAI 工程团队的采访公开内容编译,并结合 OpenAI 官方数据与相关工程实践进行核查和重组。
过去一年,OpenAI 内部发生了一次很安静的迁移。
Codex 最初是工程师的编程工具,后来进入法务、财务、招聘和市场等团队。它处理的任务也从改一段代码,扩展到研究、文档、表格、演示文稿和内部流程。
更大的变化藏在研发流程里。Codex 已经开始收集上下文、实现变更、运行测试、参与代码审阅、跟踪发布、观察生产指标,并在事故发生时协助响应。
代码生成只是入口。OpenAI 正在把研发流程改造成一套由 Agent 持续运转、由人守住关键关卡的软件工厂。
Codex 为什么突然进入了所有部门
2026 年 9 月,The Pragmatic Engineer 作者 Gergely Orosz 发布了对 OpenAI 内部研发方式的深度调查。他采访了 Applied Infra、ChatGPT、Codex、Productivity 和 Responses API 等团队的 7 位负责人和工程师。
文章提到,OpenAI 的非工程团队在数月内快速迁移到 Codex 和 ChatGPT Work。OpenAI 自己公布的数据,也能看到同一条曲线。
2025 年 8 月,员工在 Codex 上消耗的 token 平均占比还不到 10%。到 2026 年 6 月,Codex 已成为各部门主要使用的 AI 工具。OpenAI 每周生成的内部输出 token 中,99.8% 来自 Codex。
这个比例不代表「99.8% 的工作已经自动完成」。更准确的理解是:OpenAI 内部的 AI 交互,正在从一次问答迁移到持续执行的 Agent 任务。
Codex 处理长任务时,本来就比聊天工具消耗更多 token,所以这个比例容易被误读。
长时间运行是其中一项关键变化。OpenAI 对个人用户的抽样估算显示,2026 年 5 月,70.2% 的用户至少发起过一次相当于人工工作一小时以上的 Codex 请求;25.6% 的用户至少发起过一次八小时以上的请求。
它说明了一件事:用户交给 Agent 的任务正在变长。
这些时长由模型结合运行记录估算,样本只覆盖随机抽取的 0.1% 个人用户,适合观察方向,不适合当作精确工时。
原文把 OpenAI 内部的快速采用归结为几项共同作用。
首先是持续目标。用户可以给 Codex 设置一个目标,让它围绕完成状态持续推进,而非每走一步都等人发下一条消息。
其次是团队专属插件和 Skills。一个「什么都能做」的 Agent,如果只有空白输入框,员工仍要自己摸索工作方法。团队把高频流程、领域规则和数据入口封装起来,Agent 才真正长进岗位里。
最后是内部上下文。OpenAI 的 Codex 可以访问代码仓库、GitHub、Slack、Notion、Databricks、Datadog、内部日志和文档。公司还把更多文档放到代码附近,降低 Agent 找资料、判断版本和理解约束的成本。
模型提供通用能力,组织上下文决定它能不能在真实工作里持续交付。
代码变快后,瓶颈开始向下游移动
Agent 可以更快地产生代码,构建、测试、审阅和部署不会因此自动提速。
OpenAI 应用基础设施副总裁 Venkat Venkataramani 在采访中表示,部分研发基础设施在大约六个月内承受了约 10 倍负载。
这个数字指向构建、测试和部署系统的压力,不代表整个公司的代码量统一增长了 10 倍。
即便如此,瓶颈转移已经很清楚:更多变更进入版本控制,触发更多 CI(持续集成)任务,再以更高频率逼近生产环境。过去够用两三年的容量,可能几个月就被新的 Agent 能力吃完。
Pull Request(合并请求)和代码审阅也要随之改变。人类逐行阅读所有 Agent 生成的代码,很快会碰到注意力上限。OpenAI 的做法,是让多个具备不同领域上下文的 Agent 分别审阅同一次变更,再按风险决定后续路径。
低风险变更可以走较轻的流程,部分代码区域甚至允许 Agent 自动批准; 高风险变更会触发更多专业审阅,例如基础设施、安全或合规检查; 影响较大的变更,在 Agent 完成检查后仍要交给人批准。
这里的关键不在于给 Agent 换一个「安全专家」角色名。专业审阅能否提供增量价值,取决于它能访问什么代码、文档和历史规则,以及它是否只把有限的上下文窗口用在一个明确领域。
移动应用暴露了更难扩容的环节。后端和 Web 流水线可以加机器、改调度,原生 iOS 和 Android 更新仍要经过应用商店审核。代码也许几分钟就能写完,进入用户手机却可能等待数小时或数天。
当局部速度突然提升,系统不会整体变快。等待时间会集中到最难并行、最难自动化的那一段。
9 个环节,实际组成三段闭环
原文把 OpenAI 的 Agent 软件工厂拆成 9 个环节。逐项看很长,按反馈方向整理后,可以归为三段:实现闭环、交付闭环和生产闭环。
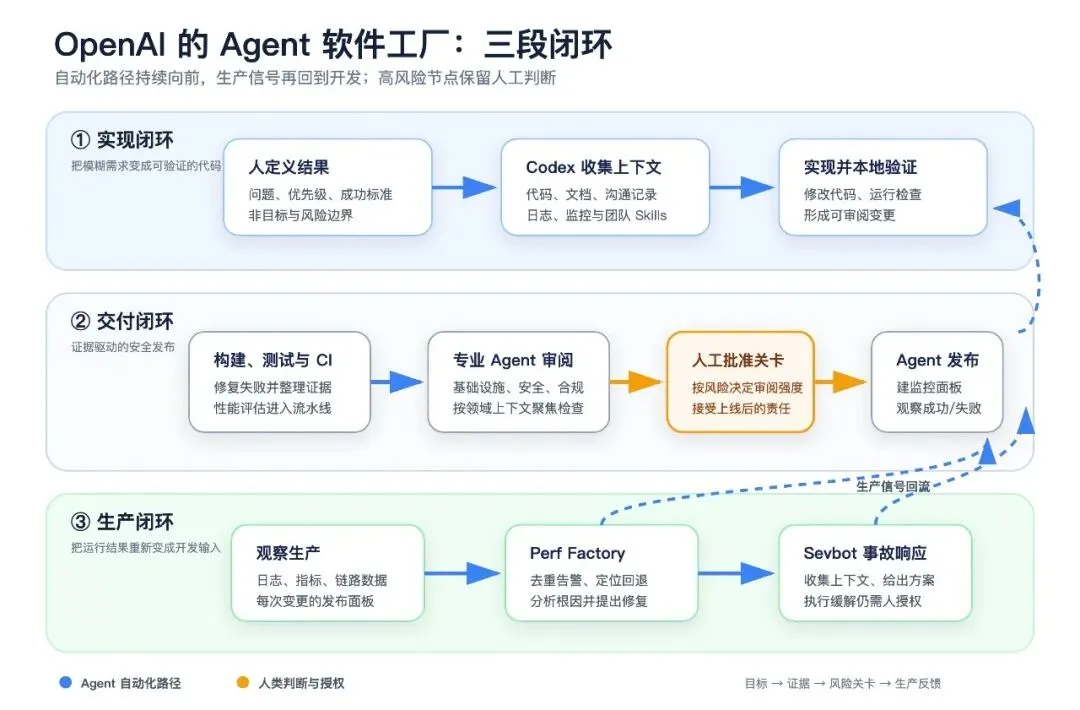
▲ 根据 Gergely Orosz 公开文章中的 9 个环节重新绘制。蓝色表示 Agent 自动化路径,橙色表示需要人类判断或授权的关卡。
第一段:从目标到可验证的代码
人先定义想要的结果。软件工程师或产品经理说明问题、成功标准和优先级,Codex 再去收集完成任务所需的上下文。
在 OpenAI 内部,这些上下文覆盖代码仓库、沟通记录、监控数据、内部日志和团队 Skills。新员工入职时,也会被建议先向 Codex 查询内部问题,因为它能检索到相当多的组织知识。
上下文齐全后,Codex 实现变更并在本地验证。写代码在这里反而是最短的一步。结果取决于目标有没有说清、资料是否可用、完成状态能否被检查。
这也解释了为什么 OpenAI 的内部使用效果不能直接复制到外部产品。公开版 Codex 再强,如果看不到公司的私有系统、约束和历史决策,能够承担的责任范围仍然不同。
第二段:从测试到安全发布
Agent 完成代码后,会运行构建和测试,修复失败,再创建 Pull Request。更完整的 CI 会继续执行代码检查、测试套件和性能评估。
接着,多名专业 Agent 从不同角度审阅。风险分类决定变更要经过多少检查,以及是否必须由人确认。发现问题后,编码 Agent 继续跟进评论并更新代码,直到证据满足要求。
发布阶段也有自己的 Agent。它会读代码、找到功能开关、理解本次变更,判断哪些指标能说明成功或失败,并为这次发布创建监控面板。OpenAI 的长期设想,是给每次变更配一个近似「自主 SRE(站点可靠性工程师)」的 Agent,让它一直守到变更安全完成。
这里仍有一道明确的人类关卡:公开描述中,变更进入生产前需要人批准。自动化负责准备证据、扩大观察范围,人负责接受上线后果。
第三段:让生产环境把问题送回来
传统流水线常在「部署成功」处结束。OpenAI 的软件工厂继续往下走。
生产环境里的日志、指标、链路数据和发布面板会持续回流。Perf Factory 负责筛选告警、合并重复信号、确认真实的延迟回退、分析根因并提出修复。监控由此变成下一轮开发的输入。
事故响应也接入 Codex。内部工具 Sevbot 会在事故发生时收集上下文、给出可能的缓解方案,并留在 Slack 频道里回答工程师的问题。
边界同样清楚:按照原文公开描述,Sevbot 当前不会自行执行缓解措施。工程师可以指定它采取某个动作,OpenAI 的长期目标才是让它在一部分常规事故中获得更高自主性。
这条边界很重要。事故处理涉及生产权限和真实用户,能提出方案与能自行执行,代表完全不同的风险等级。
人的判断被推到了新的位置
把三个闭环放在一起,会看到人的工作位置正在变化。
人不必亲手完成每一步执行,却仍要定义结果、设定质量门槛、判断风险、批准高影响变更,并在证据互相矛盾时做取舍。
Addy Osmani 在另一篇软件工厂文章中提出了一个很实用的警告:机器并发可以继续扩容,人的认知带宽不会。团队如果只扩大代码产量,没有同步改善证据、交接和理解,最终会积累「理解债务」。代码已经进入系统,维护者却说不清它为什么这样工作。
所以,衡量软件工厂不能只看 Pull Request 数量。更有意义的问题包括:
有多少变更因为证据不足被拦下? 人工审阅是否持续积压? 同类失败能否自动回到任务队列? 回滚一次变更需要多少时间? 维护者能否解释高风险模块的关键决策?
工厂提高的是执行吞吐量。系统能否安全地吸收这些产出,取决于验证能力和责任边界。
普通团队别急着复制 OpenAI 的规模
OpenAI 的方案建立在一个特殊前提上:Codex 能访问大量内部系统,公司也有足够的工程资源重做 CI/CD、监控和事故响应。多数团队没有必要从九个环节一次性起步。
更现实的路线,是按瓶颈逐步补齐五种能力。
1. 先把任务变成可检查的契约
每项任务至少写清四件事:期望结果、非目标、禁止修改的区域,以及验收条件。目标只有一句「把这里优化一下」,Agent 跑得越久,偏航成本越高。
2. 让上下文靠近工作现场
把仓库说明、架构约束、常用命令和关键决策放到 Agent 能稳定找到的位置。文档一旦过期,给 Agent 的上下文越多,它反而错得越有底气。
3. 要求代码之外的交付证据
一次完成应同时带回构建结果、测试结果、已知风险、未执行的检查和待人决定的问题。绿色勾选只说明命令成功,不能自动证明产品意图已经满足。
4. 用风险决定自主性
文案、小范围样式和低影响重构,可以尝试更轻的审阅。认证、计费、数据迁移、权限和生产配置,应保留更严格的人工批准与回滚方案。
自主性不该是全局开关。它应该随着任务类型、证据质量和历史成功率变化。
5. 最后再补生产反馈
当部署频率上升,监控问题却停在仪表盘或聊天群里,团队才需要把告警去重、根因分析和修复任务接回开发队列。
如果单个 Agent 仍经常误解需求,先改善规格和验证。只有当任务能够稳定完成,外部工作又持续进入队列,并开始出现重复领取、上下文丢失和审阅积压时,软件工厂才真正有价值。
工程师的稀缺能力正在换位置
OpenAI 受访者观察到,工程师的部分专业边界正在变淡。过去需要专门团队投入数周的迁移或重写,现在可能由一两名工程师协调 Agent 完成。
这仍然是 OpenAI 内部的观察,不能直接外推为所有公司的岗位趋势。
这个观察指出了几项越来越重要的能力:
把模糊需求变成可验证目标; 为 Agent 准备足够、不过期的上下文; 设计能抓住真实错误的检查; 根据影响范围调整权限和人工关卡; 对进入生产的结果保持系统所有权。
IDE 和 Pull Request 也许会换形态,调试工具可能被通用 Agent 吸收一部分能力。工程工作的核心没有因此缩成「会不会写 prompt」。当代码本身更容易获得,能否提出正确问题、识别薄弱证据并守住生产边界,反而更难被省略。
结语
OpenAI 的实践展示了一条具体路线:从定义目标开始,让 Agent 贯穿实现、验证、审阅、发布、监控和事故响应,再把生产信号送回开发。
这套系统的价值来自一项约束:每一次变更都要带着证据向前走,在风险升高时停下来等人,并在生产环境出现问题后找到回去的路。
软件工厂真正要规模化的,是可验证的交付;代码产量只是副产品。
参考资料
Gergely Orosz:Inside OpenAI’s agentic software factory[1],The Pragmatic Engineer,2026-09-15 OpenAI:智能体如何重塑工作方式[2],2026-06-25 Addy Osmani:Human judgment doesn't leave the software factory. It relocates.[3],2026-08-21
引用链接
[1]Inside OpenAI’s agentic software factory: https://newsletter.pragmaticengineer.com/p/openai-software-factory
[2]智能体如何重塑工作方式: https://openai.com/index/how-agents-are-transforming-work/
[3]Human judgment doesn't leave the software factory. It relocates.: https://addyosmani.com/blog/human-judgment-doesnt-leave-the-software/