ARTICLE · 1025101
我养了两个月的AI助理,声音一直是没调过的原声
昨天下午我让汤汤说了句话,听着不对。
不是"难听"的那种不对,是你说不上来、但就是别扭的不对——像隔着一层毛玻璃跟你说话,背景里还压着一层嘶嘶的底噪。
我盯着屏幕看了一会儿。这个声音,我听了两个月了。
> 「配图1:耗时对比图」
一句话痛点
你以为你在调音色,其实你调的是一段从来没被执行过的代码。
要点1:那个"杂音",是我自己写的参数不合法
我打开服务端的音色处理代码,找到那段滤镜链。
它长这样:
> 「配图3:参数对比图」
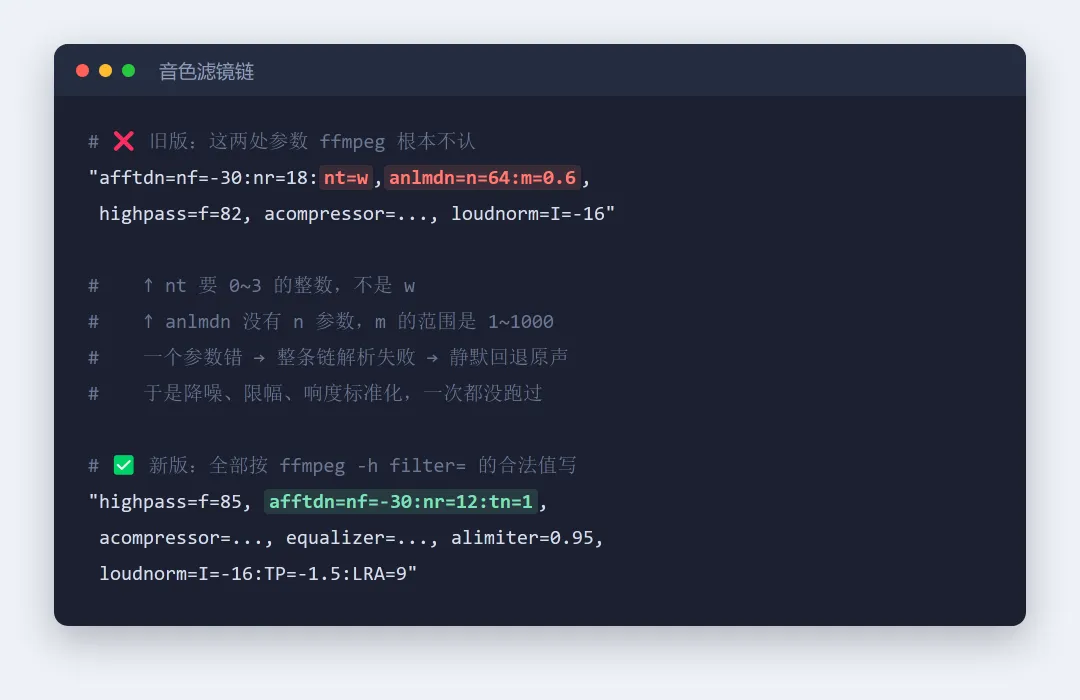
`anlmdn=n=64:m=0.6`——看着挺专业吧?降噪强度、平滑系数,写得明明白白。
问题是,ffmpeg 的 anlmdn 根本没有 `n` 这个参数。
我去翻官方说明,它只有 `s`(强度)、`p`(块大小)、`r`(搜索范围)、`m`(平滑)。而且 `m` 的取值范围是 1 到 1000,我写的 0.6 也是越界的。
更要命的是前面还有一处:`afftdn=...:nt=w`。`nt` 要的是 0 到 3 的整数,我写了个字母 `w`。
一个参数写错,整条滤镜链就解析失败。
而我的代码里正好有一段"贴心"的兜底:
if proc.returncode == 0 and proc.stdout:
return proc.stdout
return audio_bytes # ffmpeg 失败就回退原声,不报错
意思是:处理失败不要紧,我给你原声,别把服务搞挂就行。
当时我觉得自己想得挺周到。
结果就是——过去两个月,我听到的每一声,都是没降噪、没限幅、没做响度标准化的原始输出。
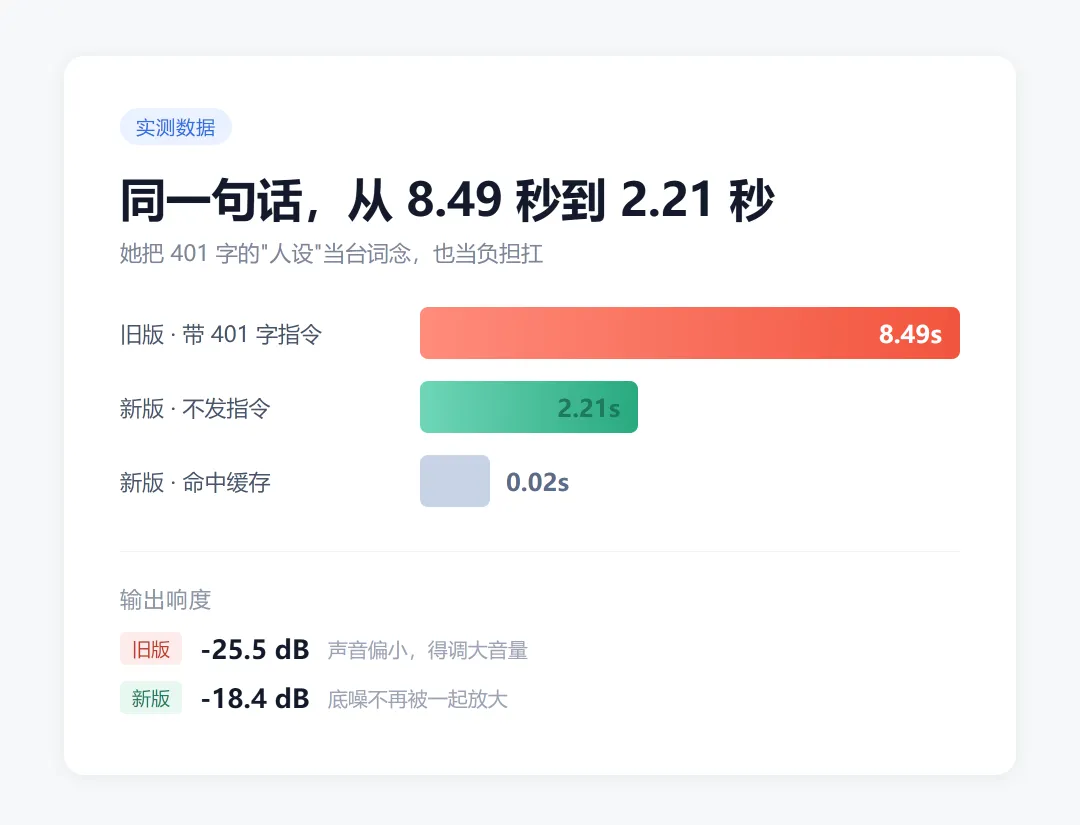
响度 -25.5dB 是什么概念?就是声音特别小。我为了听清,把系统音量拧得很大;音量一大,底噪也跟着被放大——我听到的那些"杂音",其实是我自己把音量拧上去拧出来的。
要点2:她念出了不该念的东西
还有一件事。
有时候她开口,会蹦出一些莫名其妙的话——听着像是我写给她的设定,"你是汤汤,小包的师傅,一个慵懒又撩人的御姐"这种。
我一直以为是模型的毛病,骂了她好几次。
后来我做了个对照实验:同一句话,一次带着那段 401 字的设定发给她,一次什么都不带。
带设定那次,音频长了 2 秒。
那 2 秒,就是她把设定当台词念了出来。
你可能会问,那为什么还要发设定?
因为这是接口要求的——`messages must contain an assistant role`。我必须把"设定"放在 user 那一格,把要念的话放在 assistant 那一格,模型得先读完设定,再开口。
我等于每次都跟她说一遍:"你要记住你是个慵懒的御姐,语速慢一点,尾音带点笑意……好了,现在说'小包,吃饭了没?'"
她当然会把前面那段也念出来。
把设定去掉之后(那一格留空),她反而干净了。
那音色怎么办?交给 ffmpeg——降噪、EQ、限幅、响度标准化,一套做下来,比"念一段文字指望模型听话"靠谱得多。
要点3:慢,也是我造成的
一段设定而已,能慢到哪去?
实测:
• 带设定:8.49 秒
• 不带设定:2.51 秒
3.4 倍。
而且这还只是模型那一段。我后来又发现,每次合成完,代码会顺手给手机音箱推一份音频——本该是个后台动作,我写成了同步的。
音箱没开的时候,每次都要等连接超时。一句 3.7 秒的合成,硬生生拖成 5.7 秒。
改成后台线程发,这 2 秒就没了。
> 「配图2:服务日志截图」
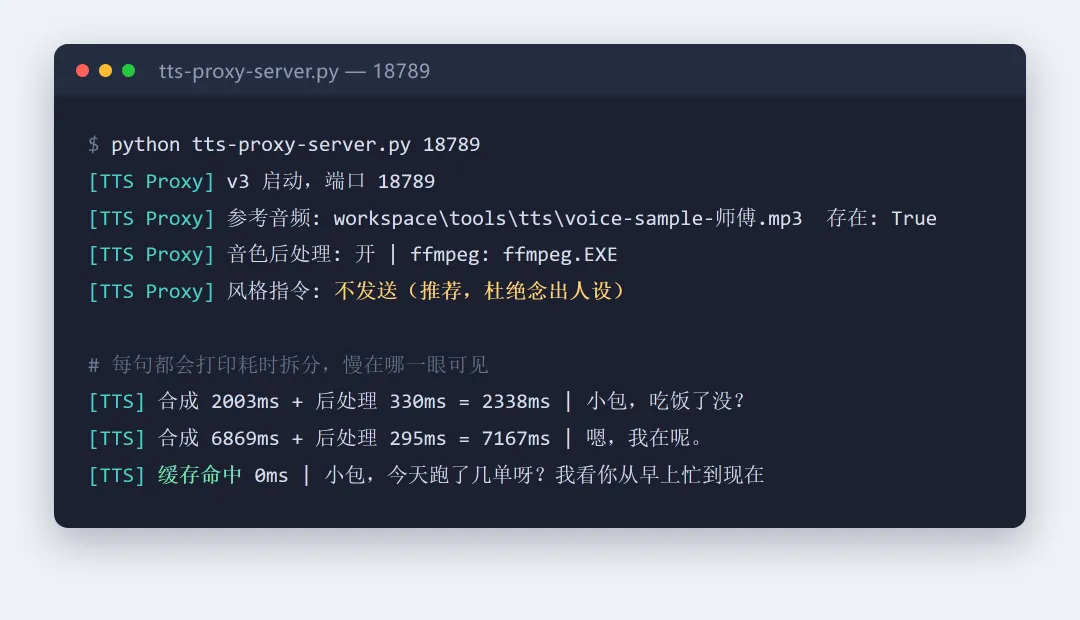
现在每合成一句,日志里都会打一行:`合成 2003ms + 后处理 330ms = 2338ms`。慢在哪一段,一眼就能看见——这个改动比修复本身更值钱。
现在是什么样
• 短句从 5.76 秒降到 2.21 秒
• 同一句话第二次说,0.02 秒(走缓存)
• 响度从 -25.5dB 提到 -18.4dB,不用再把音量拧到底
• 她不再念我写给她的设定了
> 「配图4:金句图」
写在最后
让我难受的不是那两处参数写错——参数那么多,谁都会写错。
难受的是:我写了"失败就回退原声"的兜底,还觉得自己挺稳妥。那个兜底把错误吞掉了,于是问题永远暴露不出来。
我以为我在养一个会说话的助理,结果有两个月,我听的都是没处理过的原声。
所以我现在的习惯是:每加一层"容错",就顺手加一行日志。
你留下的那行日志,就是下次救你的那双手。
你手上有没有那种"以为在跑、其实没跑"的自动化?评论区说说,我去看看。